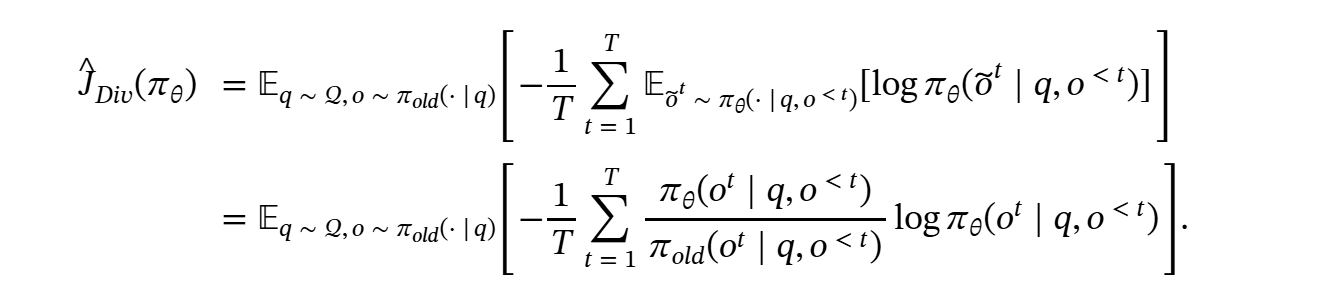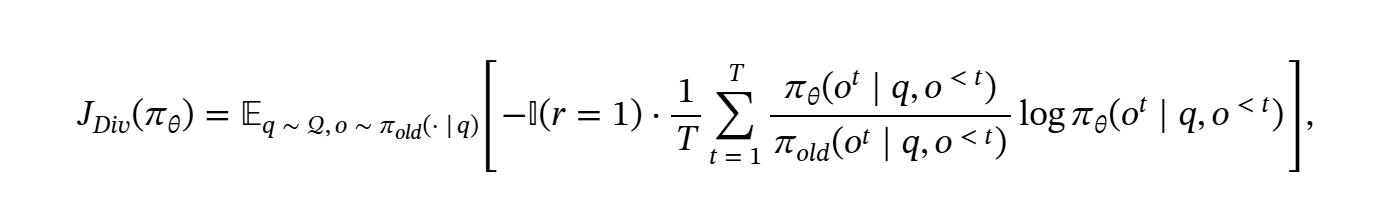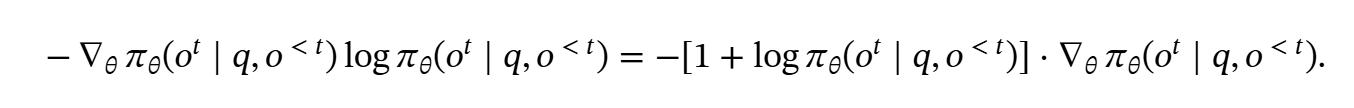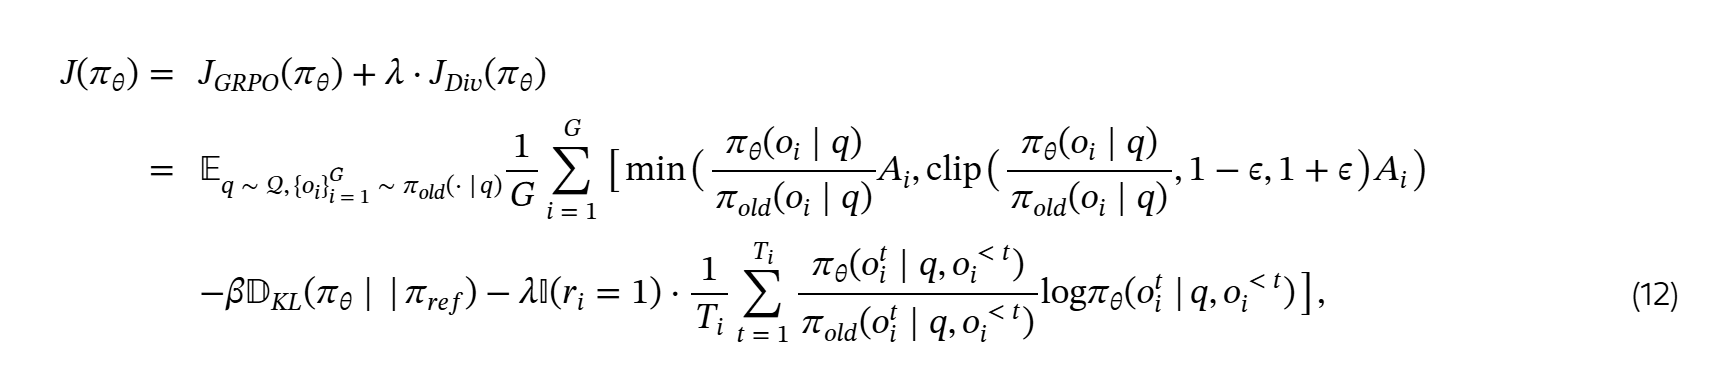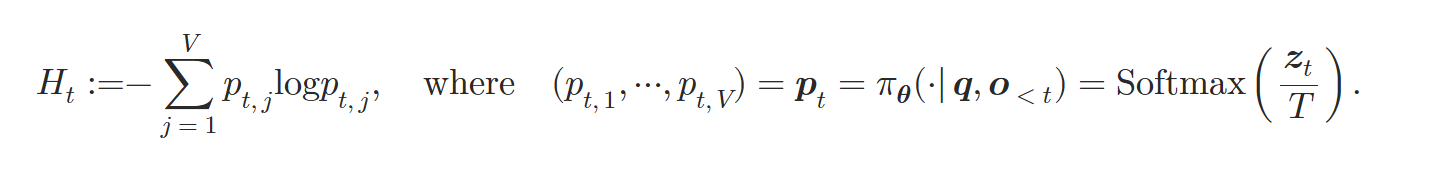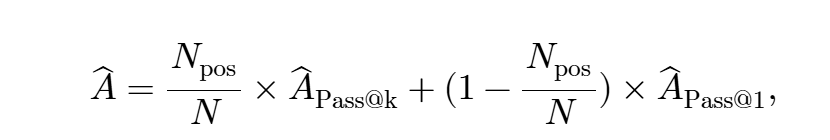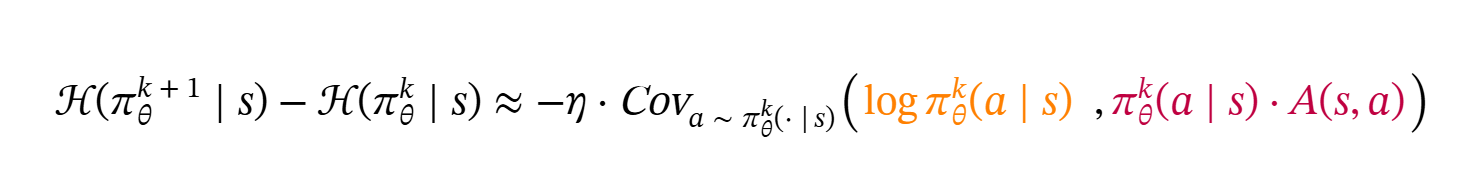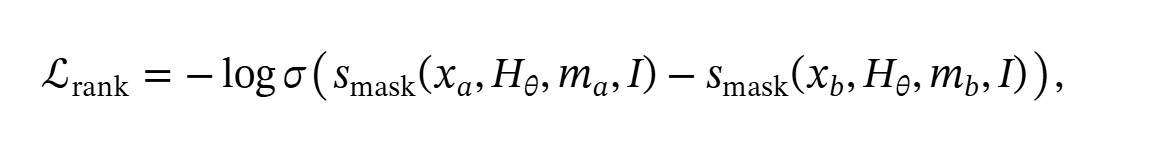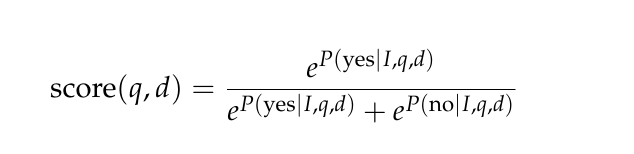SWE-Pruner Pro: Read Its Mind, Not Its Output

· 12 min read
ayanami

引言​

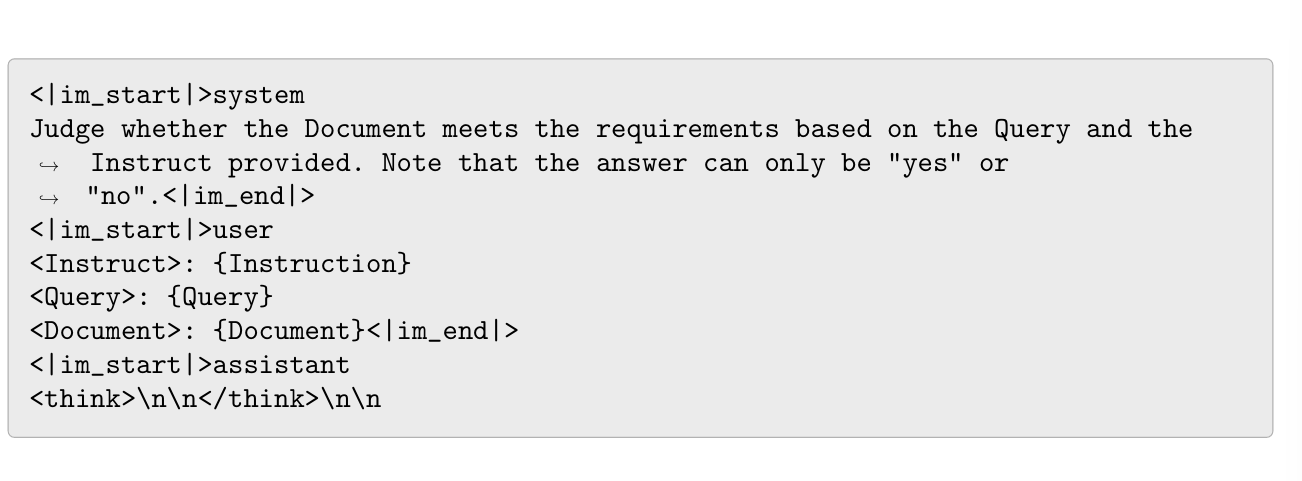
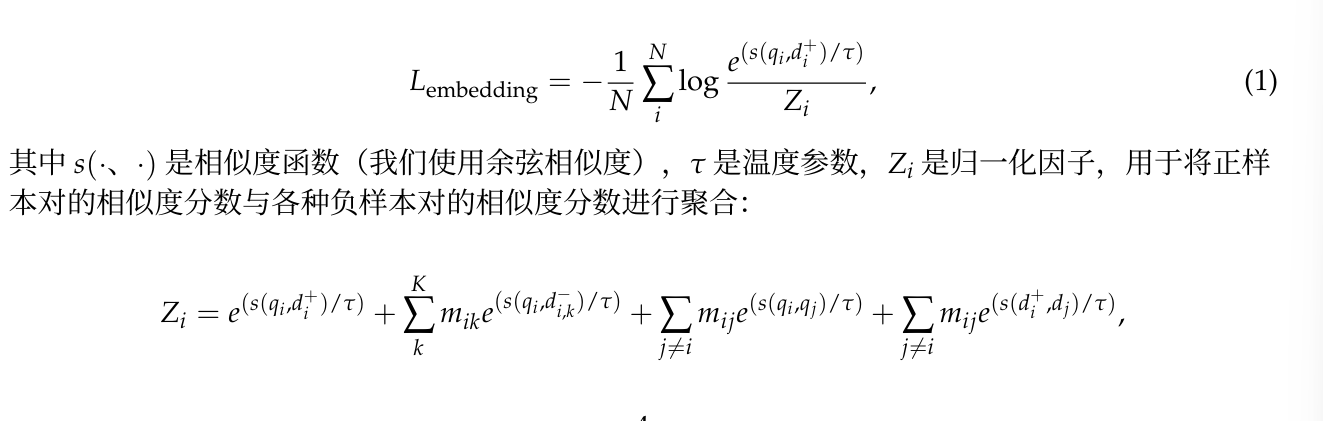
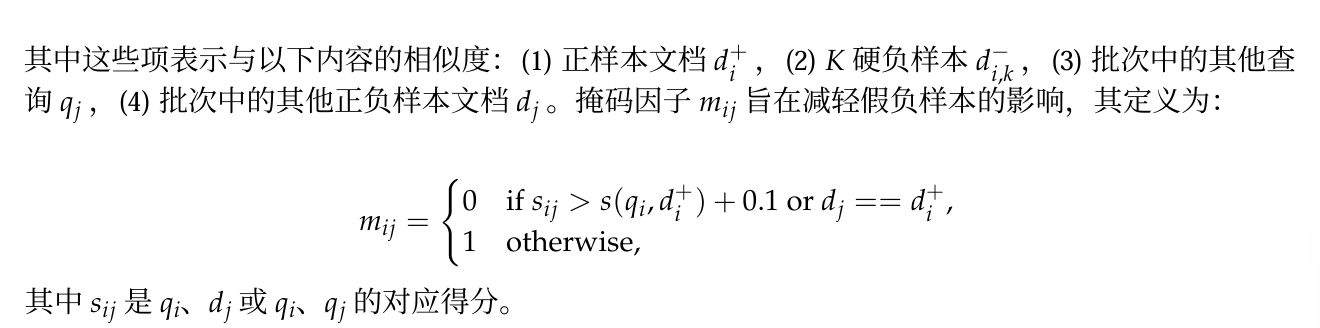
在之前 blog 里,我们分享了 SWE-Pruner —— 一个 0.6B 的代码语义高亮模型,靠 context focus question包装工具输出,在 SWE-Bench / SWE-QA 上把 token 砍掉 30%+ 而几乎不损质量。

开源之后,我们被问到最多的两个问题是:

  1. Engineer常问的是,我如何将SWE-Pruner接入他们已有的工作流?
  2. Researcher常问的是,SWE-Pruner可以和基座一起Scale吗?

对于1, 当我们给出 context focus question 或者原生 Code Execution 的回答之后,有些人想了想,表示可以适配,还有人面露难色,对于工具进行侵入式修改不一定对于所有场景都可行。

对于2,我们当时只能承认,Pruner的Scale能力在于: 更好的标签,更好的基座工具调用能力,但截至我们做Pruner实验的时候,许多次旗舰模型依然无法正确的产出question,而给一个模型可能已经完全“肌肉记忆”的工具加上额外的参数可能是反模型的(例如, 给Bash加question)

受这些社区反馈启发,我们当时产生了一个灵感:

已知:

  1. 外挂一个模型无法解决这些问题
  2. 模型能够产出question,说明模型其实知道它想要保留什么
  3. 已有相当多研究表明,模型的hidden state其实编码了后续多个token的信息

那为什么不把Prune做到基座模型里面去呢?

从这个角度来看,question似乎是绕了个远路,如果模型能够在hidden state里面编码它想要输出什么样的question, 想要什么样的输出,那我们就不需要依赖于模型适用文本输出question,再去修改工具适应一个外部的pruner模型。这本质和Agentic search的困境是一样的, 基座的能力需要向搜索小模型适应这件事情本身就是非常不优雅的。

所以,在经过了数个月的探索之后,我们做了新的SWE Pruner Pro,问题是一个问题,解法是完全不同的解法。

问题​

不再赘述Context Prune的重要性。我个人是认为Prune会是Long Horizon的未来组件的, 并且, 让LLM自己操作history是大势所趋, 而Prune或许是其中最简单,最可验证的一步。

架构设计​

image.png

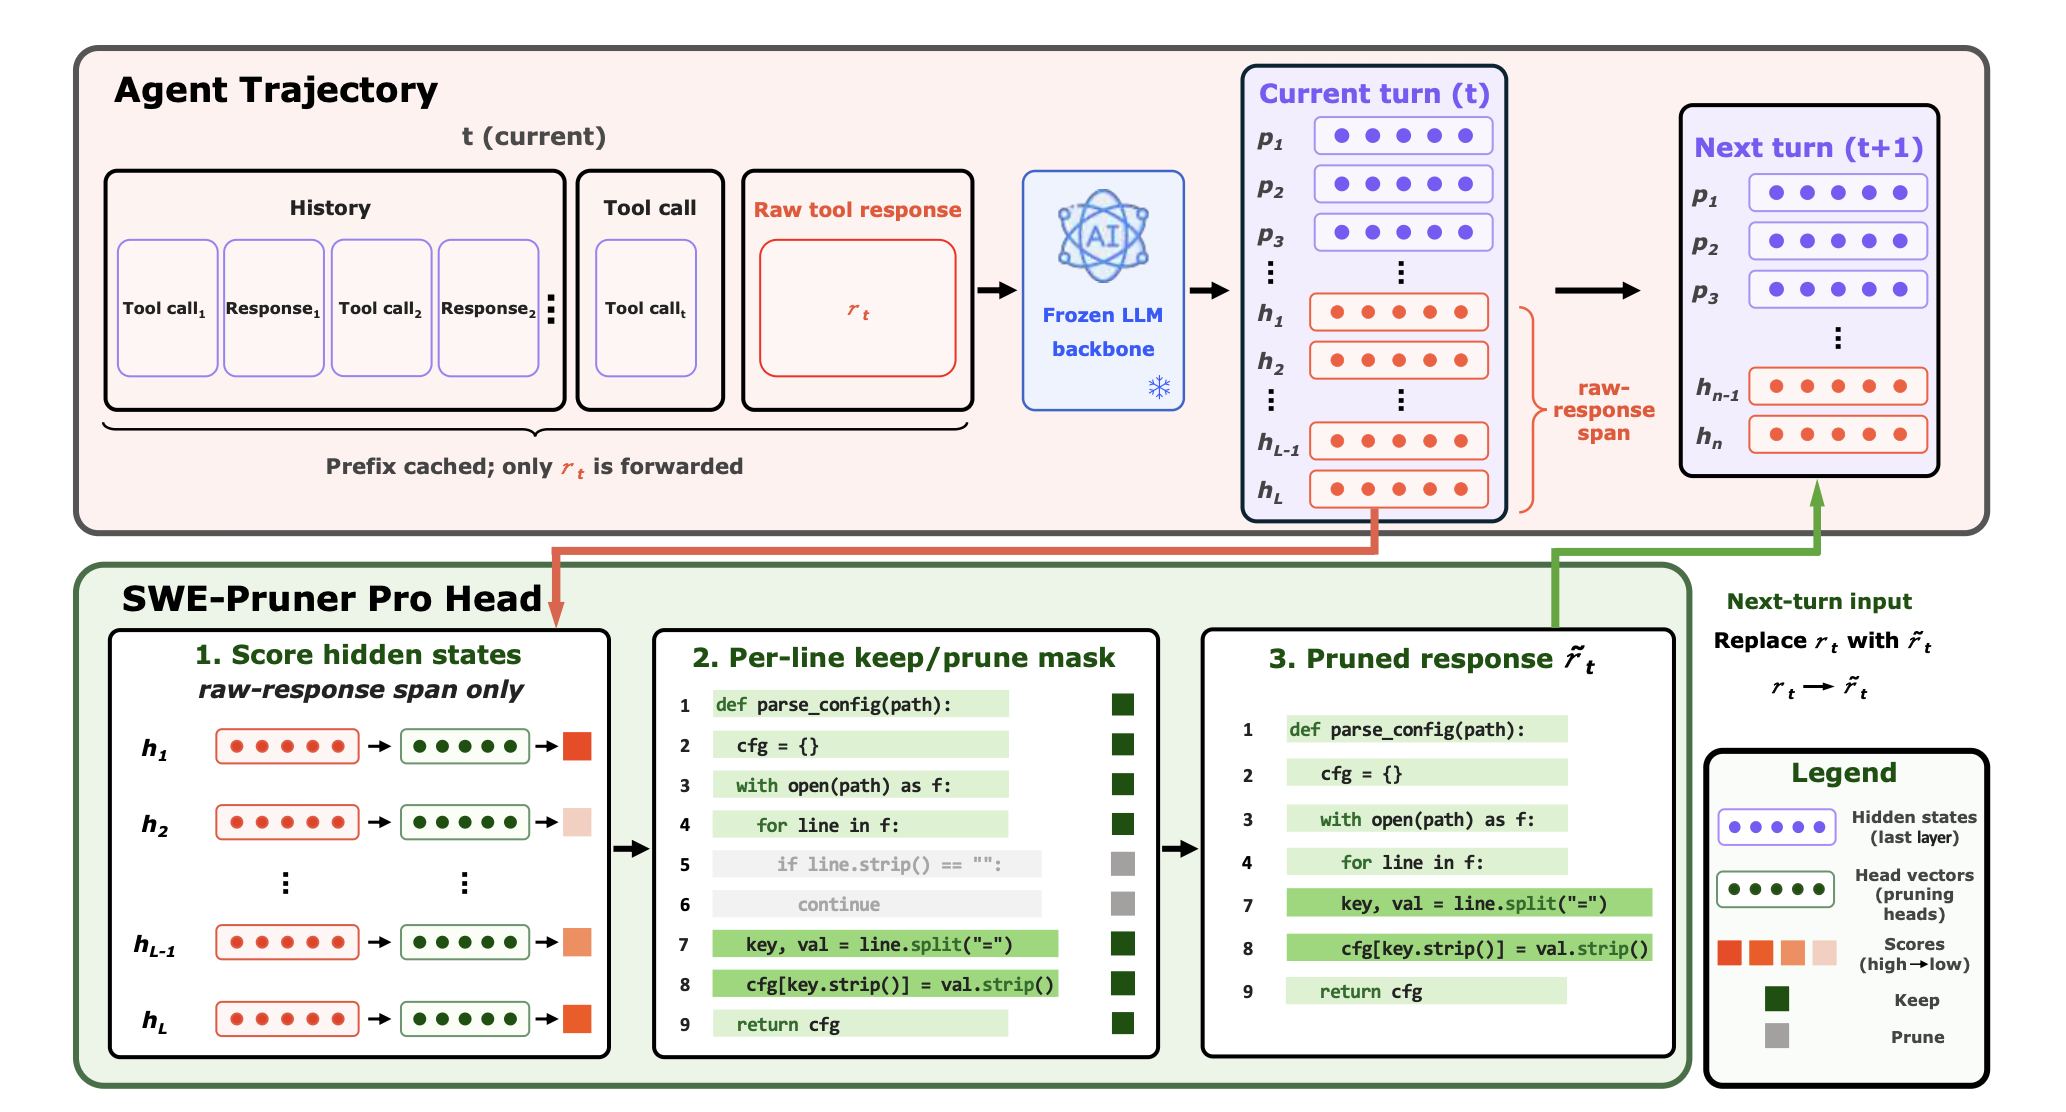
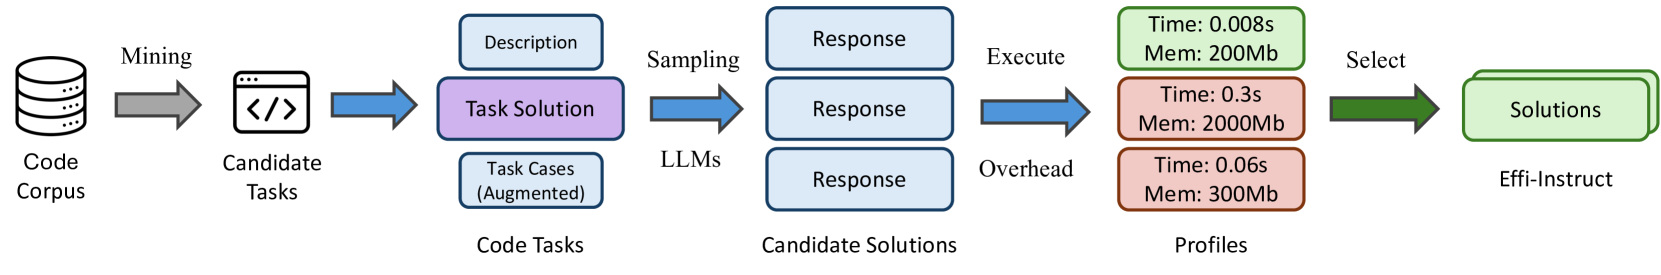
如图,省流就是LLM backbone正常推理,推理时带出hidden state,针对这个hidden state → 裁剪与否的映射进行训练。

另一个问题就是使用哪个区域的hidden state? 我们使用tool response区域的hidden state。即,模型在发起tool call,收到tool response之后,进行一个 1-token forward, 算出裁剪后的新tool response,替换后再正常继续推理

数据集​

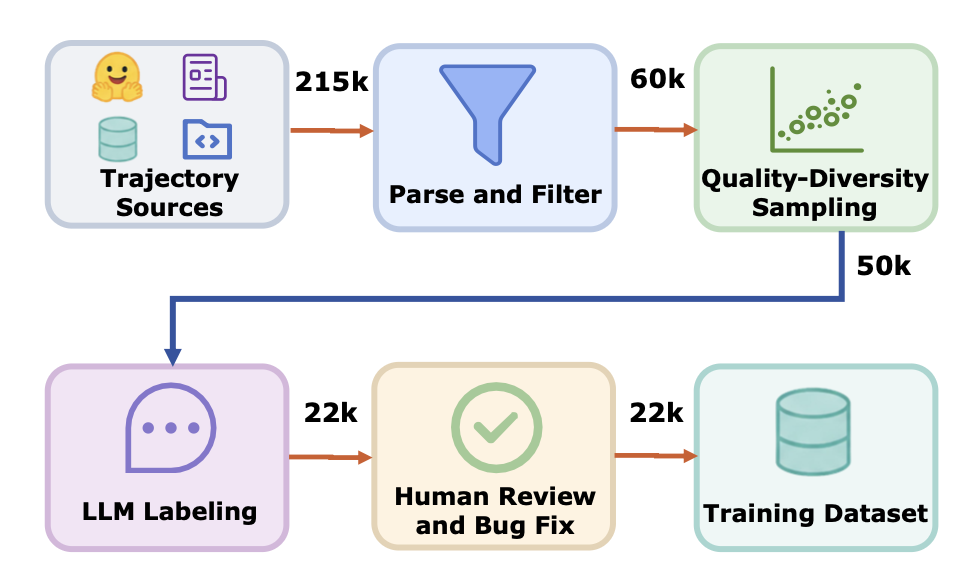
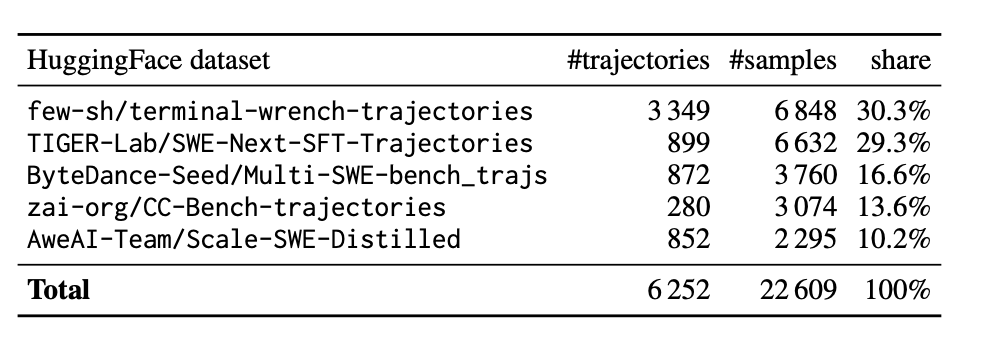
见论文中的一图一表,一个值得指出的是,因为上面使用hidden state的架构设计,我们需要保持hidden state和真实推理环境类似,所以需要多轮轨迹数据,而不是之前Pruner的单轮数据

没有question之后出现的一个麻烦是不好标注Prune/Kept了,我们的解法是使用AgentDiet同款: 令标注模型看历史和未来若干步,然后根据 “当前步对历史和未来的影响” 来打保留/裁剪的标,标注使用Claude Sonnet 4.6完成,弱模型有点标不明白

image.png

image.png

训练​

image.png

训练本身没有太多好说的, 这个任务本质就是一个 Feature → 0/1 label 的经典ML任务

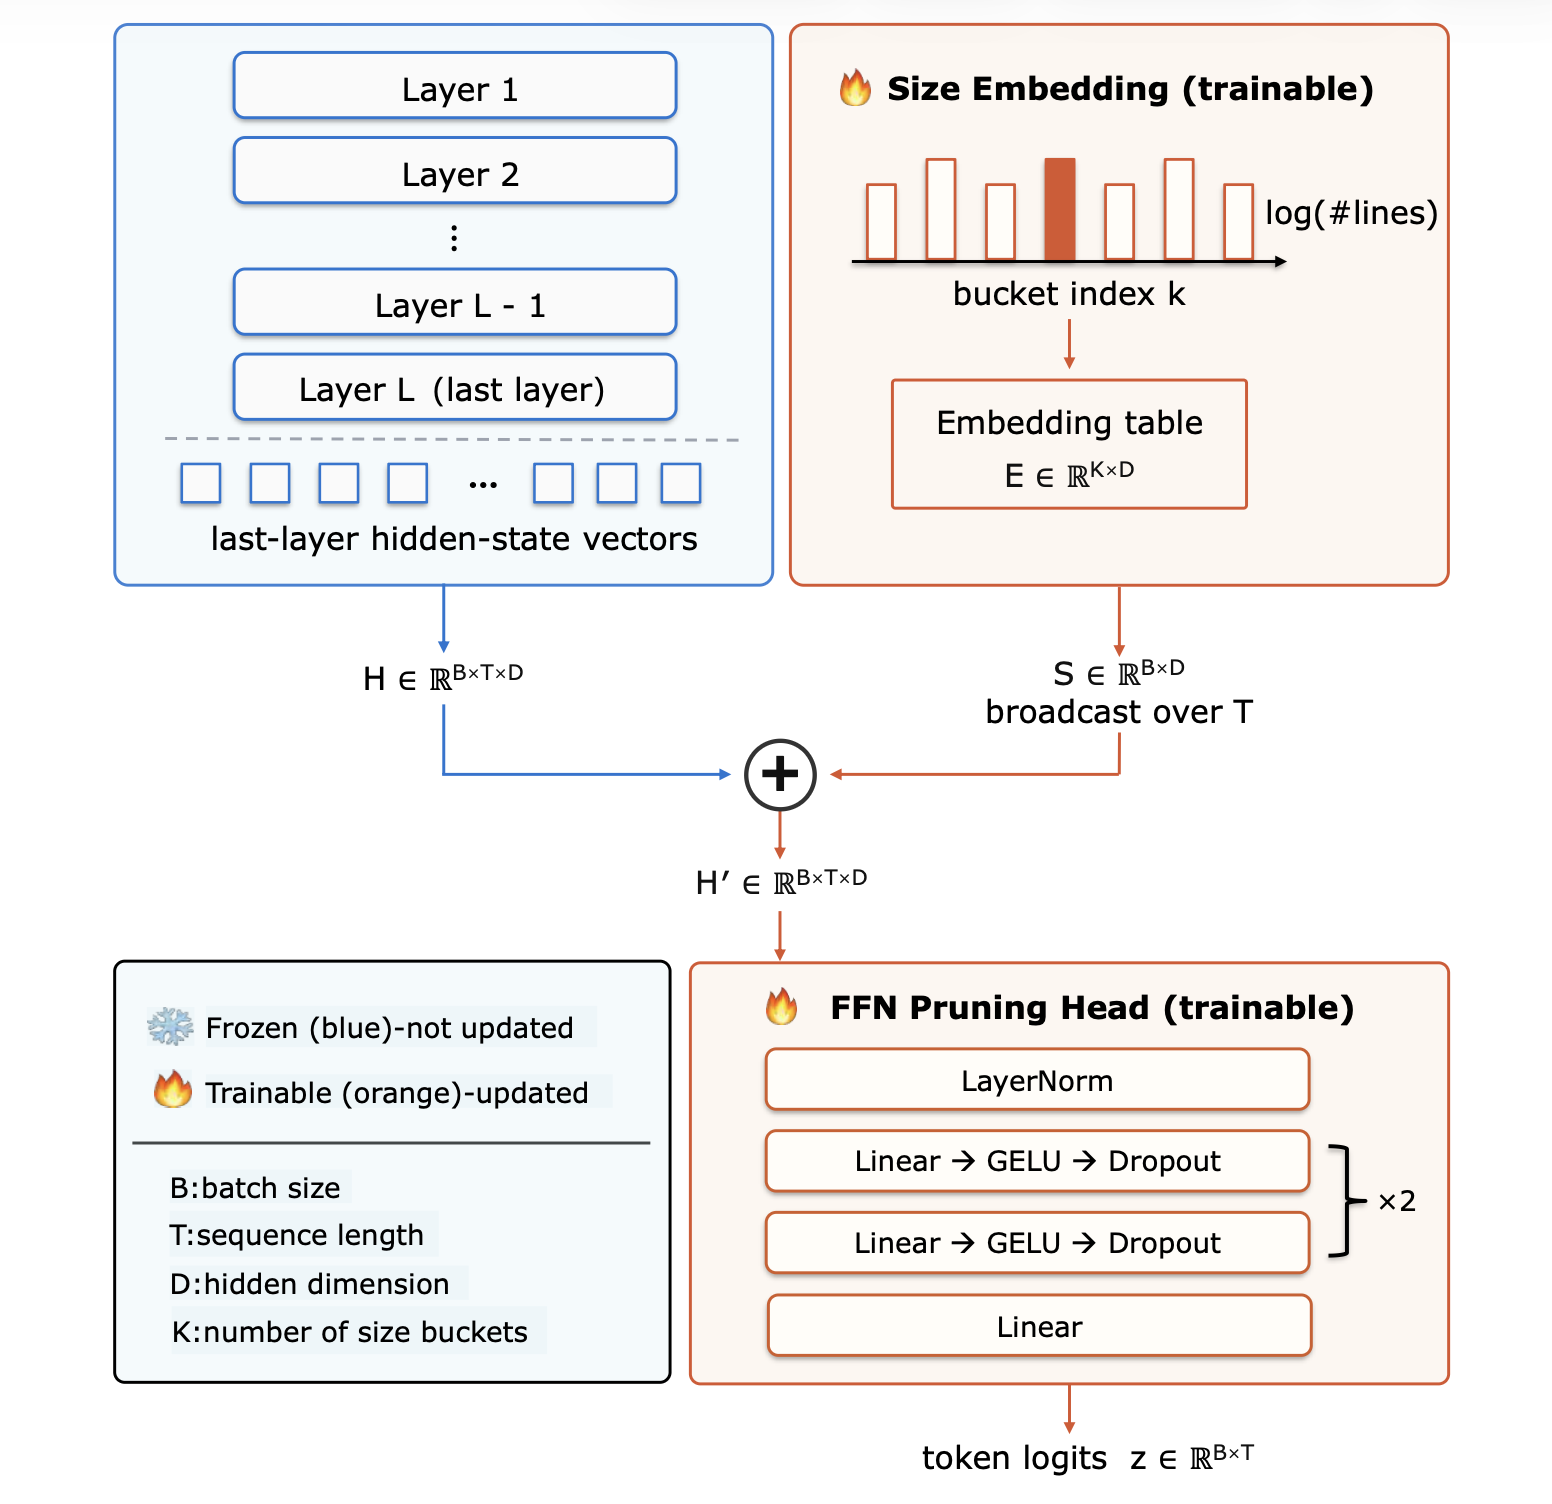
使用SWE Pruner同款Head也问题不大,但我实测CRF头不是很稳定,可能是因为没有显式question之后本身决策就多了一些模糊的成分。所以FFN就行。

我觉得比较重要的是两个新加入的小巧思,即论文中的size embedding和per sample balanced focal loss

size embedding的作用是, 让模型对需要裁剪的内容长度有感知, 朴素的想法是, 长的可以多裁,短的可以考虑放宽,起到一个自适应阈值的作用

而loss的改造则基于这样的观察: 看起来这是一个二分类问题,但实际上,Prune和Keep的作用不是平等的!

如果一个gt之中,100行keep了3行, 则这三行的漏召回会比其他行的误召回影响更大

也就是说,一个样本keep的行数本身,就带有一定的重要性信息,打标模型越强,留的越“骨架”,留下的部分就越重要。

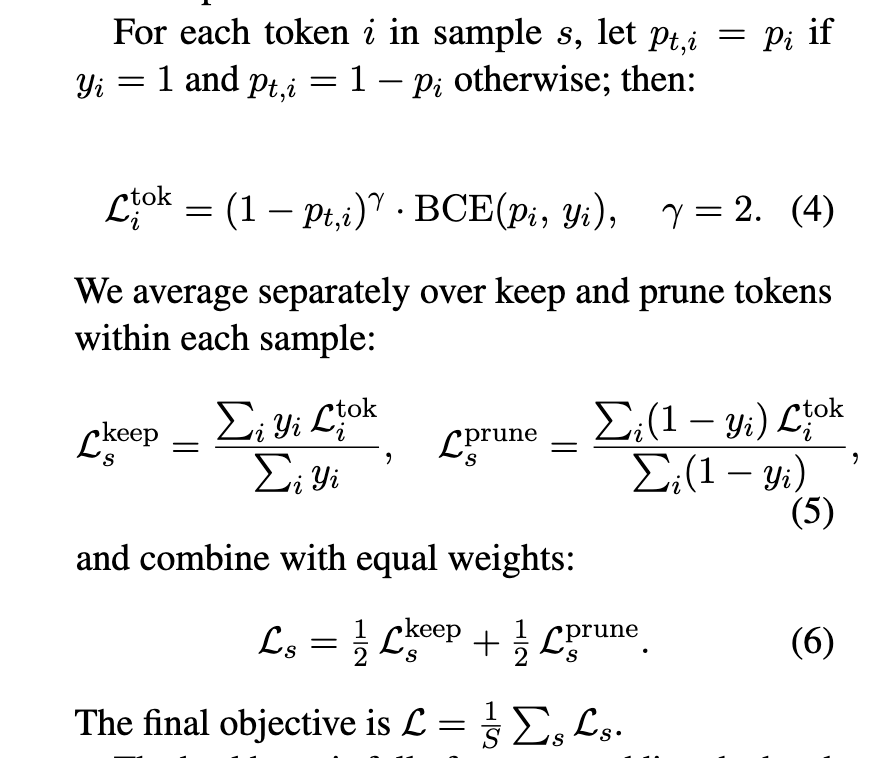
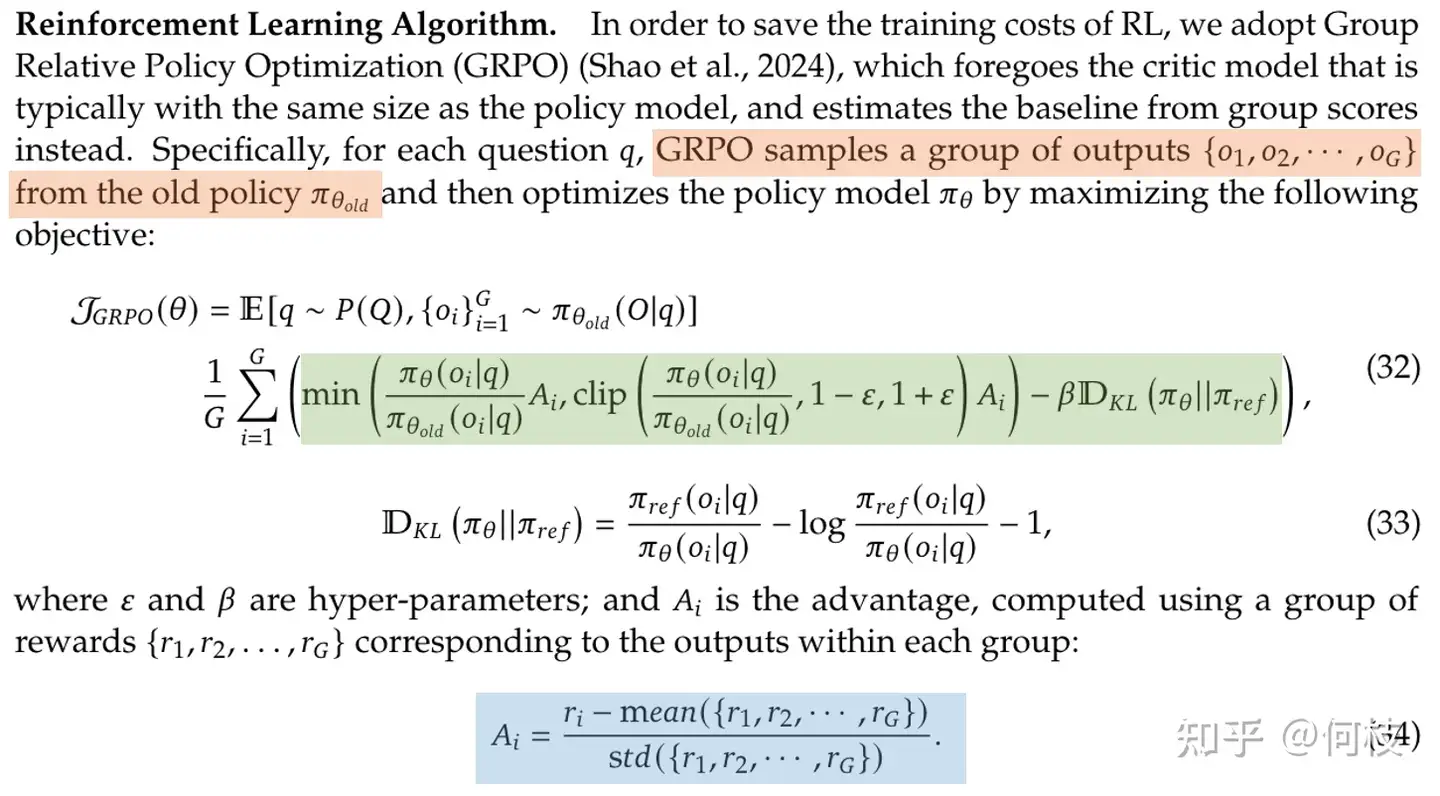
所以基于这样的观察,就可以对Focal Loss做一些更保少数类召回的改造,即我们论文里的

image.png

本质上,强制Prune 类的召回和Keep类的召回一样重要: 如果只有少数Prune,那这几行Prune的是模型觉得更应该删去的(不然由于连贯性的考量,会标注为丢弃这个样本);如果只有少数Keep,那这几行是模型觉得更应该保留的

推理​

推理的关键在于两个:

  1. 如何带出hidden state
  2. 如何适配Agent层

对于1,可以看我们论文里面的Appendix E, 详细地讲述了如何在sglang里面相对高效的支持这样的需求。走裸transformer慢得无法接受,走vllm只支持offline extract,但我们这套逻辑要求online serving —— sglang 改起来更简单一点,相对来说。(但也有相当多的patch,瘫,这个feature没什么人用,很多模型适配/和其他的feature的适配都一点没做)

对于2,我们的动机就是Agent层零适配。但其实坦白讲,也不能做到完全零适配 —— 我们这个头总要给Agent留一个开关,总不能所有工具调用都进行裁剪 —— 假如把 echo 裁剪掉了是相当“令模疑惑”的。现在的实现就是模型可以直接输出一个特定的标识符“SKIP PRUNE IN NEXT X TURNS”,Agent框架检测到标识符之后bypass接下来的X轮。

为什么不… (FQA)​

附上一些论文里面没讲的消融

Q: 为什么不用全history的hidden state?

A: 没想到什么好的架构,变成一个变长的东西了;并且,性能有一定影响

Q: 为什么只用最后一层

A: 主要是考虑到性能和支持问题,最后一层的hs的网络传输量已经很大了,如果全layer或者走SWE Pruner的多层融合会成倍加上时间开销,并且主流推理引擎都不支持返回多层。此外,我在小样本集上做了实验,在所有层之中挑最优/选最后一层/所有层softmax融合性能基本没什么区别。

Q: 为什么不用残差流

A: 推理支持问题,加上不做可解释不太熟

Q: 为什么选这几个模型

A: 想选glm的,适配半天没适配出来,qwen是最好适配的。kimi linear也适配不出来。工程难度太大了…… mimo 300B已经很大了,跑实验的资源开销有点大。如果没有自定义serving engine跑swebench等bench的需求,是想跑更大更主流的模型的,比如几个1T的开源。

Q: 为什么不做可调阈值

A: 因为发现没人调,直接在模型层size embedding完成更好

Q: 为什么用这些数据集

A: 找不到更好的数据了, … 开源的好轨迹太少了, 很多都没有thinking之类的, 甚至和推理都还有很严重的不一致…… 已经连网安任务的轨迹都大量拿来用了,好轨迹肯定更好

Q: 为什么不报单次latency

A: 因为Pruner有明确的latency随output token曲线,而Pruner Pro本质的latency是一次TTFT,一是强绑定历史长度,二是随负载和引擎策略有巨大方差……自己mock没啥意义,就选了几条实际的轨迹汇报端到端结果

总结​

回到引言里那两个问题

  • Engineer 关心的接入:Pro 这条路把裁剪的开关从工具参数挪进了模型里,Agent 框架侧只剩一个 bypass 标识符,相比前作那种侵入式包装要干净一些
  • Researcher 关心的 Scale:基座越强,hidden state 编码的 keep/prune 信号就越清晰,所以 Pro 会更能跟着 backbone 一起 scale,而不再卡在 "agent 会不会写 question"

整篇blog留下的另外一个观点是:让一个独立小模型重新算 backbone 已经算过的东西,是 Agentic 系统里一个被普遍接受、但其实并不优雅的范式。Pruning 只是这条路上最容易验证的一步,其它任务大概也能走类似的路 —— 前提是推理引擎愿意把 hidden state 当成 first-class。等将来这方面的基础建设完善之后, 相信会出来更多有趣的应用和研究实践,比研究如何写更好的压缩prompt总是有意思多了。

Read Its Mind, Not Its Output. 做完了之后回看, 从Pruner到Pruner Pro又类似Provence到Oscar了,还是很有趣的。

7-9月Paper Reading

· 21 min read
ayanami

放点觉得有意思的部分和没意思的部分。


SAE用于AI搜索的可解释性​

2026-06-08

先放上最近看到的有趣的一篇:https://arxiv.org/abs/2605.29507

AI搜的可解释性一直是疑难杂症问题,纵然有多向量归因、cite等做法,使用起来场景限制也很大。这篇文章把SAE用到了AI搜上还是令人挺新奇的。

大体上就是,取embedder的SAE将稠密特征变成稀疏特征,然后对某个SAE特征f,在文档集合里面选f激活比较高的,LLM总结得到f的可解释释义。

可能觉得这样novelty太低或者做不work,所以文章花了很大力气在讲一个米奇妙妙设计:在做SAE之前,先做一次特征增强。大体上是把embedding任务分成三类——一类QA,一类意图,一类总结,用LLM产出这三类的带COT的文档,重新生成嵌入,这样先在大方向上分离的再进行SAE抽小特征。

不做这样的特征增强几乎完全没训出来。

由于不太懂可解释性,感觉是有趣的做法,就是不知道那个可疑的图带来了多大的性能提升。但反正我尝试把SAE直接用到我的工作里面的时候直接和random差不多,所以这个trick应该还是重要的。


Socratic-SWE:自进化Coding Agent的深度解剖​

接下来评这篇,前两天刚出的,感觉要得罪人了,又是本校网红组的paper:

Socratic-SWE: Self-Evolving Coding Agents via Trace-Derived Agent Skills https://arxiv.org/abs/2606.07412

方法云山雾罩的,绕一大堆公式,看起来非常promising但细究下来可疑的地方很多,慢慢细讲。

文章target很直接,自进化通过写更好的skill的方式提升端到端性能。采用的是Qwen3.5-9B同时做出题员Generator和解题者Solver,在SWE Smith上训,然后在SWE-bench系列测,标准操作。

但它用了几个让我觉得非常奇怪的做法:

  1. skill自进化是没有品味的,做烂的topic,我直接开地图炮,我觉得这方面现有的文章几乎都是rubbish
  2. 非常常见的Generator看错误轨迹对应出题,然后Solver解题的self play做法,虽然我非常质疑这样出出来的题目就是overfit,9B的模型既要改代码又要写测试还要设计query,设计出来的肯定是没法看的
  3. 为了让2看起来Promising,文章采用了一个很难以证伪的做法:让LLM和skill一起被更新——我又更新Generator,又更新Solver,又更新skill,最后说端到端性能提升协同进化。消融只做了1.不更新skill 2.换LLM RL的算法,并没有做固定LLM frozen的消融,这是非常奇怪的。你既然claim skill被更新了是主要收益,那原始模型+skill不应该有明显提升吗?感觉上,让LLM和skill一起动像是在让LLM过拟合system prompt
  4. 文中大量的神秘超参数。首先上来就是一个0.5/0.3/0.2的lambda加权,又是Generator Reward里面有一个神秘的梯度cosine,claim说这是为了让Generator出的题真的对Solver LLM的更新有帮助。我真的懒得喷梯度cosine,高维向量几乎均为处处正交是不知道的,要么show给我原始的log证明不是0,要么就是代码实现都错了

经典图画一堆公式一堆概念一堆绕来绕去,细究满头问号。核心novelty就是那个疑惑的RL操作。

关于自进化这个方向,我不是很想做。我觉得一万个人有一万个自进化,另一个是我觉得现在的自进化完全是在工程的基础上套概念拼novelty,非常空的说法。不如老实把长文能力、IF能力之类做好。

自进化中唯一有意思的​

看到的自进化相关的只有一个HL engineering比较有意思,LLM用规则进行自进化,很严格的限制了自进化的范围,并用标准的RL gym局限了任务类型:

https://trinkle23897.github.io/learning-beyond-gradients/#zh

另外一个可以看的是翁家翌做的,挺有意思——不是规则限定自进化,而是自进化的方式是写规则而不是写skill这种黑盒叠黑盒。

说白了这就像是自动生成证明或者AutoML,屎山可解释性总比模型强,控制好屎山的出入口就行直接当黑盒优化。


关于OPD、自蒸馏与Cursor的讨论​

关于Online Policy Distillation(OPD),推荐两篇:

OPD能这么火确实是学术炒工业冷饭炒没活了。不过我觉得这事最神秘的是Cursor用这个方法做出来了。Cursor的特权信息可能真有明确的真实信号,毕竟真实用户多轮反馈轨迹。如果从gt和hint泄露问题估计会非常大。

所有做SWE的人都知道gt有问题,SWE的gt能有50%正确率都了不得了,严判+无人工的话。


Dockerless:无环境训练的Verifier​

Dockerless这篇做的还可以的(唉同门捧臭脚):https://arxiv.org/abs/2606.28436

省流: 基于"模型能无环境推理而不掉太多点"的观察,猜想能否无环境训练,则问题转化为做一个无环境的verifier。

方法则是类rubric,给到一个评估,先拆subquestion然后丢给subagent去explore & answer,再让一个模型聚合query、answer、gt、patch来进行verify。这里先拆后丢是一个希望获取更多角度的context的设计,尝试解决传统rubric judge下context window很难定并且很影响结果的问题。文章后续探索了拆的数量,表明k=4就差不多饱和了。

另一个insight是,training free的情况下,这类的测试时增强都是有上界的,所以利用原先的测试,把所有的rollout轨迹做拒绝采样,只留下能和原先测试gt judge一致的,做RFT。训出来这个verifier后,把这个送回去做无环境RL,发现效果不错。

我个人觉得重要的:

  • 这个拆了丢subagent确实解决了rubric的部分问题,很巧的思路
  • RFT的实验结论也确实是相对不同的角度,一般大家提无环境总是觉得环境做起来复杂麻烦正确性不好保证,这里的无环境从rollout时的行为来讲还挺有趣的,也体现了一定程度上researcher和engineer的思维方式不同

Pretrain数据构建学习​

2026-07-07

最近开始学习pretrain这边数据构建,先丢几篇感觉不错的:

Apple这篇写的是真不错: https://arxiv.org/html/2510.00866v4

NV这篇很符合直觉的工作,但感觉不如Apple那篇远甚: https://arxiv.org/html/2510.03264v1

由于并不熟这个领域,欢迎各位来帮忙丢论文。


Long Horizon Agent与General RL​

2026-07-13

https://arxiv.org/html/2601.16211v3

这一篇和coding没什么关系,但是是Naver Lab的,对他们的工作有比较高的好感于是看了看。描述的这个问题很有意思,感觉实质上对于Code Agent或许也有类似的关系,maybe可以研究一下。

https://arxiv.org/abs/2607.08964

这个bench看起来似乎能用来研究一些general的long horizon机制,先放一下。感觉似乎干了我之前想干的事情。

https://arxiv.org/html/2607.07508v1

General RL相关的,工程上的一种做法。


Language Model Harnesses as Compositional Generalizers​

2026-07-23

https://www.alphaxiv.org/abs/2607.language-model-harnesses

之前就很focus RLM,粗略地过了一遍这篇提出的insight感觉是很不错的。


Kimi的QK Clip与蒸馏中的Ranking Loss​

2026-08-06

等训练的过程中丢点东西吧,可能有空的话还是看点架构上的东西。

讲Kimi的QK clip的:

感觉还是很详细的。

除此之外最近有用到ranking loss,主要是解决MSE的过分锐化的问题: https://zhuanlan.zhihu.com/p/16484895233

读者不妨和AI讨论一下,为什么在真实"打标-训练"的黑盒蒸馏场景下,MSE会有不容易定阈值的问题,以及长尾的问题。虽然这两个问题实际上对应不同的需求场景,并且反直觉的是前者更为重要倒是。


关于数据量级的思考​

2026-08-07

最近有一个感觉是不同数据量级下的变化太大了。一个算法可能在10k、100k数据量work,在1000k就是负收益了。

对于不同大小的模型能吃下多少有效数据,理论上限性能大概是什么样子,不同训练阶段影响性能的卡点等,我觉得也是重要的经验能力,甚至某种意义上比各种算法trick重要得多。没有办法直接外推。


Google的C++ AI4SE实证分析​

2026-08-10

Google的C++ AI4SE实证分析:https://arxiv.org/html/2608.06640v1

需要更多这样的文章啊,感觉一篇大于100篇AI水文。


抖音多模态Embedding报告​

2026-08-10

抖音的多模态embedding报告:https://arxiv.org/pdf/2608.02148

很fashion的做法,指标也很不错,工业报告还是太全面了。居然看起来还是实习生solo的,牛逼。能看到许多之前工作的影子,但能全部组合上做出收益真不容易。


SFT vs RL的梯度正交性​

2026-08-10

https://arxiv.org/pdf/2608.03573

不错的可解释文章,展示方面下了功夫,well written。

RL和SFT的driven pattern不同是非常well known的事情,这里RL梯度方向的正交性是相当不奇怪的,MOPD的成功等大量先前的实验也佐证了这一点。但是SFT的不正交是一个有趣的发现和理论论证,以及这个不正交有严格的消融说明了梯度本身确实代表了下游评测集的性能退化。

另一个是都说SFT影响大、RL影响小,这里直观展示L2范数有~100倍的差异也是一个很不错的地方,让人有一个更定量的认识。

后面的机制解释的话,KL会趋向于小幅度更新之类的是非常直觉的结论,但GRPO的zero sum性质引导了正交性这个可能就没那么直接,还是对如何设计真正工业可用的xxPO/xxOPD有一些指导的。

至于论文的application的"并行强化学习",感觉上像是对工业合版算法的简化,感觉有点过分粗暴了,并且如appendix消融显示的很依赖领域划分,感觉不是本文亮点。


SWE Refactor Bench​

https://arxiv.org/html/2608.09802v1

又看到自家文章了,但说实话感觉这篇不咋样,几个问题:

  1. 模型太老了,这篇文章拖了太久,寒假测的实验现在才发,最新的模型都已经是GPT 5.2了,感觉完全没有什么参考价值
  2. Refactor本质上怎么judge的交代不清。我觉得refactor应该是用类似ProgramBench的黑盒judge方法,但粗看下来本文章还是白盒黑盒混一起,用类SWE-bench的方式judge,也没有刻意讨论说refactor judge的过程中对于主要行为和边界行为的一致性的检查的保证。感觉上是yet another SWE-bench,虽然文章批评了SWE-bench系列的issue-test不匹配的错漏,但自己对于这个问题的保证方法也就是agent核查+人工检查,和SWE-bench并没有任何的区别,为什么要相信这里的人工比SWE-bench OpenAI的人工更好呢
  3. 部分结论已经过时。例如mini swe agent不如openhands、harness对模型性能表现很重要——首先这是非常well known的结论,完全不知道这个bench带来了什么新知;其次论文里面的表格细看都有明显的反这个结论的。我们知道前沿模型对于harness的依赖在逐渐减弱,如果使用opus5或者k3之类的模型,在不同的harness和数据集上,SWE表现都相当稳定。而论文里面的最大论据是GPT 5.2的从20到40的性能变化,但同一张表格里面就有Gemini-3-Pro的反向结论,以及甚至可以发现越强的模型性能变化越少,这也符合现在的认知
  4. Refactor真的是一个非常重要的问题吗? 或者说,这种issue driven而不是spec driven的refactor符合真实场景吗?我们不妨回看可能甚至不太成功的rewrite Bun in Rust运动,也是一个totally spec driven的工作,并且refactor的另一个judge维度是所谓的代码整洁性和设计架构,而文章避过了这个问题,并没有给出除了测试之外更好的judge维度
  5. 文章强调了使用的是自动环境构建工具例如SWE Factory进行的构建,但在这里构建成功的,是否本身就带来了巨大的分布bias?能否给出一些难以构建的用例的存在证明?例如一个复杂的嵌入式库,它的构建就是困难的——而就在构建失败的筛选之中,自然就被筛掉了
  6. 修改的文件数或者说patch大小感觉只是一个间接指标,显然这个题相较于新的DeepSWE等bench是远不够难的,修改文件数多并不意味着这个问题就一定难,但文章避开了相关的讨论

核心问题:文章时效性太强了,现在文章拖太久就过时了。

SaliTrap Benchmark​

我不喜欢这个paper,这个问题我觉得很无聊,并且给出了一个非常无趣的结论。大意是说LLM存在"显著性偏差",优先考虑显著的显式条件而非隐式的常识性前提条件。

Anything special? 这不值得写成一篇论文。这显然是一个指令遵循问题,并且是隐含指令的问题,御三家对于这个问题已经有相当全面的对齐描述。如果你认为这个问题很重要:

  • 有安全风险:应该构建实际越狱
  • 有隐含偏好:首先我们应该有实证分析证明这是一个问题而不仅仅是"当前的模型会不会做脑筋急转弯",并且头部模型内部的对齐"通用价值观"是高于一般指令的。我认为通用价值观 > 一般指令 > 可能的预置知识是合理的,以及它在真正生产场景中存在问题,以及可能的如何解决

Another boring benchmark. 建议本文作者在对炒作的热点构建bench之前先阅读:

来了解一下对齐任务到底要解决什么问题。总之我认为这篇文章not even wrong。


OpenAI Reward-Seeking行为​

https://alignment.openai.com/measuring-reward-seeking

很神秘的模型行为。


合成数据评估标准​

有人问:既然提了分数不能准确体现数据的质量,我们还能用什么方法衡量一个合成数据集是好是坏?

我觉得合成数据的评估维度应该至少包括:

  1. 难度
  2. 区分度
  3. 多样性
  4. Scalable,成本和分布上是否合理,成本包含训练成本(loss token比例)和打标成本
  5. 泛化性,数据训了能不能在所有bench上都提点,换言之,这个数据到底想要让模型学什么pattern
  6. 有没有明显的垃圾
  7. 正确性,包括hack,本身是否well define等

这些问题不是丢给模型就能度量的,模型肯定分不清。有部分可以通过半人力半agent管道的方式,即人不断校正agent,剩下的在做之前就应该由人想清楚。

质量与多样性的兼得之策

· 20 min read
Tags:
ayanami

引言​

最近做 post-training 筛数据时反复遇到一个需求: 想从一个大池子里挑一个小子集, 既要分高, 又要在某些维度上分散, 比如 repo、tag、语言、时间。

本篇博客主要介绍一下我的思路, 其实把这个看成一个前AI时代的组合优化问题, 想要得到一个优解并没有那么难。数据的多样性不应该是一个"先采样什么什么, 看看分布, 再升降采样"这样的"人类启发式优化", 而是能够给出优性证明的稳定可复现流程。

基于一些数据之类的敏感性, 这个工具不会开源, 让你的Claude Code看完自己复现一个(doge

多样性需求​

先说几个的场景, 直观感受一下"质量 + 多样性"到底在说什么:

  • PR 池筛 SFT 数据: 1000 万 PR 里挑 1 万, 每条都打过质量分。直接 top-k 的结果是名额大头来自前几个仓库 — 模型只学会"那几个仓库的风格", 对其他仓库基本不泛化
  • 多语言代码 SFT: 想要 Python / TypeScript / Go / Rust 比例大致均衡。某些语言的样本质量分普遍高, 直接按分排会几乎全是 Python
  • 难度 benchmark 抽样: 简单/中等/困难三档各占 30%, 但模型在中等档输出更长更整齐, 质量分会更高, 直接选会偏到中等
  • 去重 + 高分: 选 top-k 之后发现里面有一对 embedding 几乎重合; 或者同一 repo 三天内的两条PR 改了同一个文件
  • 覆盖长尾: 数据集有 200 个 task tag, 不希望某些 tag 一条都不选

这些场景的共同特征: 每条数据本身有个分, 但不能只看分。某种"结构"在里面 — 同 repo / 同 tag / 同时间窗 / 同语义簇 — 决定了我们要让候选在这个结构上散开。

把需求抽象一下​

把上面这些场景翻译成数学, 我发现它们能整理成三类偏好:

1. 一元偏好 — 单条数据本身的加减分 "带 testing tag 的多加 0.3 分"、"质量分本身"、"主动学习里的不确定度奖励" — 这些都是 per-item 一个 delta, 跟其他条无关。

2. 多元对称偏好 — 同组数量的某种函数 "同 repo 不要太多"、"长尾 tag 至少保 3 条"、"label 比例 4:3:3" — 都是先按某个 key 分组, 然后对每组的"被选中数量"算一个罚或奖。关键在对称: 在同一组里, 哪几条被选中并不重要, 只看选了几条。这个对称性是它能写得简洁的根本原因 — NN 条数据展开成两两关系是 (N2)\binom{N}{2} 项, 但因为对称, 折叠成"每组的数量函数"就只跟组数有关。

3. 二元偏好 — 两条之间的关系 "embedding 余弦 > 0.9 的两条不要一起选"、"同 repo 3 天内的两条互斥"、"n-gram 重叠太大互斥" — 这些是真两两的关系, 没办法折叠成"组数量"。

第一类几乎零成本, 直接加进基础分。麻烦的是第二、三类 — 它们都是 NN 上的非线性 / 高阶项, 不做妥协的话求解会爆炸。

设计选择: 哪里做妥协, 为什么是合理的​

第一类一元偏好几乎零成本, 直接累加进基础分就行。麻烦的是第二、三类 — 它们都是 NN 上的非线性 / 高阶项, 不做妥协的话求解会爆炸。和 Claude Code 脑暴一番后, 我做了三个非平凡的限制。这些限制让算法可解, 同时我认为它们恰好踩中了业务需求的结构。

限制 1: 二元偏好只支持稀疏图

二元偏好理论上是 N×NN \times N 的矩阵。如果稠密, ∣E∣=Θ(N2)|E| = \Theta(N^2), 不管什么算法都跑不动 (N=107N = 10^7 时矩阵都装不下)。我的限制是 ∣E∣=O(N)|E| = O(N) — 平均每条最多跟常数条相关。

业务上其实非常合理: 实际场景里"哪两条要互斥"几乎都来自一些稀疏化的关系 — embedding 的 kNN (每条只跟最近 K 条相关), 时间窗 (每条只跟前后几天相关), LSH bucket (每条只跟同 bucket 的几条相关)。"全 N*N 矩阵"这种在工程上本来也算不出来。

好处: 稀疏二元可以按连通分量切开, 每个分量独立求解 — 用并查集把禁忌图分成若干组, 组与组之间没有耦合。∣E∣/N=O(1)|E|/N = O(1) 时大部分分量就一个点, 这一档是 O(1)O(1) 的; 真正费力的只有少数大分量 (典型 m≤200m \le 200), 用分支定界或小型 LP 处理。

限制 2: 多元偏好只支持组数量的对称函数

多元偏好理论上是 NN 上的一般 set function f:2V→Rf: 2^V \to \mathbb{R}。这种太一般, 求解需要枚举所有子集。我的限制是只支持"按 key 分组, 对每组数量算一个标量函数"。

业务上借用了上面"对称性"的观察: 大部分多元需求 ("repo 散开" / "tag 比例" / "长尾覆盖") 在同一组内对哪几条被选中是无差别的。把这种对称结构显式地表达出来, 求解就从 2N2^N 量级降到 ∑g(∥g∥+1)\sum_g (\|g\|+1) 量级。

限制 3: 组数量函数限制成凹

"组里选越多越亏"的形状有很多种 — 凸的、凹的、阶梯的、V 形的。我只支持凹的。

这个限制纯粹是为了让对偶松弛紧 — 凹函数有切线上界, 切线斜率可以折进每条数据的有效得分, 组与组之间的耦合就消失了, 拉格朗日松弛紧, ratio 证明成立。

需要先把"凹"这个词说清楚, 因为它跟"递增递减"是两码事 — 凹 = 二阶差分 φ(n+1)+φ(n−1)−2φ(n)≤0\varphi(n+1) + \varphi(n-1) - 2\varphi(n) \le 0 = 图像永远不"鼓起来", 跟函数本身是涨是跌没关系。直观说就是 marginal increment 不增。

业务上常见的形状几乎都是凹的:

φ(n)\varphi(n)业务含义凹?
−αn2/2-\alpha n^2/2二次罚: 每多一条罚得更狠✓ (二阶差分 −α-\alpha)
−α(n−log⁡(1+n))-\alpha(n - \log(1+n))饱和罚: marginal 罚趋稳✓
−β(n−t)2-\beta(n-t)^2双向贴近 tt (TargetDistribution)✓ (∩\cap 形抛物线)
min⁡(n,τ)\min(n, \tau)覆盖饱和: 至少 τ\tau 条之后边际收益清零✓ (分段线性)
−nlog⁡(n+ϵ)-n\log(n+\epsilon)熵最大化✓

不凹的典型反例: 阶梯硬约束 (n≤τn \le \tau 时 0, 超过给 −M-M) — 在阈值处先平后跌, 中间出现凸弯。

从偏好到算子​

把上面的抽象写成代码, 引擎只需要识别三个算子:

算子数学用例
UnaryPreference∑iδixi\sum_i \delta_i x_i"给带 testing tag 的多加 0.3 分"
VariancePreference∑gφg(∑i∈gxi)\sum_g \varphi_g(\sum_{i\in g} x_i), φ\varphi 凹"同 repo 不要太多"、"label 比例 4:3:3"
SparseBinaryPreference∑(i,j)∈Eψijxixj\sum_{(i,j)\in E} \psi_{ij} x_i x_j, EE 稀疏"embedding 太像的互斥"、"7 天内的互斥"

总目标:

f(x)=∑isixi⏟每条加分+∑gφg ⁣(∑i∈gxi)⏟组里数量的凹函数+∑(i,j)∈Eψijxixj⏟两两不要一起选f(x) = \underbrace{\sum_i s_i x_i}_{\textrm{每条加分}} + \underbrace{\sum_g \varphi_g\!\left(\sum_{i\in g} x_i\right)}_{\textrm{组里数量的凹函数}} + \underbrace{\sum_{(i,j) \in E} \psi_{ij} x_i x_j}_{\textrm{两两不要一起选}}

最大化 f(x)f(x), 约束是 x∈{0,1}Nx \in \{0,1\}^N (每条要么选要么不选), 总数 ∑ixi=k\sum_i x_i = k。

API 设计​

  • UnaryPreference(name, transform: Dataset → ndarray[N]) — 用户写一个函数, 给每条数据返回一个 delta
  • VariancePreference 是一组子类 (Quad / LogSaturating / SoftCap / SoftFloor / HardCap / TargetDistribution), 它们都吃一个 grouping: Dataset → dict[key, ndarray[int]] — 用户写一个函数, 把数据按某种规则分组。具体的 φ\varphi 形状由子类决定 (二次罚 / 上限罚 / 下限罚 / 双向贴近 target)
  • SparseBinaryPreference(name, transform: Dataset → scipy.sparse.spmatrix) — 用户写一个函数, 返回一个稀疏矩阵, 每个非零项 (i,j,ψij)(i, j, \psi_{ij}) 表示一对禁忌

最关键的设计决定是: 保持solver的抽象层级。怎么按列 group_by, 怎么取某 tag 的布尔掩码, 怎么算时间窗内的 pair — 全是业务决定, 用户在自己自行传入funtion。这样加新约束的时候不用改求解器, 只写一个 transform 函数。

举例:

from selector.rules import Quad, SoftCap, UnaryPreference, SparseBinaryPreference
from selector.solver import Selector

def group_by_repo(ds):
out = defaultdict(list)
for i, r in enumerate(ds["repo"]):
out[r].append(i)
return {k: np.asarray(v, np.int64) for k, v in out.items()}

def tag_boost(tag, delta):
def fn(ds):
return np.where(np.array([tag in (t or []) for t in ds["tags"]]),
delta, 0.0).astype(np.float64)
return fn

res = Selector(
ds, k=700, scores=scores,
preferences=[
UnaryPreference(name="testing_boost", transform=tag_boost("testing", 0.3)),
Quad(name="repo_var", grouping=group_by_repo, alpha=0.05),
],
).solve(max_iter=30)

现有方法都怎么做​

  • MMR (Maximal Marginal Relevance): 贪心, 选下一条时罚一下"和已选的最像的那条"。简单, 但相似度阈值得自己定。
  • k-means + 每簇取 top-1: 先聚类后从每簇挑一个。簇数怎么选是经验。
  • DPP (Determinantal Point Process): 用一个核矩阵的行列式建模"diverse subset"。数学上漂亮, 但要把"repo 上分散" / "保留长尾 tag" 这类需求写成一个对称半正定核, Claude觉得不太直观, 而且大规模下计算量较大, 但我直接不会(笑)
  • SemDeDup / D4 / DSIR 这类数据筛选方法: 各自针对自己关心的痛点做了优化, 我没用过, 不敢评。
  • 基于 submodular 性质的贪心算法 (Nemhauser-Wolsey-Fisher 1978): 给出 1−1/e1 - 1/e 的最坏情况下界, 实际表现一般会比这个好。但我关心的目标 (例如 "label 比例 X:Y:Z") 不一定满足 submodular 的条件, 这个下界不一定成立; 即使成立, 我也很难知道这次跑出来的解到底好多少。

我最在意的点是: 没有一个数能直接告诉我"这次选的离最优解差多少"

常见需求示例​

需求配置
每个 tag 不超过 X 条SoftCap, target = X
同一作者不超过 X 条SoftCap, target = X
同一语言不超过 Y%SoftCap, target = int(k*Y/100)
难度三档各占 ≥ X%SoftFloor, target = int(k*X/100)
正:负:拒绝 = X:Y:Z (双向贴近)TargetDistribution, 给每个标签一个目标条数
选出来的 task_type 跟池子分布一致TargetDistribution, 按池子比例算 target
长尾类至少保 X 条SoftFloor, 分组时只输出小组
余弦相似 > 阈值的两条互斥SparseBinary + kNN, 控制边数 ∼O(N)\sim O(N)
同 repo 7 天内不要共选SparseBinary + 时间窗
信息熵最大 (按某 categorical)自定义 VariancePreference, φ(n)=−nlog⁡n\varphi(n) = -n\log n
集合覆盖 (每 tag 至少一条)LogSaturating 或 φ(n)=min⁡(n,1)\varphi(n) = \min(n, 1)
......

需要注意的几点:

  • 比例约束都先乘 kk 转绝对条数, engine 不知道全局比例
  • 真的硬约束建议在数据预处理阶段 filter 掉, HardCap 是软强约束
  • 跨算子的"如果-那么"逻辑表达不了
  • 相对阈值 (top X% by score) 表达不了, 需要在预处理阶段算好布尔列再传进来

理论证明​

弱对偶定理: 对任意 λ∈R\lambda \in \mathbb{R},

OPT=max⁡xfeasf(x)  ≤  g(λ)\mathrm{OPT} = \max_{x_{\text{feas}}} f(x) \;\leq\; g(\lambda)

其中 g(λ)=max⁡x[f(x)−λ(∑x−k)]+λkg(\lambda) = \max_x \big[f(x) - \lambda(\sum x - k)\big] + \lambda k, 这里 xx 取遍 {0,1}N\{0,1\}^N (没有"总数 = k"的约束)。

证明很短: 对任意可行解 xfeasx_{\text{feas}} (满足 ∑xfeas=k\sum x_{\text{feas}} = k),

f(xfeas)=f(xfeas)−λ⋅0≤max⁡x∈{0,1}N[f(x)−λ(∑x−k)]=g(λ)f(x_{\text{feas}}) = f(x_{\text{feas}}) - \lambda \cdot 0 \leq \max_{x \in \{0,1\}^N} \big[f(x) - \lambda(\textstyle\sum x - k)\big] = g(\lambda)

第一个等号: 可行解满足 ∑x=k\sum x = k, 第二项是 0。第二个不等号: 可行解集是 {0,1}N\{0,1\}^N 的子集, 受约束极大值 ≤\leq 不受约束极大值。

所以算法过程中遇到的每一个 g(λ)g(\lambda) 都是 OPT 的合法上界, 不依赖具体算法是否找到最优。我记录最小的, 输出 dual_bound, 报告

approx_ratio=f(解)dual_bound≤f(解)OPT\mathrm{approx\_ratio} = \frac{f(\text{解})}{\mathrm{dual\_bound}} \leq \frac{f(\text{解})}{\mathrm{OPT}}

这是真实近似比的下界: 报告 0.99 表示真实近似比 ≥0.99\geq 0.99, 真实 OPT 至多比当前解高 1%。

算法骨架​

外循环​

步骤做什么复杂度
1. 凹函数线性化当前每组数量是 nb∗n_b^\ast, 用切线斜率 φb′(nb∗)\varphi_b'(n_b^\ast) 把它折进每条数据的有效得分 aieffa_i^{\mathrm{eff}}O(∑b∥b∥)O(\sum_b \|b\|)
2-3. 每个连通分量算 Pareto对每个分量预算"恰好选 cc 个时的最大值 Vc[c]V_c[c] 和对应 mask Mc[c]M_c[c]"主瓶颈, 见下
4. λ-bisection二分搜 λ\lambda 让总选中数等于 kk, 同时记录最小的 g(λ)g(\lambda) 作为对偶上界O(50⋅∥comps∥)O(50 \cdot \|\mathrm{comps}\|)
5. 拼回 xx + 阻尼从 Mc∗M_{c^\ast} 拼出当前解; 用 Frank-Wolfe 步长 dt=2/(t+2)d_t = 2/(t+2) 更新 nbn_b, 防震荡O(N)O(N)
6. 收敛判gap = (g(λ)−f(x))/∥g(λ)∥<(g(\lambda) - f(x)) / \|g(\lambda)\| < 阈值 → 退出—

每轮在弱对偶意义下都给出合法上界。典型实例 5-10 轮收敛到 1% 以内的 gap。

外循环结束之后, 可以再做一个 1-swap polish: 在真实目标 (不是切线近似) 上, 找一对 (剔掉一个 + 加进一个) 使目标增加, 重复直到没有改进。Pollish 通常把 ratio 从 0.99 抬到 0.995+, 几百毫秒级开销 (典型规模)。

内层: 按连通分量求解​

把两两约束的稀疏图按连通分量切开 (并查集), 每个分量独立求解。按分量大小 mm 分发不同策略:

分量大小 mm求解策略复杂度
1 (孤立点)闭式判O(1)O(1), 全程向量化
无边的小分量按 aeffa^{\mathrm{eff}} 排序 + cumsumO(mlog⁡m)O(m \log m)
≤ 18暴力枚举 2m2^m 子集O(2m⋅m)O(2^m \cdot m), 微秒级
19 ~ 200分支定界通常 < 100ms
> 200LP 松弛 + iterative rounding100ms ~ 秒

一个关键的地方是: 在两两约束稀疏 (∣E∣=O(N)|E| = O(N)) 的条件下, 分量大小服从重尾分布, 大部分节点是孤立点。这一档跟 NN 是线性的。

整体 wall-time 在稀疏假设下是关于 NN 接近线性的 (大簇档项跟 NN 无关, 只跟最大分量大小有关)。

如果两两约束密集 (∣E∣=Θ(N2)|E| = \Theta(N^2)), 分量退化成一坨, 大簇档的 LP 变成 O(N3)O(N^3), 算法不适用。所以我的建议是: 写两两约束 transform 时先想稀疏化 — kNN 取 top-K, 时间窗、LSH bucket 之类。

自定义 VariancePreference 的注意事项​

如果你想加一个新的组凹罚 (比如自己的熵最大化):

  1. 写一个子类, 重写 phi(self, n: int) -> float
  2. 保证凹性: 离散二阶差分 φ(n+1)+φ(n−1)−2φ(n)≤0\varphi(n+1) + \varphi(n-1) - 2\varphi(n) \le 0 必须在所有合法 nn 上成立
  3. 凹性挂了, 切线就不再是上界, dual_bound 会静默地不再是合法 OPT 上界 — approx_ratio 失去意义。

小例子, 熵最大化:

class EntropyMax(VariancePreference):
"""phi(n) = -(n+eps) * log(n+eps), 在 n >= 0 上凹"""
eps: float = 1.0
def phi(self, n: int) -> float:
x = float(n) + self.eps
return -x * float(np.log(x))

一个端到端的小例子​

跑一个 700-from-7000 的 PR 选择, 三个 preference:

  • 给 testing tag 的 PR 加 0.3 分
  • 同 repo 选越多边际罚越大 (Quad)
  • 同 repo 14 天内不要共选 (sparse pair)

输出:

objective       : 619.51
dual_bound : 620.95
approx_ratio : 0.9977
factor_breakdown:
_base : +624.71
testing_boost : +18.32
repo_var : -23.52
temporal : 0.00
components_stats: 6841 components, 312 edges

approx_ratio = 0.9977 表明: 真实 OPT 至多比 619.51 高 0.23%。总耗时 ~1.3 秒。

12w样本取1000的测了一下是4分钟左右, 更大的读者可以自己试试看。

总结​

  • 数据筛选可以当作组合优化问题来求解
  • 优化目标可以显式写出来, 而不是嵌在 prompt 或 质量分 model 里
  • 解的质量可以自证, 不需要 baseline 反复对比

如果你也遇到"参数好像调得差不多但说不清"的情况, 不妨照着这篇搓一个, 至少能对解的质量有个数。

迈向真实世界的软件智能体:如何将语义高亮功能融入智能体编程?

· 26 min read
ayanami

引言​

我们训练了一个代码语义高亮模型SWE-Pruner并开源了配套的Agentic接入框架,在真实的Coding Agent多轮任务(SWE-bench, SWE-QA)上,在保持性能不变甚至提升的情况下提供多轮场景下30%甚至更多的token开销减少。该模型基于语义理解,自动识别并高亮检索到的文档中语义相关的句子。而框架作为agentic的接入层,可以轻松接入claude code,openhands等SOTA agent系统

模型发布​

在本文中,我们将分享我们的技术方案。

问题:编码代理的上下文膨胀​

在先前的RAG工作中,上下文的粗粒度膨胀已经是一个很严重的问题 https://huggingface.co/blog/zilliz/zilliz-semantic-highlight-model

在生产环境中的 RAG 系统中,一个典型的查询会检索 10 个文档,每个文档包含数千个词元,每次查询消耗数万个词元。问题在于: 只有几十个句子真正包含相关信息 ,其余的都是噪声,这会增加成本并降低答案质量。

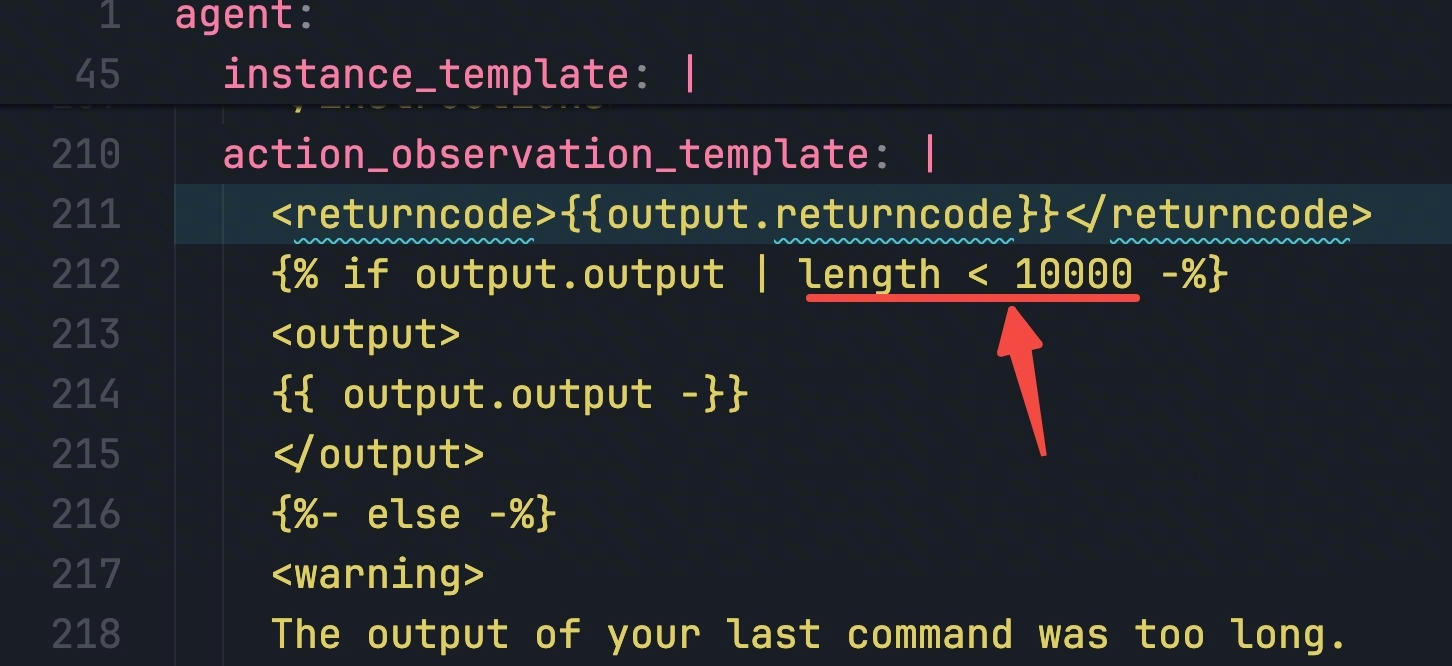
然而,对于真实环境下的软件工程任务,问题甚至更加严重:一个典型的查询可能涉及上百个代码文件,而一些大型项目中,巨型文件的代码token包含的远不止数千个,现代的编程agent却仍然在广泛使用关键词匹配的方法,即grep,来对大型代码仓库进行探索,匹配项的过分庞大使得现代agent中都配备了相当多的上下文硬截断逻辑

image.png

在人工智能代理场景中,这个问题会变得更加严重,因为查询是经过推理和分解后的复杂指令。传统的高亮显示方式只是机械地标记匹配的词语,却会遗漏真正有价值的分析结论。

这就迫切需要一种有针对性的高亮模型,该模型仅保留上下文相关的代码,并高亮显示它们,同时剪掉所有无关的噪声内容——这种技术也被广泛称为上下文剪枝。类似的纯文本任务也被Provence为代表的一系列工作较为完善地解决,但对于究竟如何在代码任务上引入语义高亮模型,社区尚未给出一个答案。

现有模型的困境​

我们调研了现有的解决方案,但发现它们并不完全符合我们的需求。

Provence/XProvence,OpenProvence,zilliz/semantic-highlight-bilingual-v1沿用Provence的思路继续优化Provence的上下文长度和多语言性能。然而,它们并没有指出在代码等非纯文本场景下,如何构造合理的粗细粒度,如何满足额外的AST约束等。

arxiv-provence-paper

另一个困境是,现有的模型沿用BGE的类BERT管道,但大部分现代代码嵌入模型都是LLM架构,decoder-only的模型如何设计裁剪头来处理特征的交互和输出的合理性仍是一个待解决的问题——BERT自然双向注意,但decoder模型需要某些“代偿”因果掩码单向注意的方案。

我们的选择​

既然市面上没有这样的代码剪枝模型,那我们自己训练一个

第一个问题是在代码中,如何将纯文本里面的细粒度“句子”转换成代码的对应概念?

我们提出两套方案,基于代码行和基于AST statements,鉴于数据的生产难度,我们选择了以行取代句子作为细粒度

第二个问题是,选择什么样的模型?

BGE-m3是非常好的模型,但它没有针对代码数据进行大规模预训练;BAAI的另一个优秀模型是BGE-Code-v1,但社区对它的适配相对较少

我们注意到了社区的另一个工作modernbert,然而出于数据分布或是模型表达能力等原因,我们并没有在这个模型上训练成功

我们的猜想是——代码任务对基础模型的能力提出了可能超越大部分旧BERT模型的要求

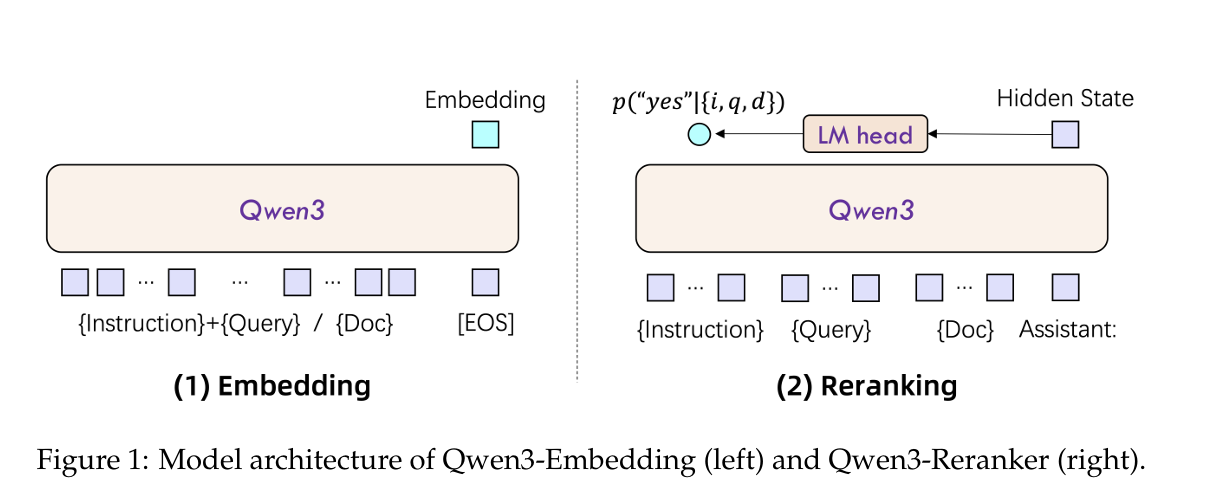
最后我们采用的是Qwen的新模型,Qwen/Qwen3-Reranker-0.6B, 它的海量预训练数据和世界知识产生了相当好的代码嵌入,0.6B的大小又和传统bert类模型开销接近,LLM模型作为基底的另一个好处是自然完成了多语言query的适配。

类似Qwen这种LLM based reranker依然采用Casual Mask,这对token打分实际造成了一些影响,添加一个Full self-attention模块能让模型在测试集上的F1上升接近0.1

我们实验了不同的架构设计和特征trick,发现几个训练技巧对这个任务比较好用:

  • 冻结大部分层:我们发现只解冻最后两层和全参数微调差距极小,而冻结之后更能避免过拟合,训练速度也更快
  • 特征融合:对于LLM不同层数的特征作用,在先前已经有了相当多的工作进行讨论,一般认为浅层会有更多的语法信息,而深层则更重语义,将浅层、中间层和深层做简单的concat接入下游即可显著提升token打分头性能(我们使用的是7, 14和28层)
  • Sample Loss Norm: 代码片段的长短有着很大的差别,更关键的是,与文本领域大部分的信息都是稀疏不同,保留的代码行既有稀疏的片段(大部分行被删除)、又有稠密的片段(大部分行被保留),且长度上也有比较大的区别。如果简单在token level计算,模型训练相对不稳定,将每一个样本的loss使用样本的长度归一化能更好的平衡长短样本
  • CRF Layer:我们特殊设计了Token打分头的模型结构,使用CRF层进行序列建模,取代BERT风格的mlp层,实验证明对于改进模型的稳定性有一定帮助

模型架构&训练​

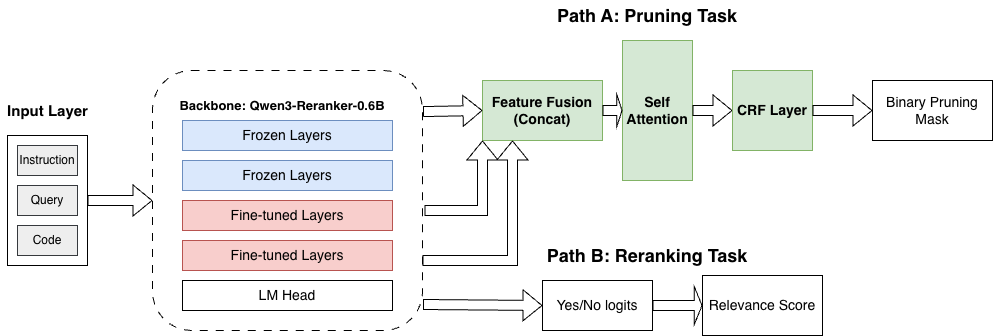
我们设计了一个如下图的模型架构,它在思路上借鉴了Provence,但细节做了大量改动

image.png

此外,我们使用了和Provence相同的做法保留了基础模型的原始rerank头, 即图中的Path B,这种Rerank-While-Prune的方式进一步降低了在RAG管道等场景接入模型的成本。

最终,我们使用8 * H100 训练了3个epoch,用时大约是4个小时。

我们的具体训练超参数可以在论文中找到。

推理过程:​

推理过程非常直接:

  1. 将输入拼接为 指令 + 查询 + 代码
  2. 对上下文中的每个 token 进行打分(范围在 0 到 1 之间)
  3. 对每行内所有 token 的得分取平均,得到该行的得分
  4. 根据阈值保留得分高的行,同时移除得分低的行

一个有趣的细节是阈值的选择,在Provence的开源模型之中,他们推荐将threshold设置为0.1来保守裁剪;而我们阈值调优实验发现,和训练保持一致的0.5阈值就能在下游任务中达到最佳性能,而0.1似乎过于保守——0.3已经会保留非常多的部分,这也可能是代码数据的分布特点和文本不同所导致的,在下文中会详细说明。

训练数据:如何构造“部分相关”的查询-代码对?​

我们使用Qwen-Coder-30B-A3B-Instruct,从github 2025年的新仓库上自行构建数据(再次感谢qwen团队的优秀工作!),在来自6k个仓库、19w个文件的20w条代码片段上,使用了9个种子任务构建数据,并使用Qwen3-Next-80B-A3B-Thinking进行质量筛选,最后得到了约5万条高质量“部分关联query code对”

为什么是“部分相关”?​

与文本领域不同的是,代码领域的QA数据集相对较少,缺少类似ms macro这样规模的query,code对;另一个问题是,由于缺少搜索引擎商开源的数据,现有的code query数据集的query往往分布偏窄,常是“这个函数的功能是什么?”“这段代码的运行结果是什么?”这种与整段代码相关的查询

但我们想要在代码之中引入semantic highlight功能,需要的是对“部分代码”的查询,例如,“这一条if分支会产出什么结果?” “这个类的属性A的作用是什么?”,这样我们才能划分出highlight的部分

也就是说,我们最后的数据集格式会是类似 <查询,原始代码,highlight部分> 的三元组

如何保证数据质量​

数据质量直接决定了最后模型的性能,乃至训练是否能够成功。我们采用了以下几种方法来提升数据质量和解决实际遇到的问题。

  • 问题:模型产出的query同质化比较严重
    • 解法:定义代码重构、代码debug、代码解释等9个种子任务,构建时随机抽取,让模型根据种子任务写短/中/长不同长度,不同相关程度的查询
  • 问题:代码片段太短,较难从中捕捉不同的执行流分支;代码片段太长,行数会变得过多(相比于Provence大部分段落在5-10个句子的情况,我们的代码段取的大约是100-150行)
    • 解法:让模型使用range格式表示最终的“相关片段”,即1,4-10,16-28这样的区间,来避免模型陷入不断输出下一个数字的坏情况
  • 问题:模型会认为大部分代码行都和query “有点关系”,相关度难以量化
    • 解法:借鉴Provence的prompt设计,让模型仅根据提供的代码片段回答query,并要求引用,仅将回答中引用到的片段视为相关部分
  • 问题:由于行数过多还是会出现一些bad case
    • 解法:将构建的数据集使用Qwen3-Next-80B-A3B-Thinking筛选,判断其在代码结构保留程度,query质量和相关性质量上的表现。代码结构的筛选也是我们的方法在裁剪后AST正确率上领先其他方法的重要基础,在编程语言这种高度结构化的文本中,缺少一个 : 或 } 都会导致整个语法树崩溃。

      压缩方法AST 语法正确率 (%)
      无压缩 (Full Context)98.5
      Token 级压缩 (如 LLMLingua2)0.29
      Function RAG92.3
      Pruner + Function RAG87.3

为什么选择这些模型/数据集?​

我们认为,github的原始代码最能够保证和真实用户数据的分布接近,同时具备足够的、真实场景的多样性

使用Qwen-Coder-30B-A3B-Instruct有以下几个原因:

  • 性能稳定,我们抽取了部分样例人工校验模型认为的“相关代码”是否符合人类的观点,它的符合程度相当高
  • 速度非常快——我们使用vllm的offline推理模式在24h左右的时间,8 * H100机器上完成了20万条数据的构建和筛选;而对应的GLM-Z1-32B等dense模型则需要一周

而使用Qwen3-Next-80B-A3B-Thinking则是在含有思维链情况下平衡速度和质量的一个优解

评估1:单轮任务​

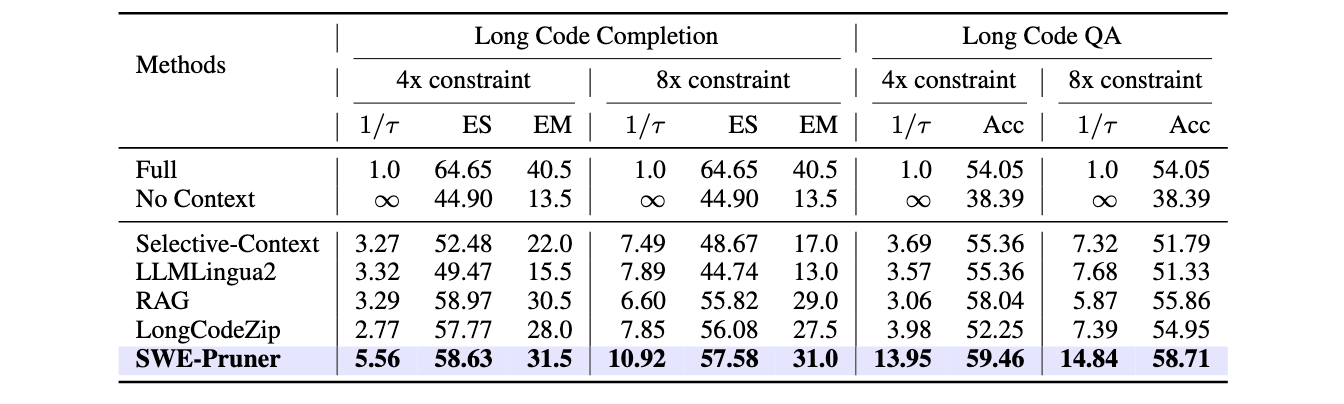
我们在多个数据集上对比了不同模型的性能,包括:

  • LongCodeQA
  • LongCodeCompletion

评估的方法包括 我们的模型, RAG, LLMlingua2, selective context, LongCodeZip 等, 实验中swe-pruner的压缩率向下取整,其他方法的压缩率向上取整(实在难调平)

image.png

主要发现:

  • 上下文噪声的去除不会影响QA的性能,甚至可能因为噪声的去除有所提升
  • 我们的模型在压缩率上要远远超出其他方法 —— 事实上为了调整不同方法的压缩率到近似可比,我们花了非常大的力气调整超参数
  • 我们的模型取得了所有压缩率下的SOTA

还有一个有趣的发现是,以Qwen3-Reranker-0.6B这种LLM based reranker作为基底,它的自定义instruction能力让下游任务的泛化更加轻松了。例如代码补全任务的query是上一行代码行而不是自然语言文字,这对于大部分模型其实是难以理解的,但我们可以在instruction中描述补全任务,使得模型在训练相对少的补全任务上性能也相当不错。

智能体服务:不止于 RAG​

在构建了这样的模型之后,我们回到了我们的初始想法,如何将其融合到现代的Code Agent呢?虽然CodeRAG也是很广泛的范式,但也有相当多Agent是使用Grep作为搜索的工具,比如我们用得最多的Claude Code

更进一步的,会令上下文爆炸的,其实很多时候是ReadFile而不是Grep,我们想要削减上下文的开销的话,应该也对ReadFile处理好冗余上下文的问题

所以,我们设计了一个最小侵入的highlight模型接入方式,它不仅能服务于CodeRAG,还能服务于Grep, ReadFile乃至任何阅读工具

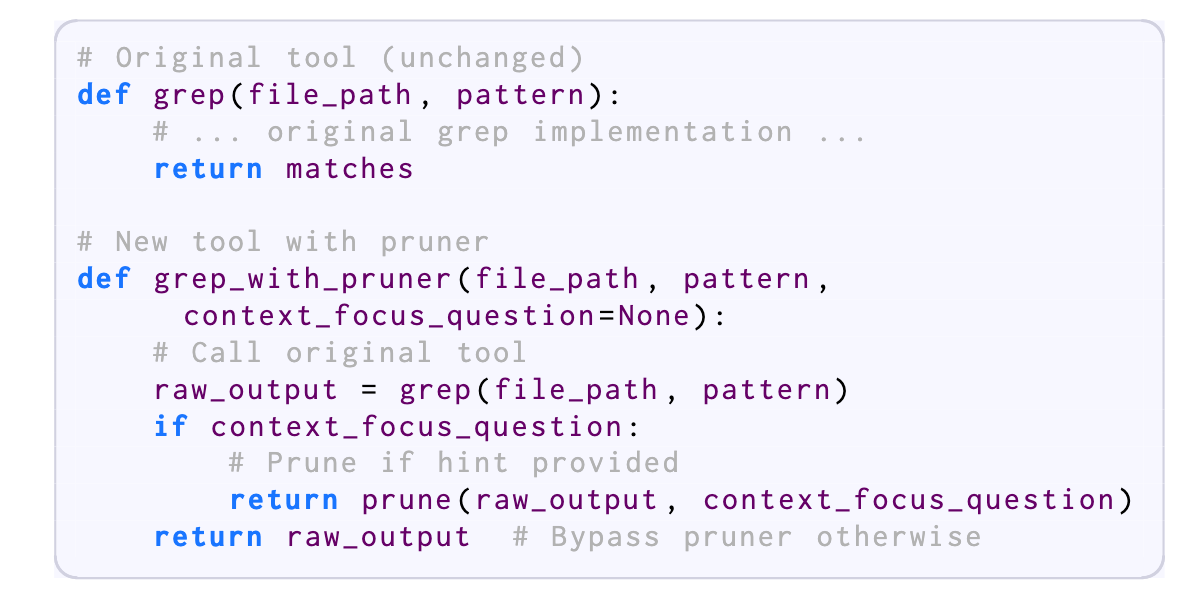
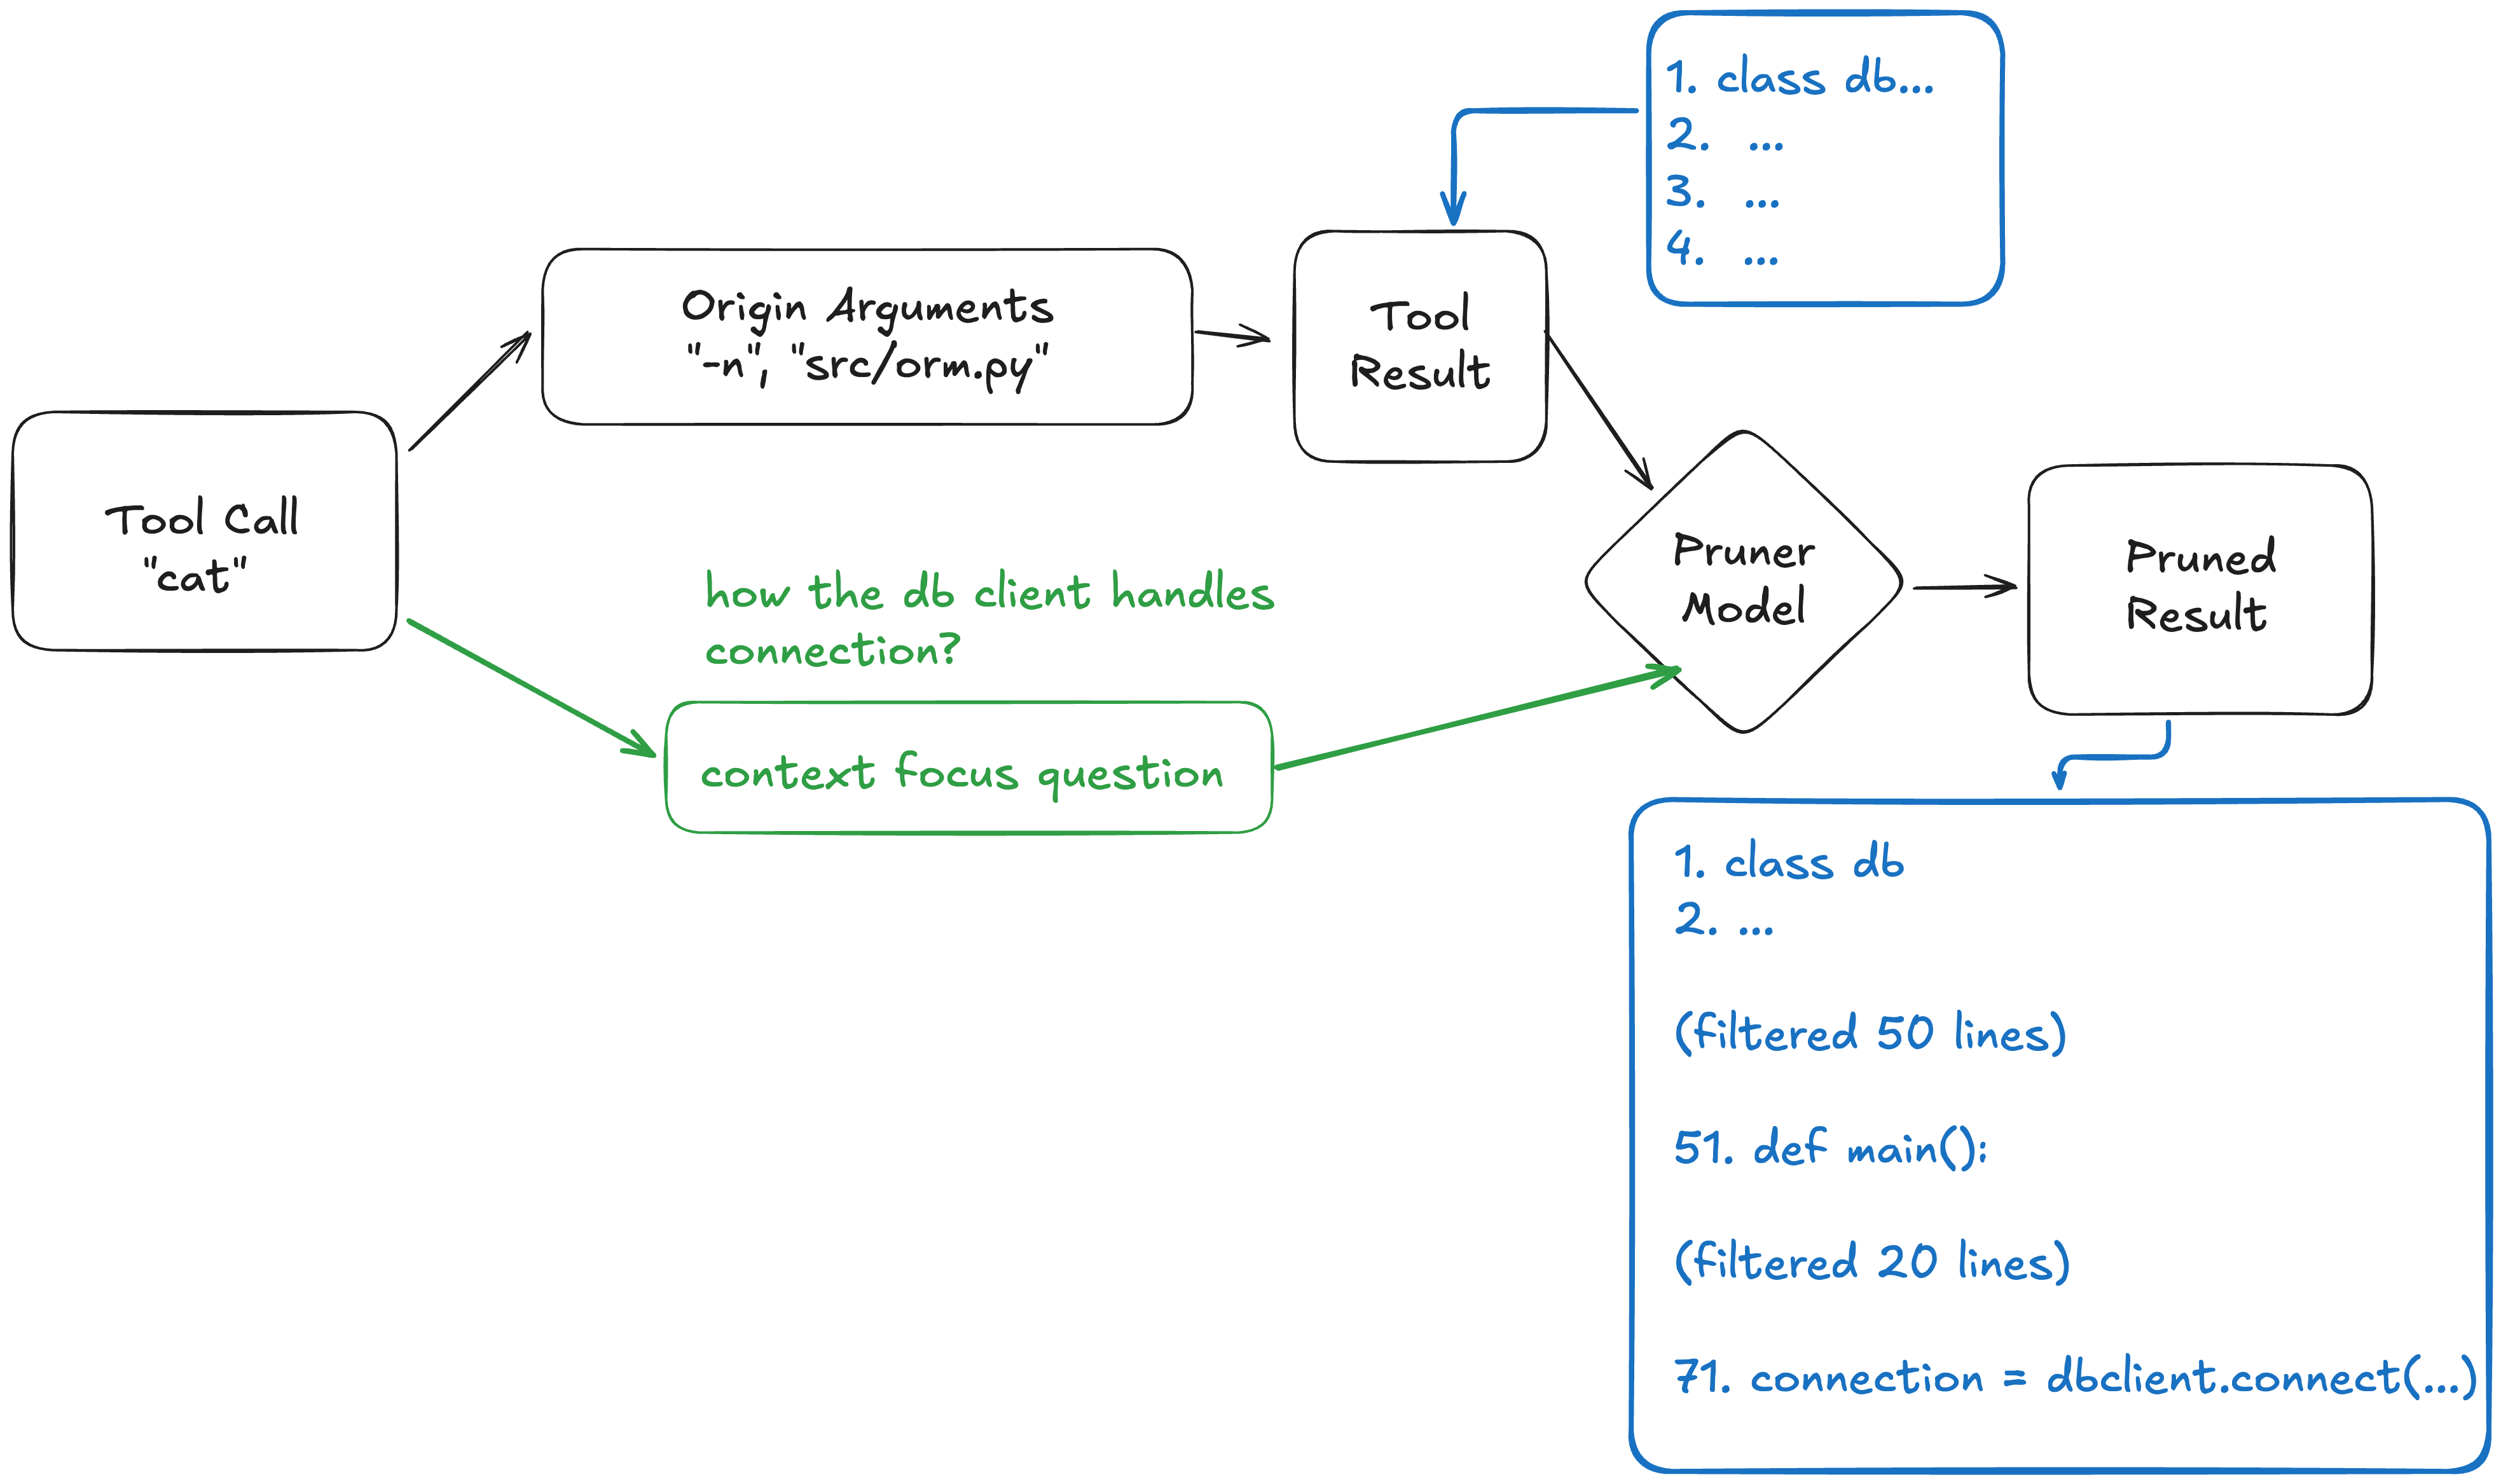
具体的做法是,假设有一个工具A,会产生一些输出,现在在工具A的原始参数基础上,增加一个参数context focus question,SWE-Pruner就可以根据这个question对A的输出进行裁剪 —— 而A可以是cat, grep, rag search, 甚至像是我们论文之中更暴力的bash

image.png

image.png

Agent模型负责根据当前运行的需要产生question, 甚至不产生question(留空则不进行裁剪),让整个系统留下了更多的灵活性和随基础模型成长的可能——在我们的实验之中,我们确实看到了顶尖的模型会评估自己当前的需求、预估命令输出的长度,从而灵活地选择简单或是复杂的 question,又或是不使用question来保证关键命令的输出完整性

这种仅对工具做包装的方法保留了最大的兼容性,我们实现了claude code sdk和openhands sdk等框架的兼容示例,可以在 https://github.com/Ayanami1314/swe-pruner/blob/public/examples/README.md 中找到

评估2:多轮任务​

我们使用SWE Bench Verified和SWE-QA两个benchmark来评估这套方案的agentic能力,并在claude-sonnet-4.5和glm-4.6上做了实现,接入mini-swe-agent进行测试,结果也是比较喜人的——不仅明显地节约了token的开销,并且在正确率上能打平甚至微升(sweqa, sonnet)

我们也针对不同的方法再次进行了消融对比,即使不考虑速率的因素,我们的方法也比简单的大模型总结更加优秀——代码是一个相当难总结的形式。

真实场景案例研究:精准识别核心语句​

除了基准分数之外,让我们来看几个更有趣的例子,以直观地展示我们的模型在实际应用中的性能。

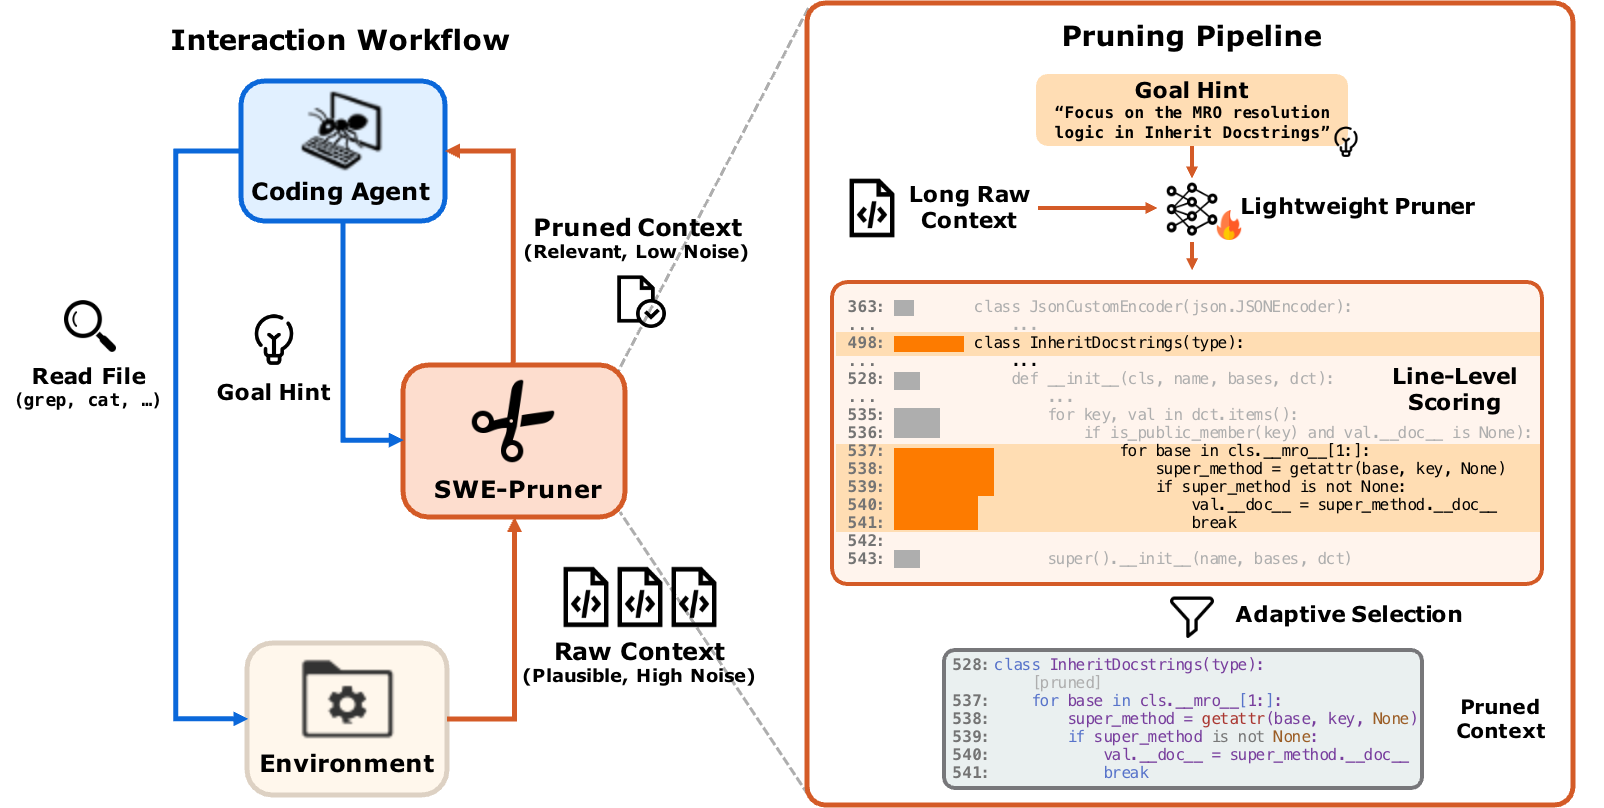
模型在查看文件时,使用了 Focus on the MRO resolution logic in Inherit Docstring 作为context focus question,而SWE-Pruner在大量代码中精准定位到了高亮逻辑 —— Docstring的类定义,mro的部分代码逻辑

image.png

另一个例子来自SWE-bench的 django__django-10554 问题,Baseline 智能体和搭载了 Pruner 的智能体表现出了截然不同的行为模式:

配置方案运行步数读取操作搜索操作编辑操作Token 总消耗
Baseline1645939257,001,934
Pruner562010111,170,160
  • 传统的 Baseline 智能体倾向于采用“广度优先”的搜索策略。它会盲目执行类似 find . -name "*.py" | grep union 的命令,并不断使用 sed 命令在大堆文件中反复读取片段。这种方式虽然覆盖面广,但会导致大量无关紧要的代码进入上下文,最终造成上下文溢出,让智能体在冗余信息中迷失方向。
  • 相比之下,搭载了 Pruner 的智能体表现得像个经验丰富的架构师。它直接定位到核心文件 django/db/models/sql/query.py,通过带行号的 cat -n 进行读取,并迅速锁定了关键代码分支(if self.combinator: ...),避免了 Baseline 的无效试错

站在巨人的肩膀上​

该模型的开发建立在大量前期工作的基础上,我们谨此感谢所有为我们的这项工作做出贡献的人:


  1. Provence的理论基础: 提出了一种有效的训练Rerank-While-Prune模型的方法,即句级打标与双头损失
  2. Qwen团队的优秀模型:Qwen3-Reranker, Qwen3-Coder-30B-A3B-Instruct, Qwen3-Next-80B-A3B-Thinking

在这些基础之上,我们提出了若干创新

  1. 将Provence双头设计首次迁移到Qwen3-Reranker这样的decoder-only LLM上
  2. 从github代码仓库中构建部分相关查询-代码对的数据集的完整管道与数据
  3. 模型结构和训练方法的优化
  4. 实际Agentic系统的接入方法创新,提出了context focus question这一工具包装机制并实验验证

我们诚挚感谢 Provence 团队和 Qwen 团队的奠基性工作。

Conclusion​

在本文中,我们分享了我们从识别生产环境中 Coding Agent 中的上下文成本问题到构建最先进的代码语义高亮模型SWE-Pruner的历程。

SWE-Pruner 填补了粗粒度文件检索与细粒度 Token 压缩之间的空白, 并为代码、多轮的场景引入了一套新式的上下文压缩解决方案,比起对Agent的轨迹进行“事后”压缩,SWE-Pruner强调在“事前”过滤掉无关的代码,从根源上降低Agent在生产环境的token开销和注意力噪声。通过引入任务感知的行级剪枝,我们不仅显著降低了 AI 编码的经济成本,还提高了智能体在复杂代码库中的推理质量。

该框架具有极强的即插即用性,可作为标准中间件集成至 OpenHands,Claude Code 等主流 Agent 框架中,也可以与任意轨迹压缩方案集成,为构建更高效、更具扩展性的 AI 软件工程师提供了新的路径

Future Works & Limitations​

  • 由于我们的算力有限,我们只进行了20万条数据、单语言环境下的迭代,多语言和更大规模数据量的scale或许是将来采用这项技术的团队的命题
  • 在Agent方案之中,模型产出的question质量对实验效果的影响较大,在将来社区如果能对基础模型进行后训练以专门适应包装形式的工具,预计效果仍会出现显著的提升
  • 生产环境的“屎山”代码仓库benchmark较为稀少,swebench等开源代码仓库还是不够“脏”,对于semantic highlight模型的发挥有一定劣势,希望在将来这个方法能被用于更冗长的代码库之中,并对这种极端情况下Agent应该如何工作做出一定参考意义

从现代Coding Agent视角回看代码搜索与嵌入

· 24 min read
ayanami

应该如何说起代码搜索呢,先说代码搜索的几个小的子流派吧,这方面可能略微和其他领域不同

代码的检索我认为是可以分解成以下几种的:

  • 搜索引擎式
  • grep传统搜
  • 向量embedding搜
  • 码仓index

每一种都是什么意思呢,举个例子

搜索引擎式是复用传统的搜索引擎,如elasticsearch, meilisearch等;也有一些变体,比如github的代码搜索,主要是弥补传统搜索引擎在代码搜索的不足

grep如其名字,基于linux grep或者riggrep,在agent内使用最广

向量embedding搜则有多个子任务,如NL2Code, Code2Code, Code2NL等,每个还有一些细微差别,这个很有意思,待会讲;

码仓index呢,则大致有两种:一种基于传统的AST分析,希望构建整个码仓的符号树或者CKG来辅助搜,另一种则寄希望于新型的生成式大模型,希望让LLM读了仓库之后能生成”索引“,典型的做法比如deepwiki。

搜索引擎式​

传统的搜索引擎其实在代码搜上有很多问题,参见

https://github.blog/engineering/architecture-optimization/the-technology-behind-githubs-new-code-search/

最严重的问题甚至不是想象的NL2Code的问题,而是传统搜索引擎的部分优化不够、部分优化又不足,总之不与代码适配

  1. 索引的开销, 恐怖的内存消耗

当我们第一次部署 Elasticsearch 时,需要几个月的时间才能索引 GitHub 上的所有代码(当时大约有 800 万个存储库)。今天,这个数字已经超过 2 亿,而且代码不是静态的:它不断变化,这对搜索引擎来说是相当具有挑战性的。

  1. 可不可以不要索引?对大规模库高并发是不可能的:

首先,让我们探讨一下解决问题的蛮力方法。我们经常收到这样的问题:“你为什么不直接使用 grep?为了回答这个问题,让我们使用 ripgrep 对这 115 TB 的内容进行一些数学计算。在具有八核 Intel CPU 的机器上,ripgrep 可以在 2.769 秒内对缓存在内存中的 13 GB 文件运行详尽的正则表达式查询 ,即大约 0.6 GB/秒/内核。 我们很快就会发现,这对于我们拥有的大量数据来说确实不起作用。代码搜索在 64 个核心、32 个机器集群上运行。即使我们设法将 115 TB 的代码放入内存中并假设我们可以完美并行化工作,我们也会在 96 秒内使 2,048 个 CPU 内核饱和,以处理单个查询!只能运行一个查询。其他人都必须排队。结果是每秒 0.01 次查询

  1. 分词器不需要了:搜索引擎依赖分词来减少构建倒排的成本和作为基础搜索单元,但就和Tokenizer的引入一样,这个开销的减少从来不是免费的,接下来的问题就是:代码如何分词?另一个问题是:停用词全部没用了!无论是!@?/#$:{}()[]还是什么别的乱七八糟的符号,都是编程语言的最爱, 这使得传统的分词系统更加雪上加霜

    1. 如果提前跑一遍AST分析呢?我们的CPU要算爆炸了:), 并且你如何统一没有LSP小众语言,不同的语法版本(py2->3)... 工程量立刻爆炸了
    2. 能不能在char level倒排?太爆炸了索引,所以github是使用3-char的倒排的 argument -> arg、rgu、gum、...
    3. 代码里面还有注释,注释还有多语言,甚至单个仓库都很常见中英两种语言的注释...看起来朴素的分词器比如jieba要全面阵亡了...
  2. 基于git的增量更新:增量更新本身可以用merkel tree,这也是cursor在用的技术,但结合git版本?你发现事情变得复杂起来了,这是纯工程的复杂性。一次git commit涉及到十几个文件的几行变化,需要触发至少十几个chunk的embedding更新?如何处理多分支呢?我的每一个存储代码块是否还得加一个tag标识它的branch,然后在搜索引擎里面支持完备地按tag过滤,省的不同branch的代码在同一个搜索引擎中返回?(然后发现branch name作为tag简直太烂了,它是一个完全动态的无限的集合)

鉴于恐怖的存储代码数量,github采用的搜索引擎相当简陋,甚至是弱化版本的完全匹配:3-grams索引

对于代码搜索,我们需要一种特殊类型的倒排索引,称为 ngram 索引,它对于查找内容的子字符串很有用。ngram 是长度为 n 的字符序列。例如,如果我们选择 n=3,则构成内容“limits”的 ngram 是 lim、imi、mit、its。(二元组的选择性不够,四元组占用了太多空间)

这个索引显然是非常大无法放入内存的,所以github采用了一些传统数据库里面的懒加载和流式优化技术,使得可以仅读取一个小子集完成搜索

而关于构建索引本身,github还有很多特殊设计,但这其实属于system/后端任务了,不细讲:

  • 用Git blob object ID来分片,kafka分区

  • 用path, branch, repository + 元信息(owner, visibility, etc.) 来构建增量索引key

  • commit-level的一致性

  • Github相当多的blob是相同的,使用增量编码很有吸引力, 这里用到了概率上的近似数据结构和一些分布式图(近似)算法

    To determine the optimal ingest order, we need a way to tell how similar one repository is to another (similar in terms of their content), so we invented a new probabilistic data structure to do this in the same class of data structures as MinHash and HyperLogLog. This data structure, which we call a geometric filter, allows computing set similarity and the symmetric difference between sets with logarithmic space. In this case, the sets we’re comparing are the contents of each repository as represented by (path, blob_sha) tuples. Armed with that knowledge, we can construct a graph where the vertices are repositories and edges are weighted with this similarity metric. Calculating a minimum spanning tree of this graph (with similarity as cost) and then doing a level order traversal of the tree gives us an ingest order where we can make best use of delta encoding. Really though, this graph is enormous (millions of nodes, trillions of edges), so our MST algorithm computes an approximation that only takes a few minutes to calculate and provides 90% of the delta compression benefits we’re going for.


Grep​

grep属实是在Coding Agent时代焕发了第二春,由于其系统级别自带+完美匹配Bash工具和Unix文本管道的特性,在现代的LLM之中都大量训练了如何写出各种米奇妙妙grep的数据

claude code这种经过更多优化的grep会更过分一点,它会有几个细节优化:

  • 使用更现代的rg(riggrep)代替原始的grep
  • 逆向cc源码可知,它的grep有七八个参数,分别对应grep里面的不同参数比如 -A -E -C , 除了一些呈现格式(比如带不带行号和文件名)之类的差别,主要的几个参数就是在匹配行前保留多少行、匹配行后保留多少行、和上下保留多少行
    • 如果读者熟悉coding agent的工作的话,其实早在swe-agent就已经探究过这个context window开多少的问题,原始论文的实验结论是50行
❯ tldr grep
grep
Find patterns in files using regular expressions.More information: https://www.gnu.org/software/grep/manual/grep.html.

- Search for a pattern within a file:
grep "{{search_pattern}}" {{path/to/file}}

- Search for an exact string (disables regular expressions):
grep {{[-F|--fixed-strings]}} "{{exact_string}}" {{path/to/file}}

- Search for a pattern in all files recursively in a directory, showing line numbers of matches, ignoring binary files:
grep {{[-r|--recursive]}} {{[-n|--line-number]}} --binary-files {{without-match}} "{{search_pattern}}" {{path/to/directory}}

- Use extended regular expressions (supports ?, +, {}, (), and |), in case-insensitive mode:
grep {{[-E|--extended-regexp]}} {{[-i|--ignore-case]}} "{{search_pattern}}" {{path/to/file}}

- Print 3 lines of [C]ontext around, [B]efore or [A]fter each match:
grep --{{context|before-context|after-context}} 3 "{{search_pattern}}" {{path/to/file}}

- Print file name and line number for each match with color output:
grep {{[-H|--with-filename]}} {{[-n|--line-number]}} --color=always "{{search_pattern}}" {{path/to/file}}

- Search for lines matching a pattern, printing only the matched text:
grep {{[-o|--only-matching]}} "{{search_pattern}}" {{path/to/file}}

- Search stdin for lines that do not match a pattern:
cat {{path/to/file}} | grep {{[-v|--invert-match]}} "{{search_pattern}}"

另一个有趣的事情是,现在的coding agent不约而同地使用了grep而不是rag作为其系统原生的工具,我觉得理由也是非常清晰的:

  1. grep的输出是标准可预测的,而rag的输出依赖于 {基础模型, 分块方法,召回topk,重排模型} 等多个配置参数,一个标准的输出带来的好处是 可强化学习, 如果对一个 code llm + rag 的系统做RL,最后的搜索策略一定会是拟合到和rag的embedding模型和具体策略相匹配,丧失了可迁移性
  2. 除此之外的好处也有很多,比如RL环境不需要embedding的额外开销(存储和计算上甚至编码成本上),整体轨迹可解释,精确匹配效果好,速度快...

rag的index开销其实相当大,学界不在乎这个,为了提升精度每个token一个embedding的方法也有,但一个embedding是一个1024维的向量,光存储开销就是4KB,对于百万行级别的代码仓库,其chunk可能在数万,达到了GB级别的存储开销

而工业项目有百万码仓,在TB级别的存储上进行高效地索引和查询着实压力很大,可以参考 美团和milvus/lancedb的相关文章 ,索引优化也有相当多的新实践,但这是做DB的人考虑的(雾

但Grep就是万灵药吗?并非如此

Grep提供了一个切面,能够让模型Agentic Search,根据搜索到的局部反馈调整搜索方法,从部分开始探索整个代码仓库——大部分需求的完成不需要对全仓的理解

——吗?

一个Grep的bad case是高阶语义的需求:

  • 哪里导致了这个bug?
  • 某个模块的核心逻辑是什么?
  • 整体的代码结构?
  • ...

模型要么老实cat,要么就只能在log中见到它尝试“猜”你的变量名字,比如你问“...的实现”就会开始Grep impl,如果你把所有变量换成abcde,它立刻就GG了

比起失败的搜索浪费的上下文更糟地是浪费的交互轮数 —— 长达几百轮的agent轨迹是相当稀少的训练数据,如果再配合没那么好的历史压缩方法,或是没有精心设计的防止模型死循环的额外环境反馈,连续失败的grep会让agent的性能迅速地劣化

基于这方面的需求,在推理阶段Grep还是得配合别的工具,比如deepwiki,比如CKG(代码知识图谱,例如每个函数的caller和callee),

比如Code RAG

这方面也有一些新的探索,例如 https://cognition.ai/blog/swe-grep 的RL并行工具调用(关键不在速度,关键在减少交互轮数!),比如在工程侧融合Grep和RAG如https://github.com/daimh/mgrep 和 https://github.com/zilliztech/claude-context ,以及我们将要发的一篇文章(自吹自擂一下,关注主包后续的工作谢谢喵)


code embedding​

主包主包,code embedding和文本的embedding有什么区别呢?为什么要强调code?

非常好问题,爱来自AI4SE。我认为code其实和图像比较像,某种意义上算是一种特殊的模态,不完全是文本——code某种意义上是“反语言常理”的,例如大部分语言的上下文有限,一句话很难和1000个字之前的某个东西形成强烈的联系,而这种长程交互在code之中非常常见——甚至有跨文件、跨模块、跨仓库的交互

而另一个很有趣的事情是,当我们在讲“某段代码的语义”的时候,这件事本身是模糊的,文本没有那么强的二义性,太阳就是太阳,月亮就是月亮,但一个递归斐波那契函数的语义到底是 “递归“ 还是 ”斐波那契“?这其实折射出了代码的某种特殊性,它同时具备字面义 ”斐波那契“ 和运行义 ”递归“(甚至”低效“、”算法“、“python”),而在一个代码仓库之中,代码还具备了上下游的属性:谁是我的caller,谁是我的callee?

这件事情为什么重要呢,因为传统的embedding向量相似度产出的是一个标量,它只能衡量一个维度的相似性!

  • 当你在说“查找与function A相关的代码”时,你想要的到底是什么?
    • function A的字面义相关的代码?
    • function A的运行效果相关的代码?
    • function A的caller/callee?
    • ...

然后你就发现从这个角度上来说,Code2Code的向量搜是很诡异的一件事情,至少传统的cos相似度无法干这件事——

  • 更悲伤(从学术研究的角度上来说或许是兴奋)的是,在现实需求中,我们真的不在意找到和一个function的字面意相关的function...假设你想要补全一段代码,你可能更需要关注谁会是它的caller,假设你需要优化一段代码,你可能搜索的方法是某种低效的pattern...而这些embedding相似度全部做不到
    • 据我所知,企业对这个接近摆烂了,只有MSRA有一个group还在研究,我之前溯源到的比较早的上下游建模技术是Order Embedding,感兴趣的或许可以试试做

直接结果是:我们只有NL2Code了

并且这个NL也只能关注一个方面...

什么样的NL才是真实会问会写的NL呢?Coding Agent的轨迹数据

没有轨迹数据怎么办?从大规模代码中挖掘注释作为NL

一个人写注释的方法和提问的方法不一样,这个语义空间的unmatch如何处理?各家自显神通

  • 例如2025年5月快手的OASIS: Order-Augmented Strategy for Improved Code Search,认为现有的code embedding往往关注的是代码的字面相似性,即只把代码认为是一种特殊的“语言”,而忽略了代码的非文字意义上的相似性

    • 对代码片段(结合其他静态分析信息),用LLM产生其作用的描述文本
    • 计算这个描述文本和其他代码片段的相似性,以此来挖掘难负样本
    • 因为这个文本描述的是相对High Level的函数作用,能够一定程度上避免变量名字等带来的影响,专注于实际作用
  • 24年12月的Nomic AI的cornstack

    • 强调<文档,代码>对的相关性重要性,并采用双重过滤:如果文档与代码间相似度低,或者并不在topK,只要有一个满足就筛掉
    • 动态硬负例挖掘策略:对于批内负样本挖掘,采用softmax概率采样,但是在训练过程中,逐步改变softmax的温度,前期温度高提高多样性,后期温度低,注重难负样本的区分
  • 25年5月的BAAI Towards A Generalist Code Embedding Model Based On Massive Data Synthesis

    • 强调退火训练,第一阶段纯文本,第二阶段全数据训练text-code能力,第三阶段纯代码

码仓Index - DeepWiki/CKG​

这个说起来就比较简单了,deepwiki重要的始终是LLM的能力,而CKG则是静态分析的质量,开源的tree-sitter固然可用,企业也有一些统一各种语言的私有AST,静态分析已经日趋成熟,困难的是如何将这个信息给到LLM?

很早在Google的博客中就有论述: 现在的vibe coding就像是把一个几千行的代码粘贴到记事本里面,然后让程序员来修改bug —— LLM看到的就是 “记事本”,而不是程序员的带有各种Lint和跳转的IDE界面

AST分析树如此庞大,除了摆烂式地提供一个获取caller/callee的mcp工具给agent之外,还可以做些什么?

先前在web领域有一个llms.txt的旨在LLM-friendly的格式,代码领域却暂时缺乏哪怕是新兴的统一处理格式

AI-friendly IDE可能对于Coding Agent的能力提升相当重要,这也是moonbit社区他们宣传的,不过我没有实际上手用过,也不是学PL的,就不瞎讲了,感兴趣的可以看张宏波的演讲

【AI时代下的基础软件 | 张宏波 刘子悦 蚂蚁&MoonBit Meetup杭州站回放】

https://www.bilibili.com/video/BV1wL8DzgEXZ/

除此之外,可能我们原先认为不能搜索或者没必要搜索的部分,现在也正在发挥着额外的作用:

  • python的package,众所周知(可能并非),pip包只是一个特殊的压缩包,可以直接看到文本格式的原始代码,现代的claude-sonnet-4等模型在环境出错的时候会主动读/搜 pyproject.toml, .venv等特殊文件,遇到import的不了解api还会尝试进入package观看源码
  • 而某些binary风格或是一串神秘哈希引入的包可能对于LLM并不是很友好...

除此之外也有很多新兴的想法,例如注释本身可不可以作为一个天生的码仓Index? ...

CLI版本的Coding Agent好处是可以在各处方便的引用,尤其利于大规模并发采集数据

但IDE版本的Coding Agent则会更加地“懂人”,原因是AI IDE在背后做了一大堆不仅仅是diff等格式渲染的工作,用户环境信息,用户系统信息,... 这些都被从后台塞入了Coding Agent的system prompt,使得你在Linux上运行Copilot的时候,模型不会让你执行 brew install命令

但文本本身依然有着局限,或许在某个未来,我们能看到真正的code native架构,不在绞尽脑汁地想把编译器的报错,AST的分析等等原本结构化的东西转成markdown再塞入永远不够的agent上下文...

paper-reading, code&rl方向

· 27 min read
Tags:
ayanami

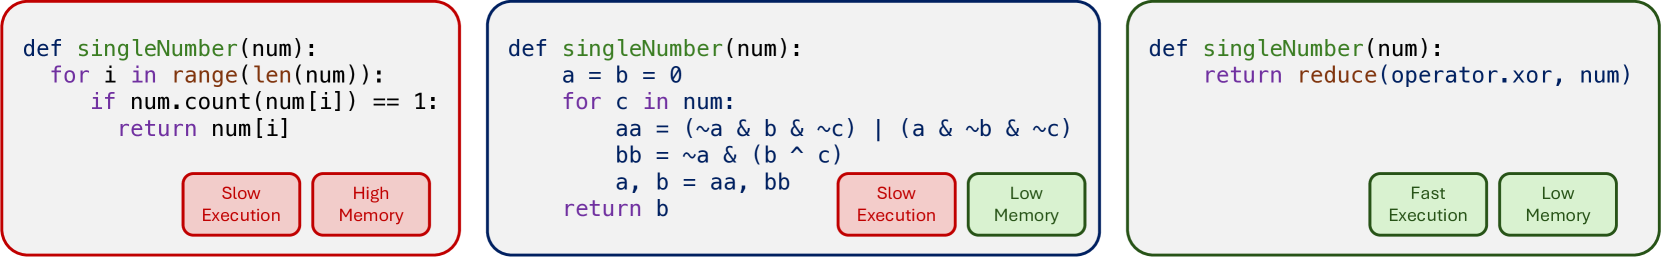
Effi-code: Unleashing code efficiency in language modelsSWIFTCODER: Enhancing Code Generation in Large Language Models through Efficiency-Aware Fine-tuning​

问题:以前的方法主要关注正确性忽略效率(effibench,gpt4 代码执行时间是标准解决方案的1.69与45.49倍(avg, worst))

衡量效率:本地测量执行时间和内存

具体来说是三个指标:

  • 执行时间ET
  • 最大内存使用量MU
  • 总内存使用量TMU

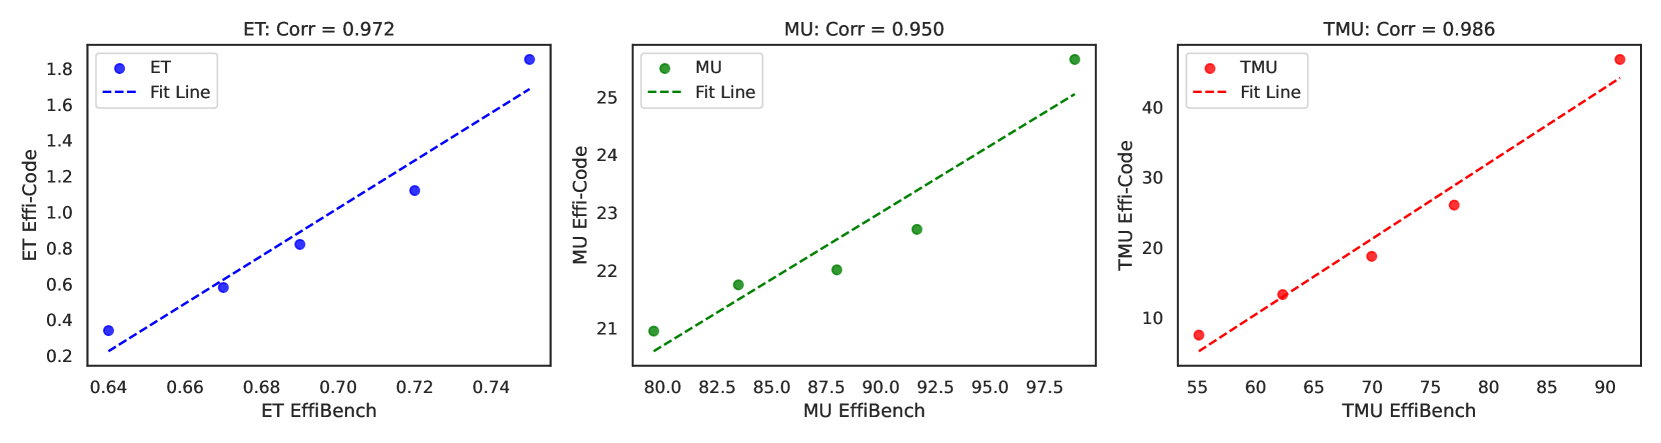
这篇论文并没有用RL的方法去激发LLM生成更高效率代码的能力,而是”优化“训练数据集的代码效率,并证明了训练集代码效率高也会让LLM生成更高效率的代码(ET 的相关性为 0.972,MU 的相关性为 0.950,TMU 的相关性为 0.986)

Refer to caption

效果:qwen2.5-coder-7b-instruct pass@1 44.8 -> 57.7,正确任务的执行时间减少48.4%

方法:构建代码生成数据集,进行微调

Refer to caption

具体来说,先拉下来开源数据集,过滤一遍后,直接让更强的LLM生成更好的解决方案,然后本地跑一遍得到效率

不同效率的代码示例 Refer to caption

文章认为的效果提升来源:

  1. 多语言数据集
  2. 数据准备阶段过滤充分
  3. 数据量(有超过 70,000 个训练示例,比先前的mercury 1.8k要大很多)

简评:大体上感觉是工作量密集型的工作,比如finetune多个llm和在多个数据集上进行相关评测,但方法上并没有创新之感,洗的数据是高效率代码的自然输出的结果效率也会变高,并不令人感觉新奇,只是讲好了我们需要同时看重代码质量(这里是效率)这一指标的故事


EffiBench: Benchmarking the Efficiency of Automatically Generated Code​

问题:现在衡量代码正确性的文章已经有很多了,但是兼顾正确和效率的相对少

如果要考虑效率的话,一个问题是原先的代码数据集的任务太简单了,很难区分效率;同时很多任务也不是效率密集型的,并且效率相关的测试也不够

数据集构建:leetcode

“标准解决方案”: stackoverflow最多star/leetcode top answer

测试用例:LLM生成

简评:典型的benchmark工作


Diversity-Aware Policy Optimization for Large Language Model Reasoning​

问题:diversity在reasoning能力中扮演重要角色,但缺乏定量的研究

动机:传统RL认为,多样性有助于策略探索(例如,SAC等算法),帮助跳出局部最优、加速训练收敛,但对于LLM呢?

方法:

直接增加熵,长度bias, 较长的响应 -> 引入token level diversity

tradeoff 质量和多样性 -> 仅对正样本用多样性增强,确保以性能标准为主导

贡献:

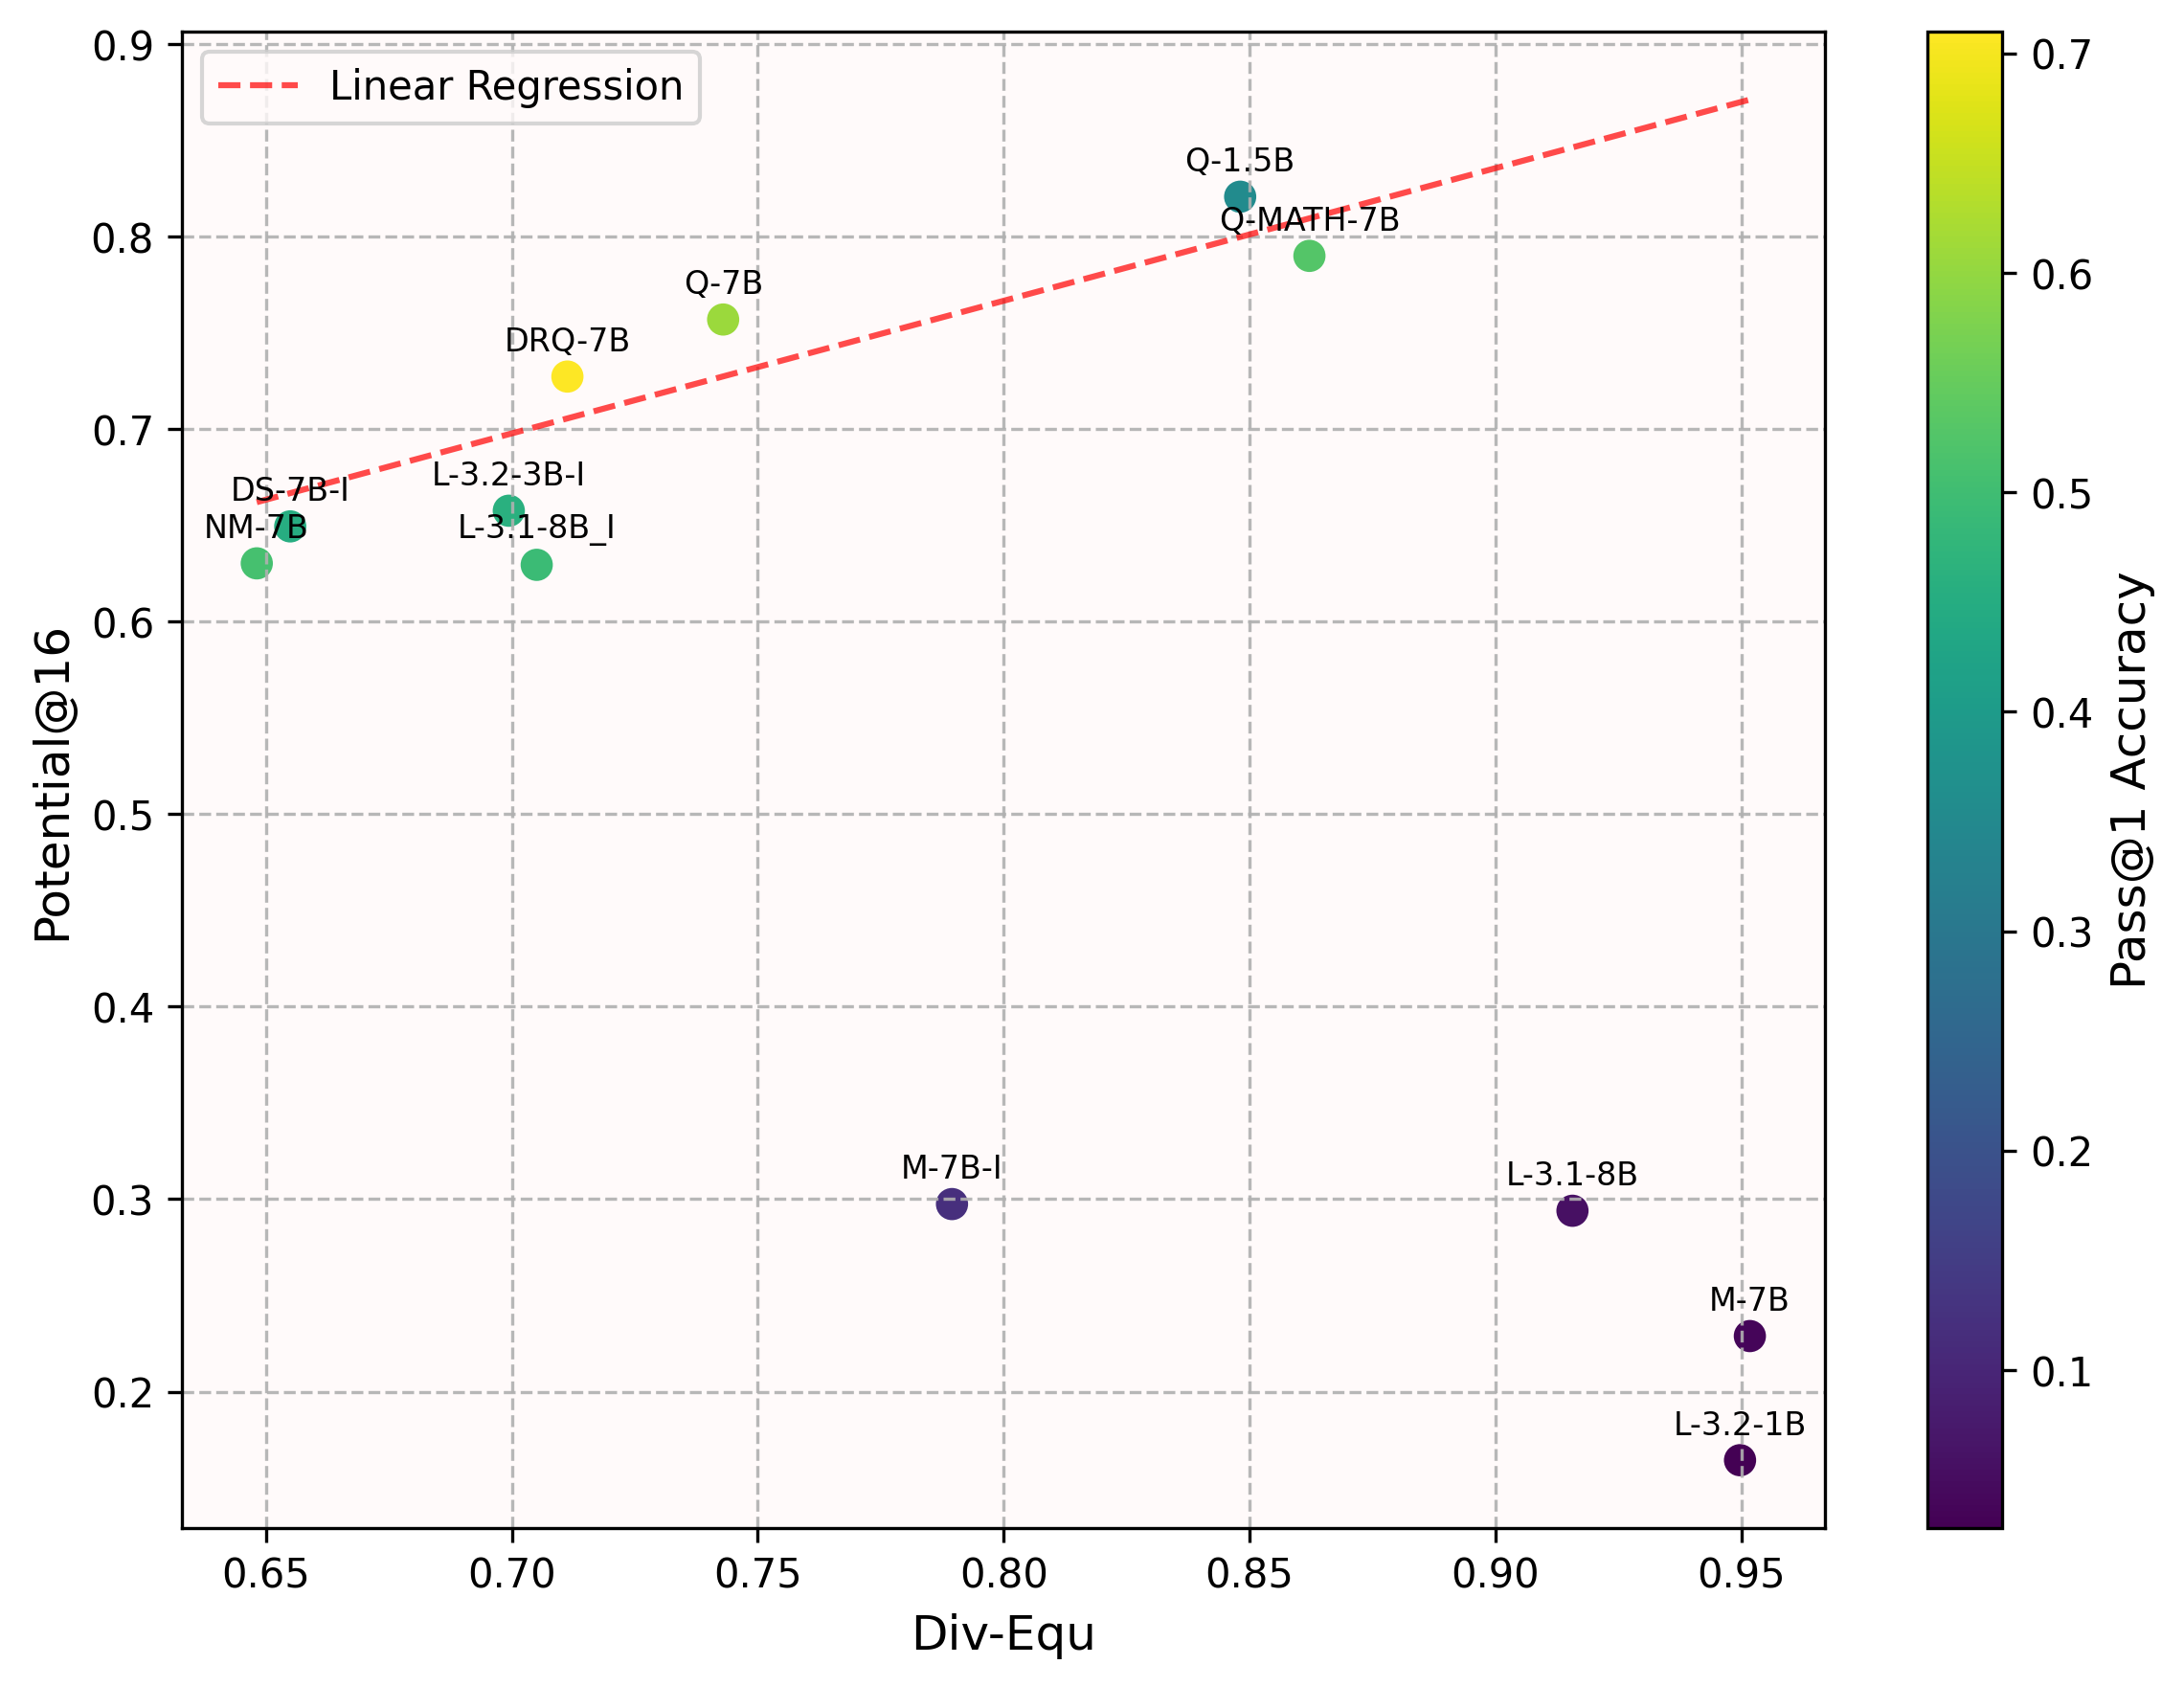
  • 多样性的Potential@k指标和LLM reasoning存在正相关关系
  • token-level diversity objective, selectively applied to positive samples

奖励:和R1一致,acc reward和format reward,前者和ground truth 比较,后者让答案以 \boxed{}格式呈现

多样性度量:response中不同方程的比例

DivEqu:=1N∑kUADivEqu := \frac{1}{N} \sum_k \frac{U}{A}

其中,U是k个采样中的独立方程数量,A是总方程数量

Potential@k: 衡量模型在第一次失败后,在k次(k=16 in paper)内纠正答案的能力

Potential@k:=∑Pass@k(1−Pass@1)∑1−Pass@1Potential@k := \frac{\sum Pass@k (1 - Pass@1)}{ \sum 1 - Pass@1}

(为啥定义这样一个指标?这个分子分母分别求和挺怪异的,也不是类似条件概率的算法)

结果:对于推理能力有限的LLM(Pass@1<0.4) 多样性和Potential@k没什么关系,但对于更好的LLM,就有明显的正相关关系

Refer to caption

定义的token-level熵

image-20250817161107663

在实测中,作者发现直接把这个熵带入训练会增强错误样本的多样性,相当于对错误样本做增强,因此打了只对正样本做的补丁

image-20250817161240377

而对这个式子求导能直观感受到多样性的部分

image-20250817161427155

对于大多数token, 采样概率π\pi的值都是小于e−1e^{-1}的,则前一个乘项小于0 ,熵的梯度和采样概率的梯度成正相关,熵增有利于对稀有Token的采样

image-20250817161718666

实际取 λ=0.01\lambda=0.01

简评:

动机非常清晰,实验也比较充分,展示了虽然是 well-known 的需要基模能力达标多样性才有意义的结论。

对于LLM优化目标的改造的说明是合理的。理论说法是GRPO带来的更新依赖于组内样本的差异,(因为是用std/mean来计算优势函数A),所以增强多样性能避免优势消失带来的一些问题,本质上是在避免 r−meanstd\frac{r - mean}{std} 里面的stdstd 过小导致不稳定的问题

只对正样本应用多样性损失的trick也是有意义的。

但衡量多样性的时候比较草率,首先是局限在数学范围,其次感觉 方程多样性 != 解法多样性,所以多样性指标总感觉欠说服力。

他们自己也在文章中说:"许多现实世界的应用需要用户意图的多样性(例如,需要数学问题的代数和算术解,或者生成具有不同算法方法的代码), 这样的多样性不等于token level的多样性"


Beyond the 80/20 Rule: High-Entropy Minority Tokens Drive Effective Reinforcement Learning for LLM Reasoning​

Refer to caption

问题: 现有RL for LLM算法对不同的token一视同仁,没有考虑token自身的异构性

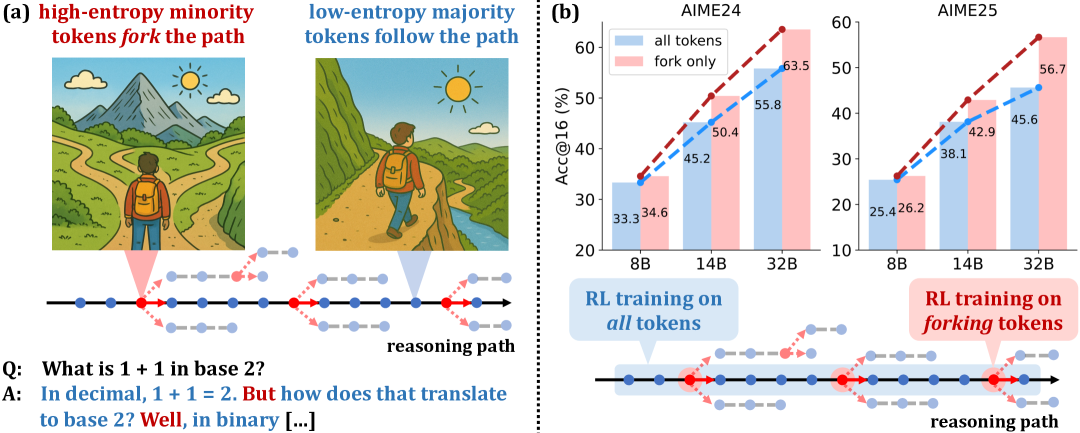
观察: 低熵token主要决定语言结构,高熵token则作为关键的决策点。手动调整forking token的熵,适度增加这些token的熵可以显著提升推理性能,降低熵会导致性能下降。

仅保留20% token的策略梯度更新,剩下的mask掉,性能上能和全量媲美甚至超越,在RL过程中,只有一小部分高熵 token 对探索有实际贡献,而其他 token 则可能中性甚至有害

20%是实验得到的最优比例

另一个发现是32B的性能提升大于14B大于8B

熵定义:

image-20250817165117549

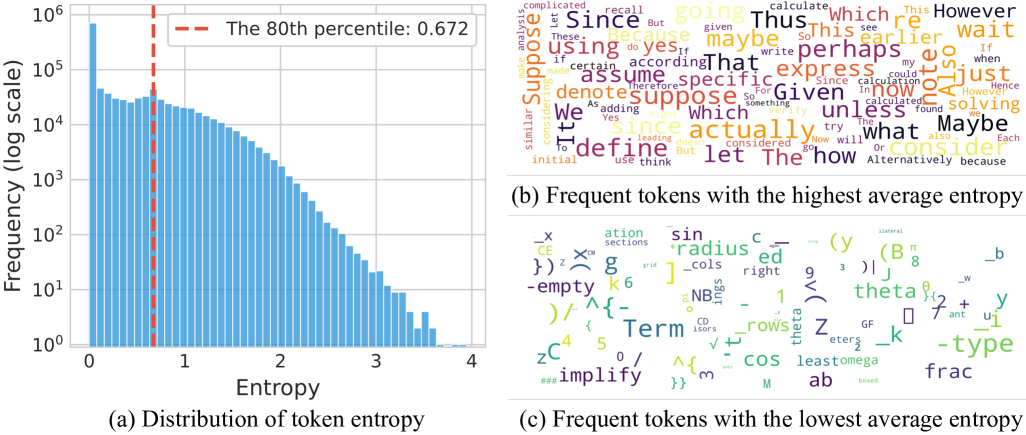
一个很直观的分布图,高熵Token基本是重要的转折词,而低熵token是一些前后缀等

Refer to caption

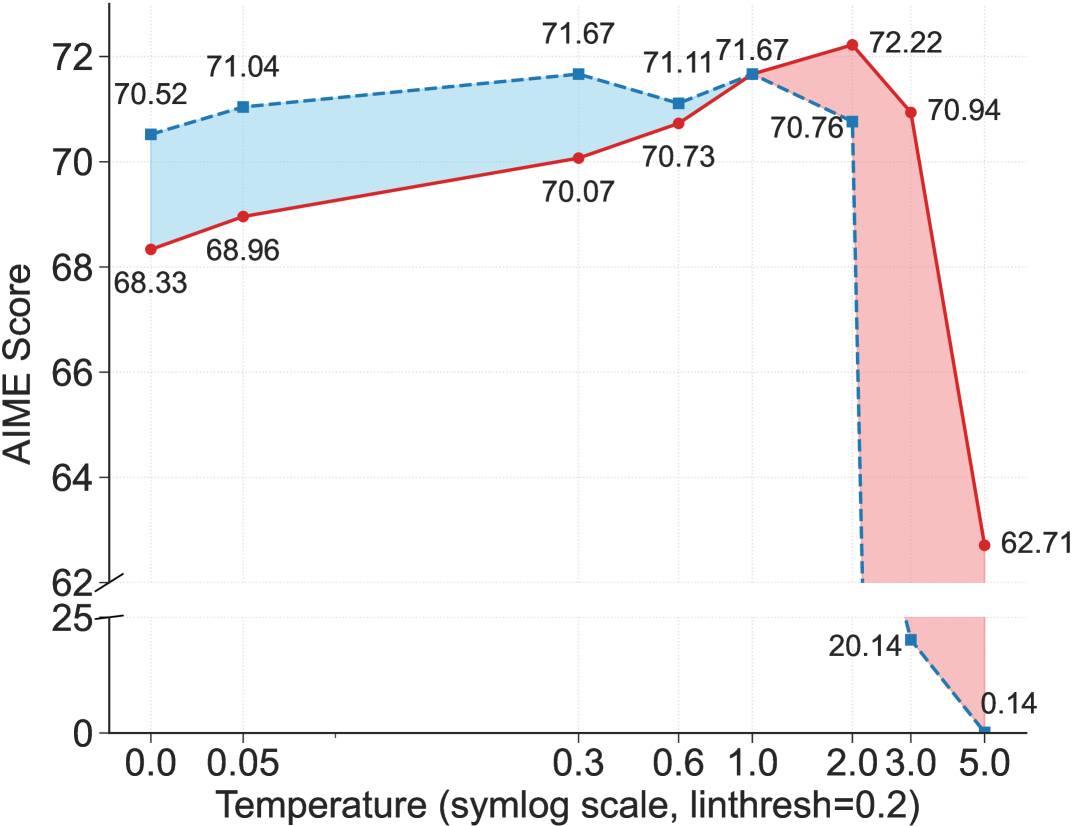
另一个稍微不直观的图

可以得到的结论是高熵token配合高温度能够得到好性能,而低熵token在不同温度下都不太影响最终效果

Refer to caption

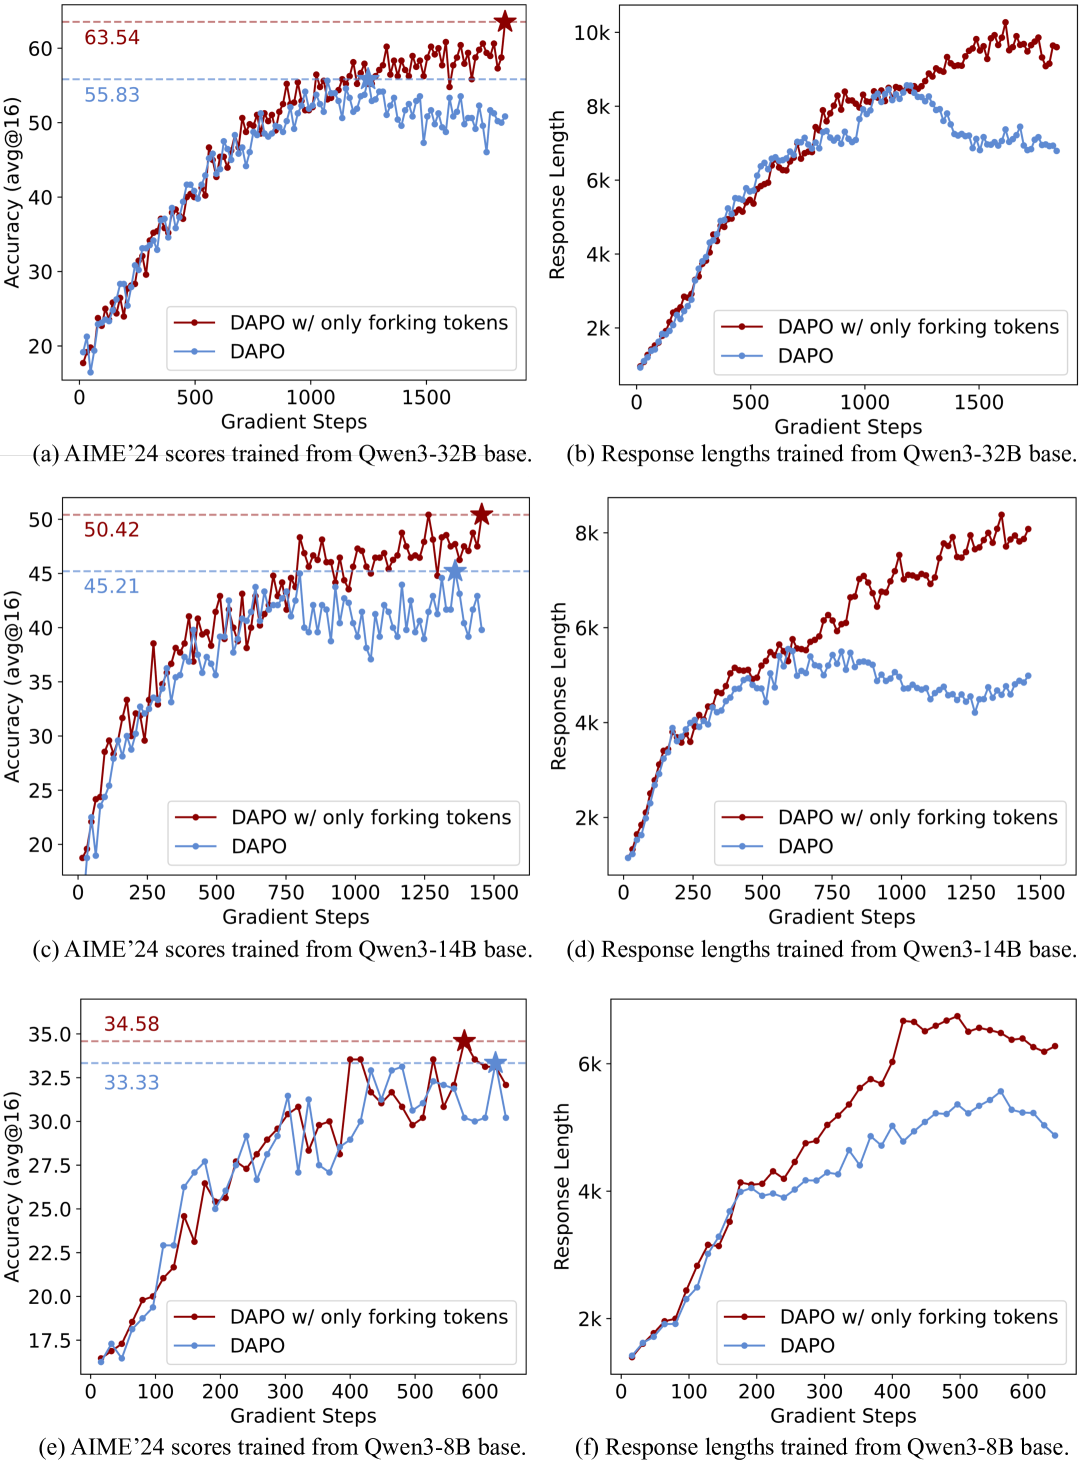
作者还发现,RLVR的过程基本就是这些高熵token的熵改变的过程,低熵Token的熵相对稳定,初始熵较高的 token 在 RLVR 后往往会经历更大的熵增。

而只对高熵Token进行RLVR能得到更好的效果

Refer to caption

甚至作者在OOD数据(代码数据)上进行评测,发现高熵的token选择后,泛化性也更好

Refer to caption

讨论:

  1. RL倾向于保持高熵令牌的熵,而SFT倾向于将输出推向one-hot,降低熵,作者表示这可能是RL更能泛化而SFT容易记忆、难以泛化的原因
  2. 传统RL假设一整条轨迹上的熵是接近均匀分布的,这对LLM不成立
  3. LLM RL中,之前常用的熵损失鼓励探索可能未必适用,因为可以是低熵token的熵增也可能是高熵token的,而DAPO的clip higher能筛选出高熵token,即重要性比率ratio(π/πold\pi/\pi_{old})更高的token通常对应高熵token,这呼应了前文中,RLVF对高熵token的熵值有较大改变

简评:开始的手动把熵调高感觉等价于把奖励调高等价于数据增强,作为一种RL trick细想并不惊奇,是稀有样本情况下的常用技术

从这个角度继续往下想,如何理解这个多数token对训练甚至有害呢,感觉也是能合上现有对LLM RL的state定义不太合理,或者说探索空间太大,采样样本太少,不可能得到正确的Q函数,导致对于一些本来就很无所谓的token,更新的方向也是比较盲目

总之,这篇文章实验非常充足,分析也比较到位,效果也十分亮眼,确实是在当前的SOTA上往前推进的好文章


Pass@k Training for Adaptively Balancing Exploration and Exploitation of Large Reasoning Models​

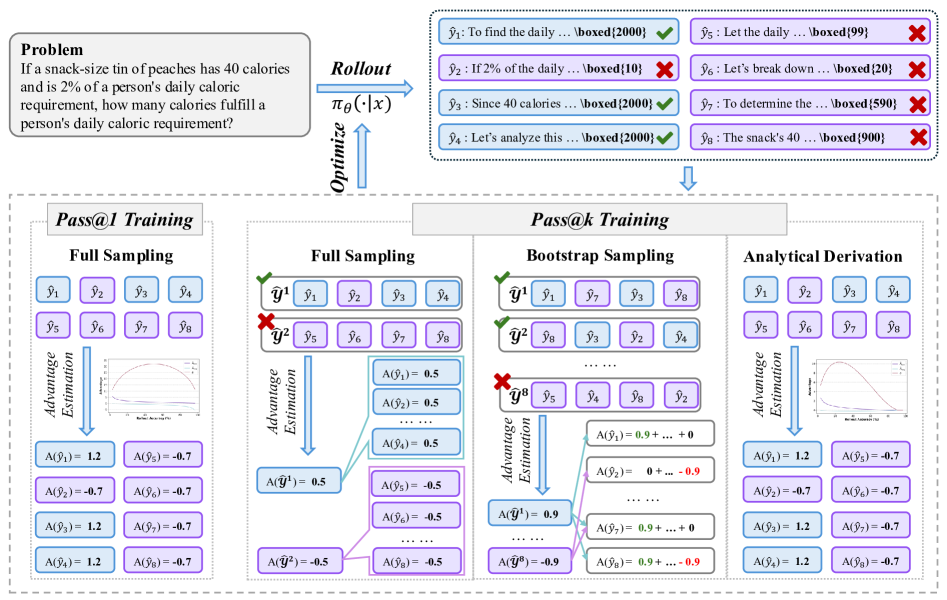
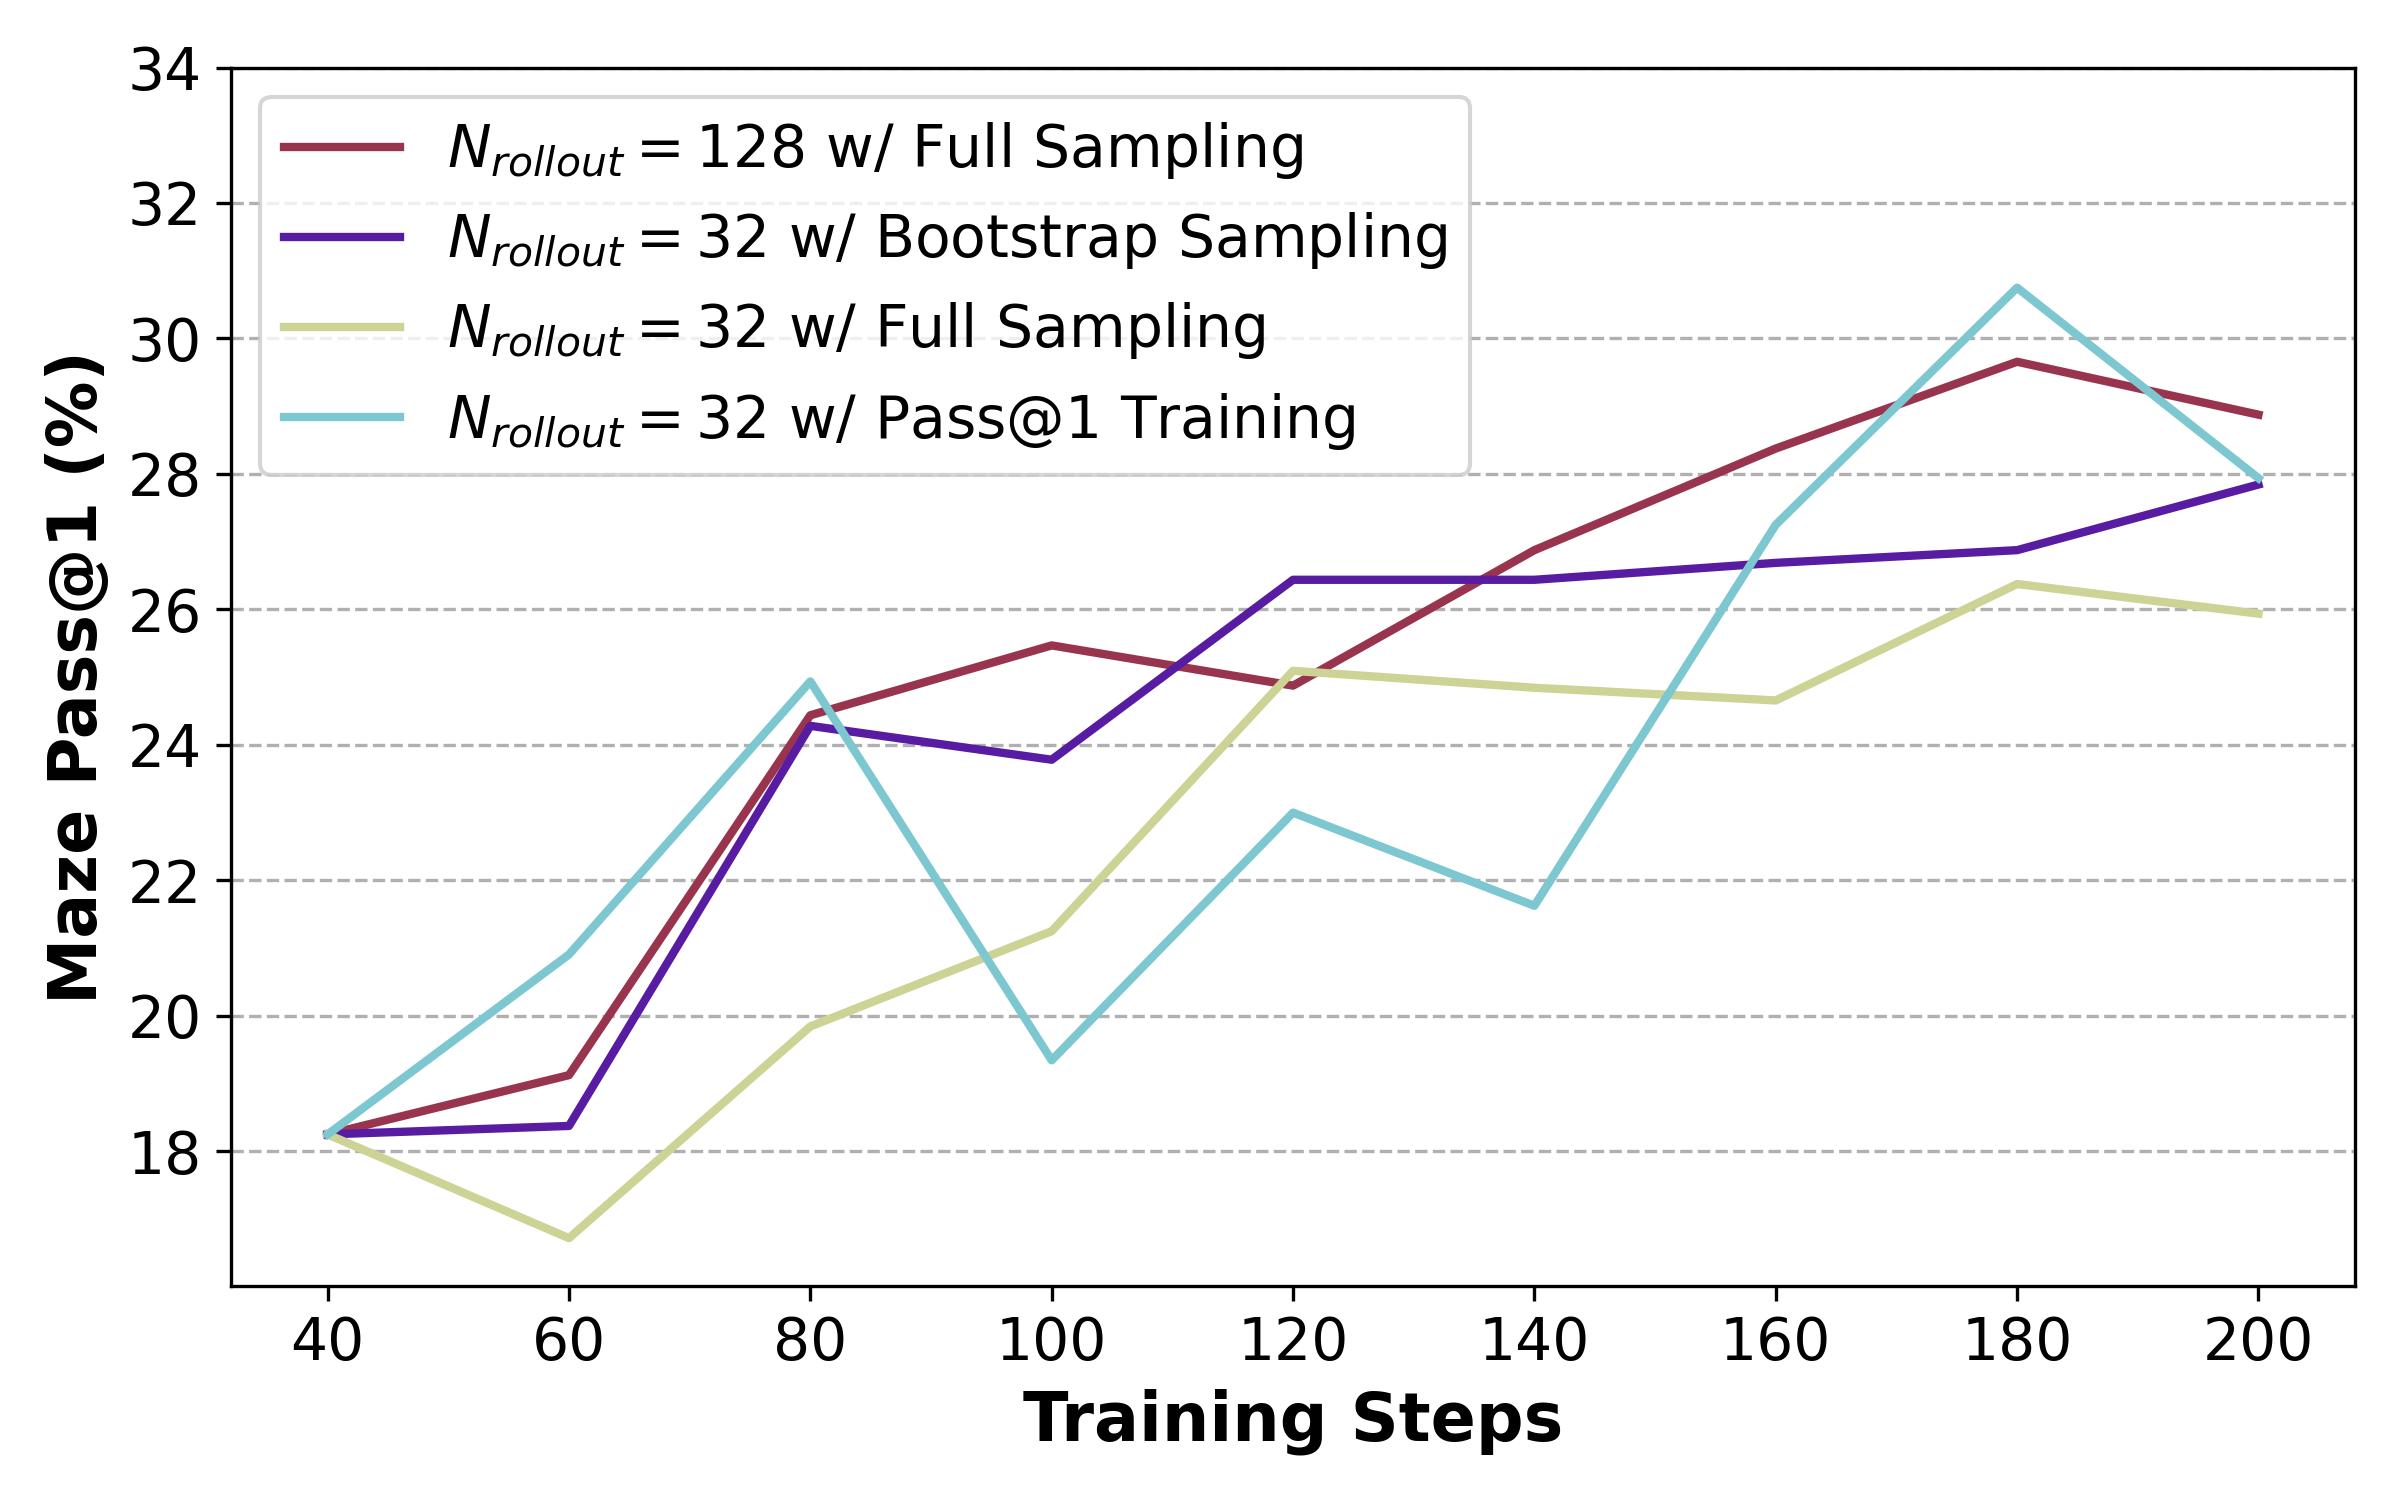
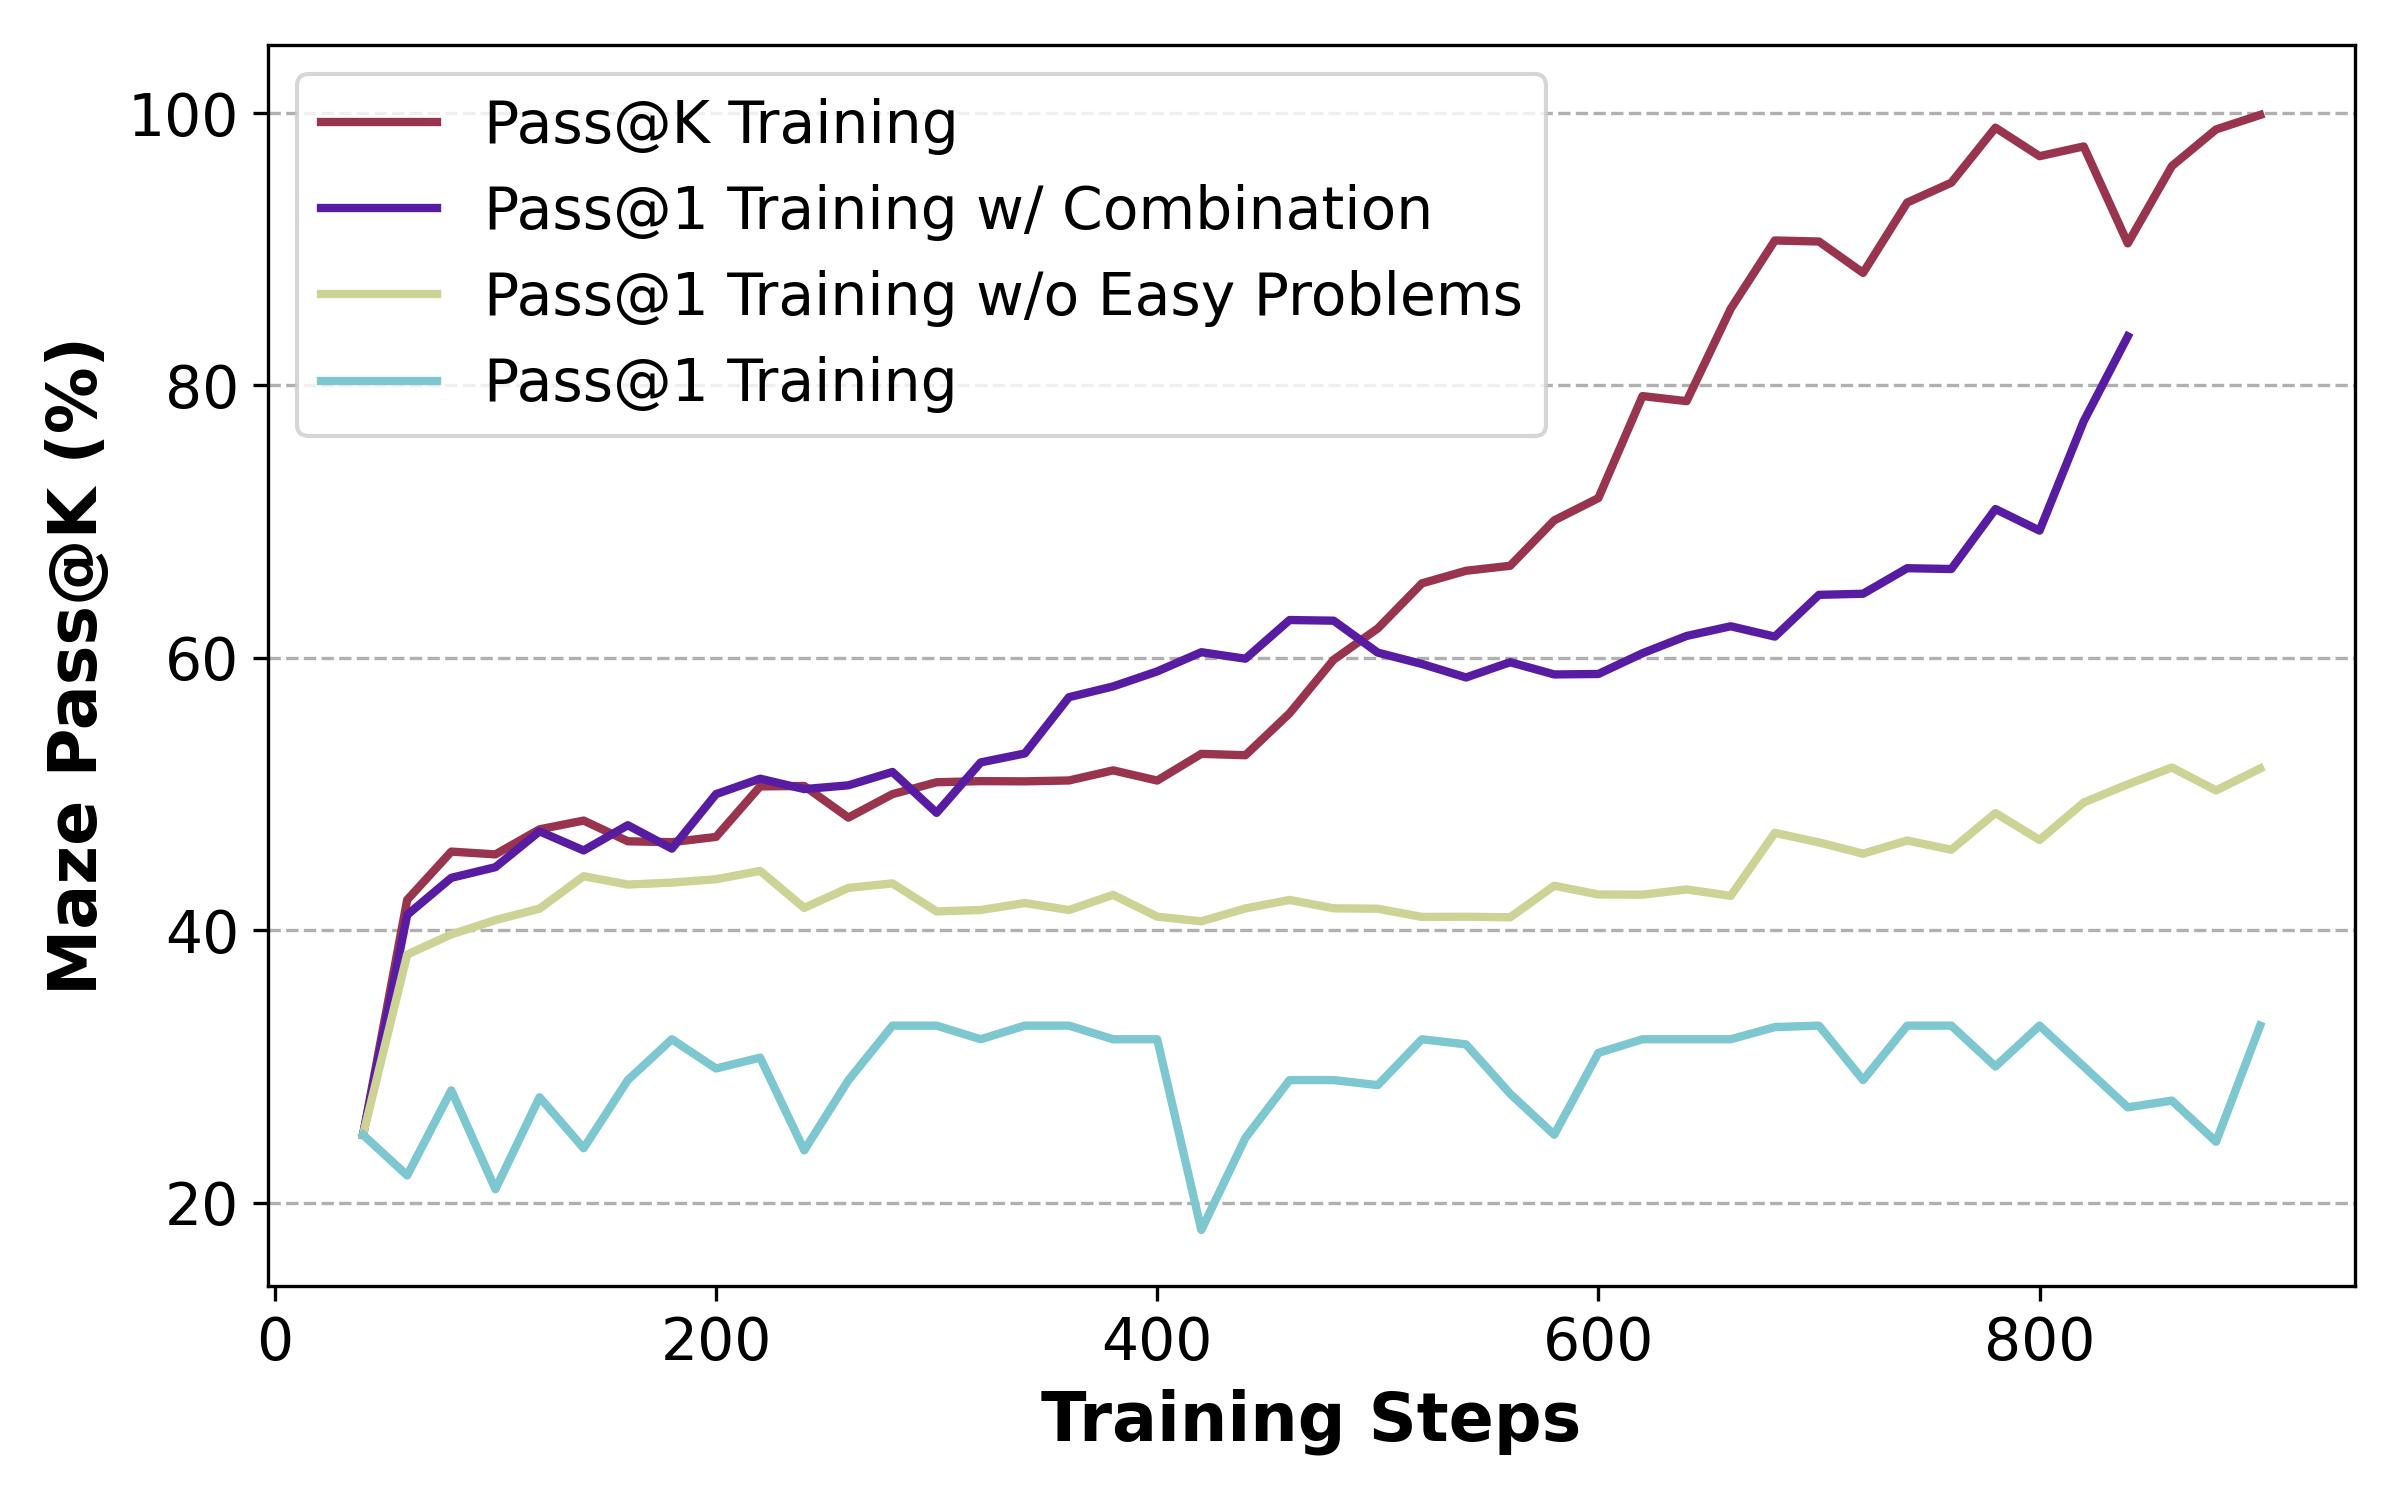
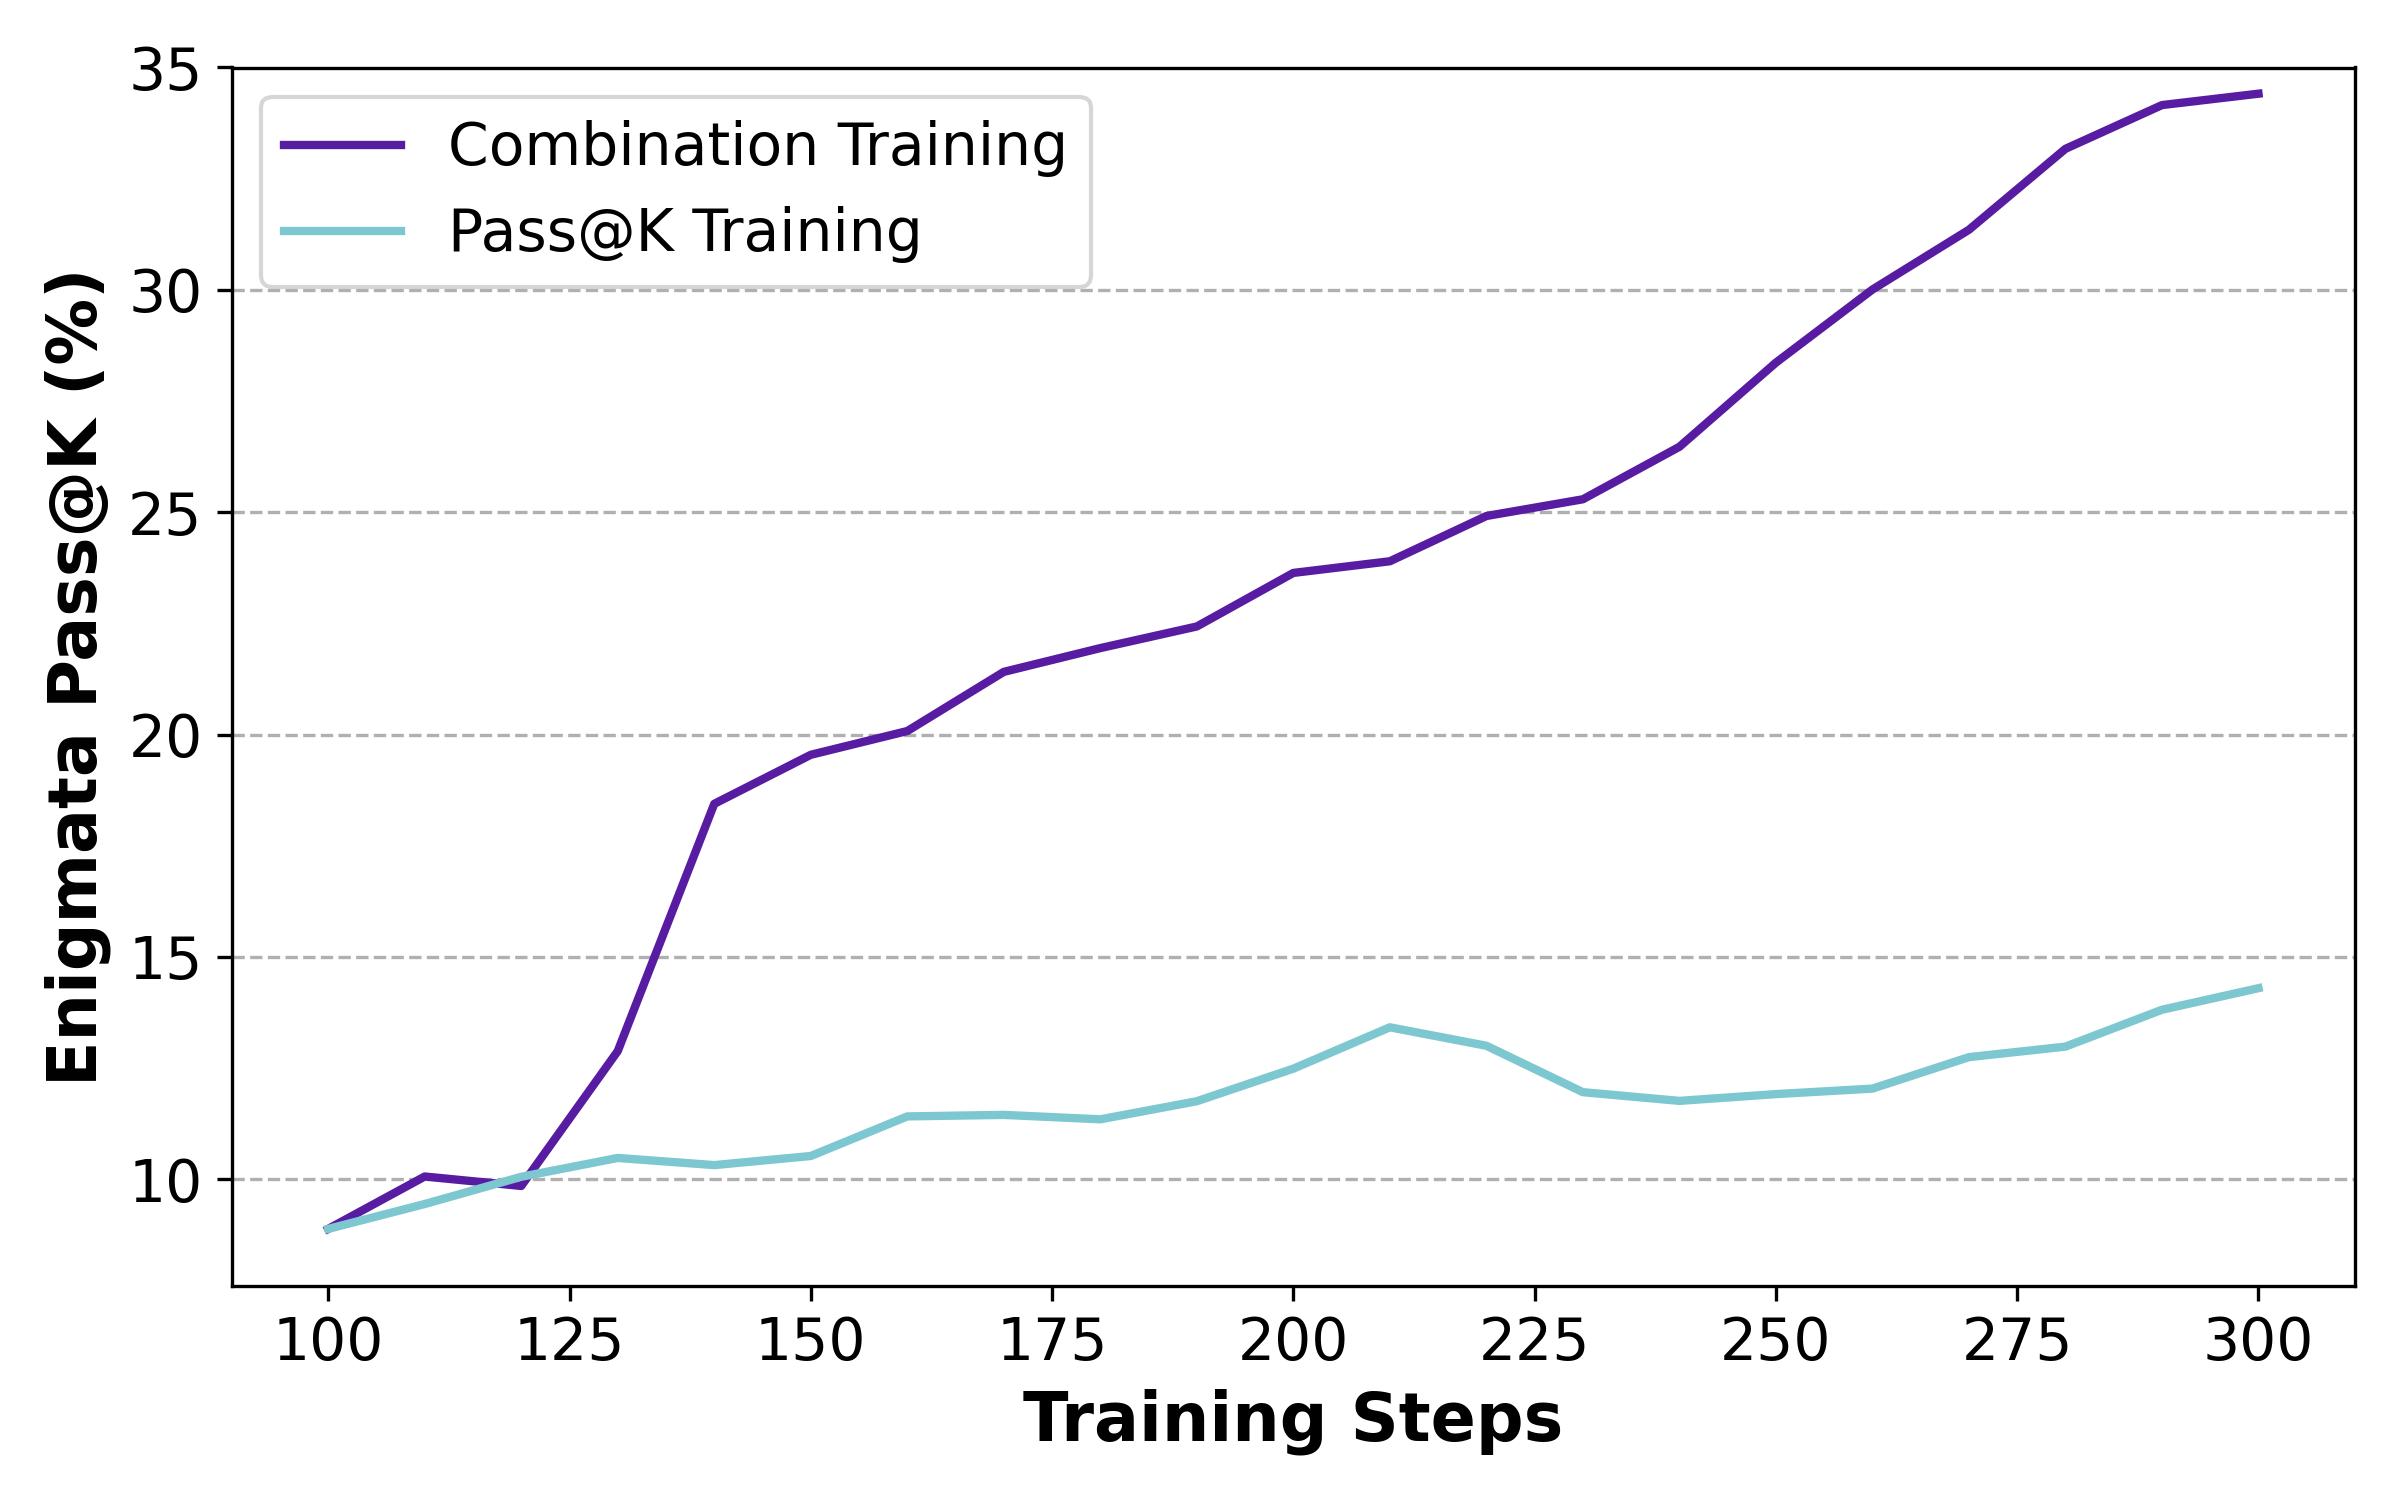
问题:RLVR 通常采用 Pass@1作为奖励,但容易收敛到局部最优;Pass@k则常用于验证,本文用Pass@k直接作为训练,并设计了对应的优势函数,发现效果比Pass@1更好(更高的Pass@k分数,保持的Pass@1分数)

Refer to caption

Pass@1 收敛到局部最优的问题在于正向奖励的探索可能路径太长,模型会倾向于利用而不是探索

Refer to caption

方法:

  • Full Sampling: 每组采样的k个rollout计算奖励,之后整组的奖励由每个rollout的最大值给出Refer to caption

  • Bootstrap Sampling: Full Sampling虽然提高了性能,但计算量太大。为了减少推理次数,同时保持组数不变,采用bootstrap采样,先生成一个候选池,再从这个池子里面抽取k个答案,就形成了一组(这样允许某个答案被分到多个组里面重用),论文中候选池大小就和正常top1大小相同,也就是平均而言每个样本被重用k次

Refer to caption

  • 既然Bootstrap Sampling只不过是对样本的采样重用,那其实可以直接计算对应的优势值的期望,所以可以省去采样这一步,直接计算候选池中正负样本的个数,通过解析解得到期望带入计算

其他实验:

Pass@k的熵在训练中是上升的,而Pass@1后期会收敛,支持了前面的探索-利用论

k的值的影响?k的值不是跳出局部解的重要因素,但k值越大,优势越小(因为只有抽样全负才会是负奖励,k值越大正奖励概率越高),步长越小,训练效率降低,这个结论和也可以在改变学习率中得到验证

无论是小规模还是大规模的 LLM,都可以从 Pass@k 训练中受益。此外,模型架构和模型系列不会影响持续 Pass@1 训练的提升,下游任务的领域和形式也不会影响 LLM Pass@k 性能向 Pass@1 性能的迁移

分析:

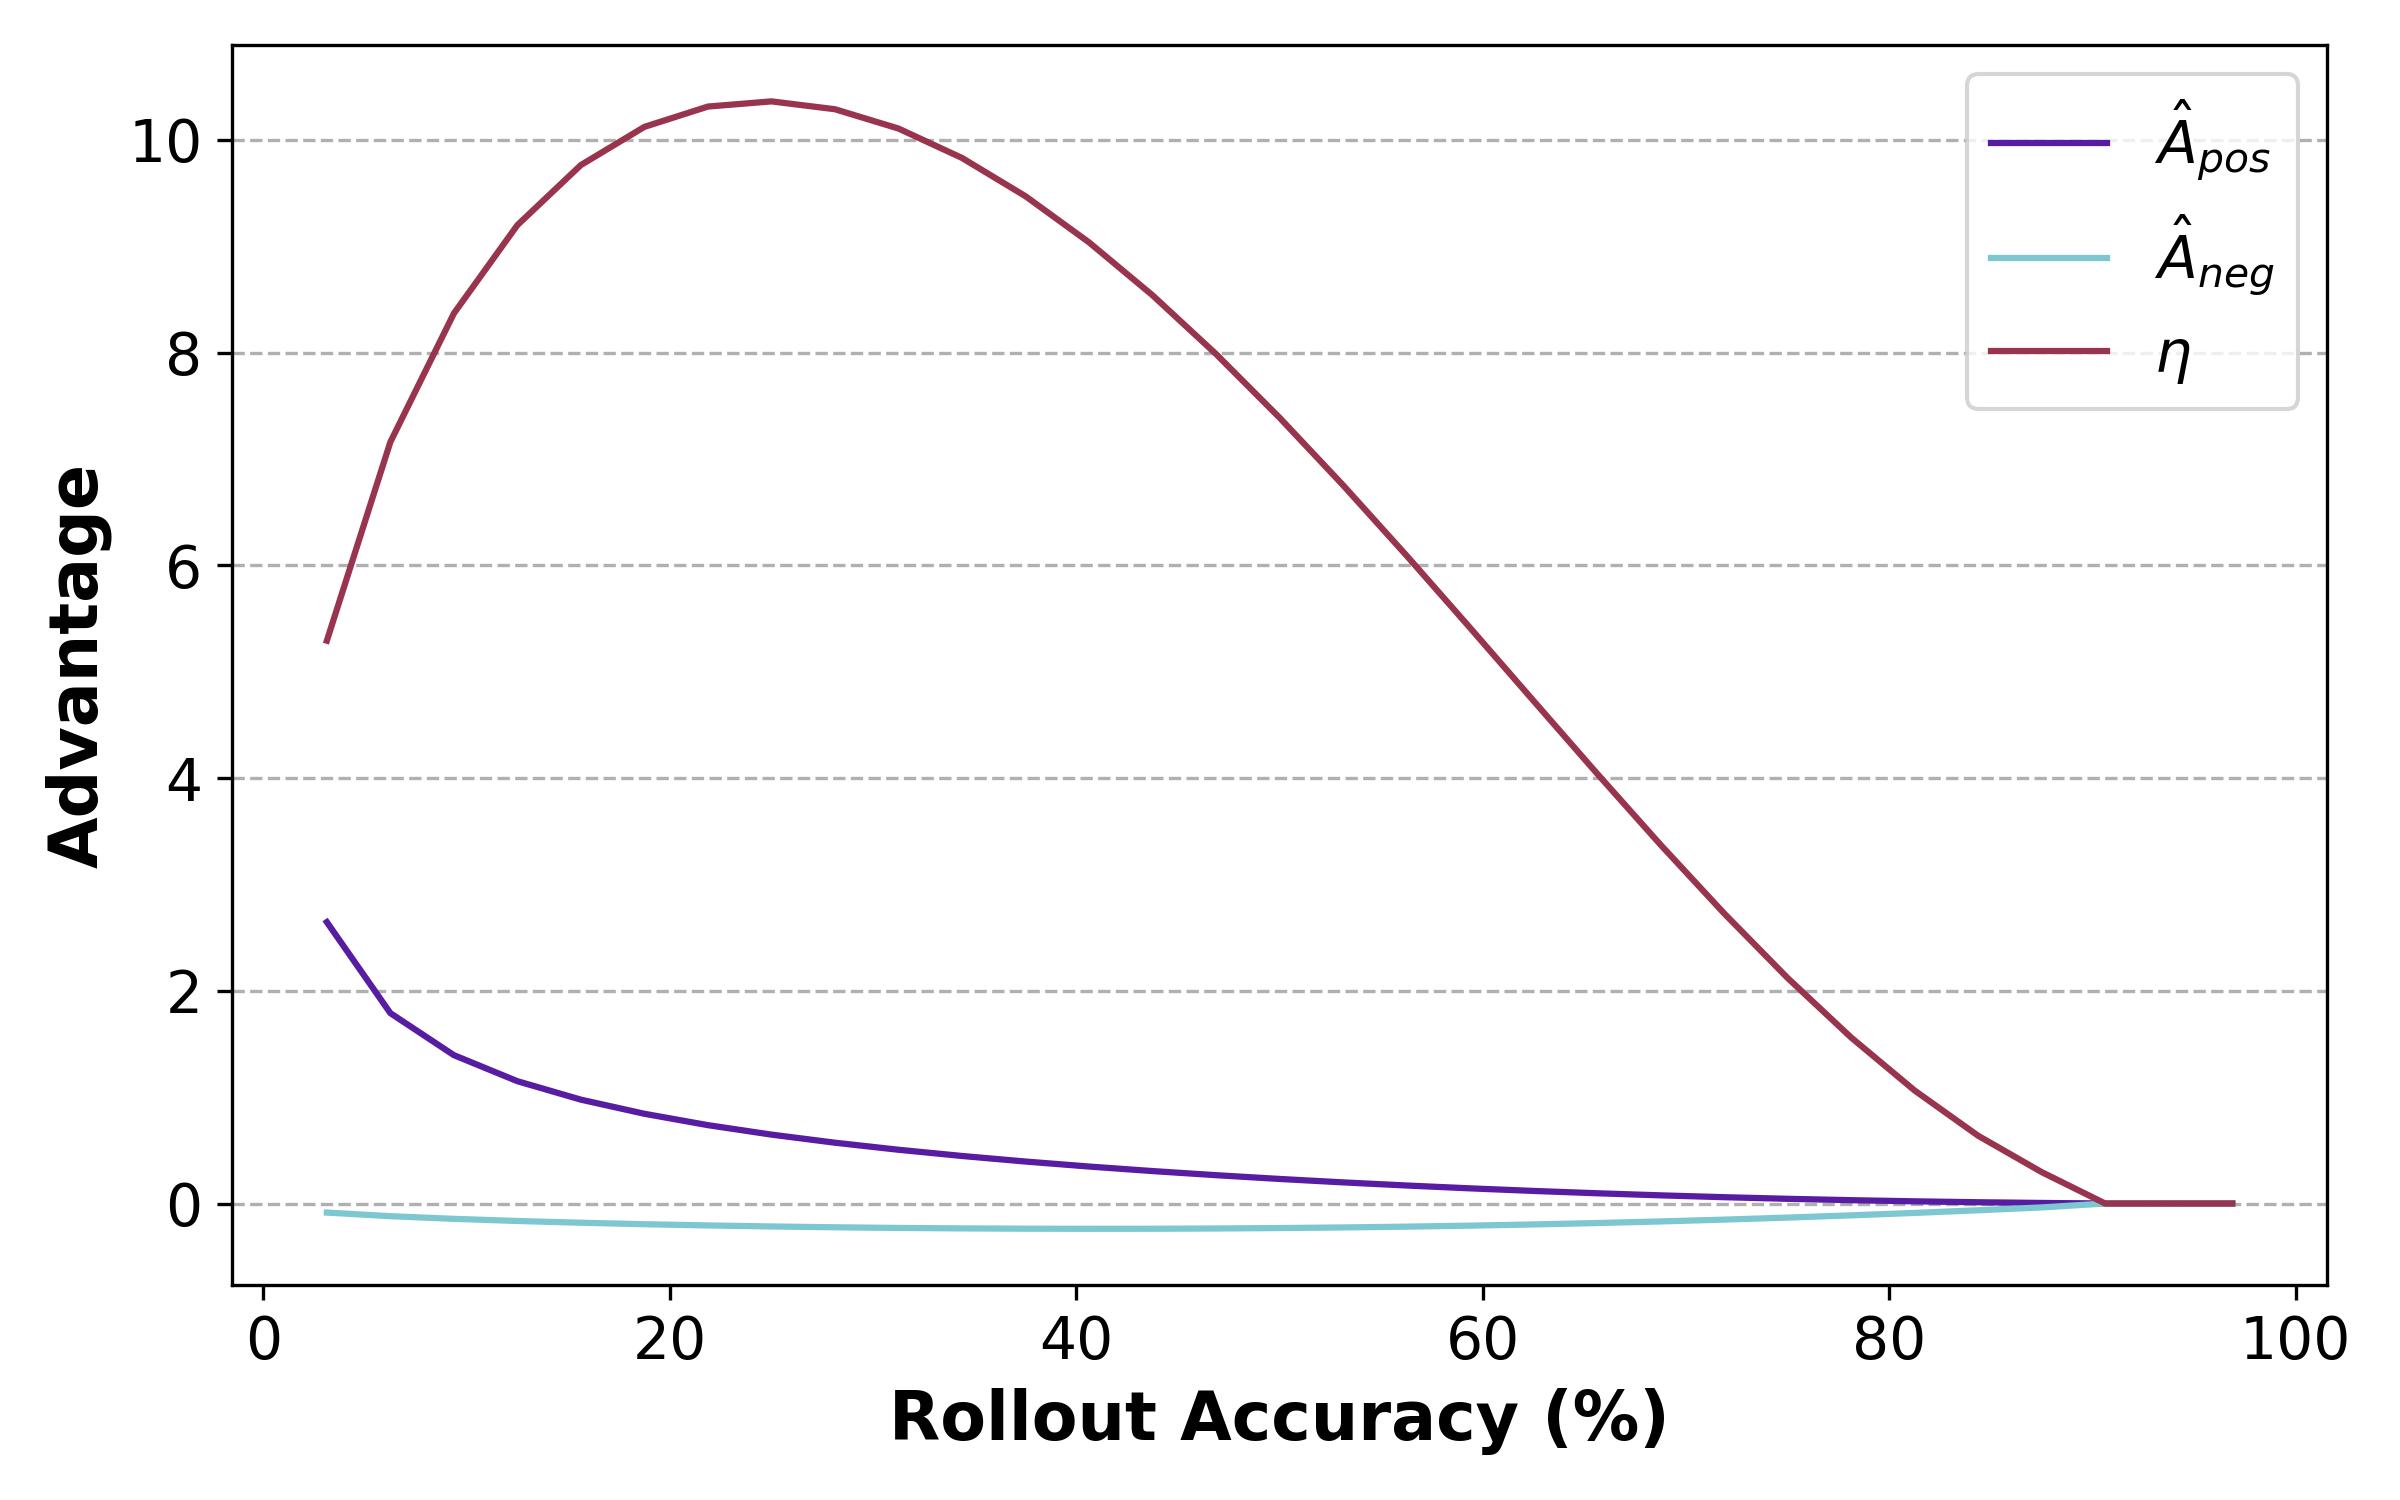
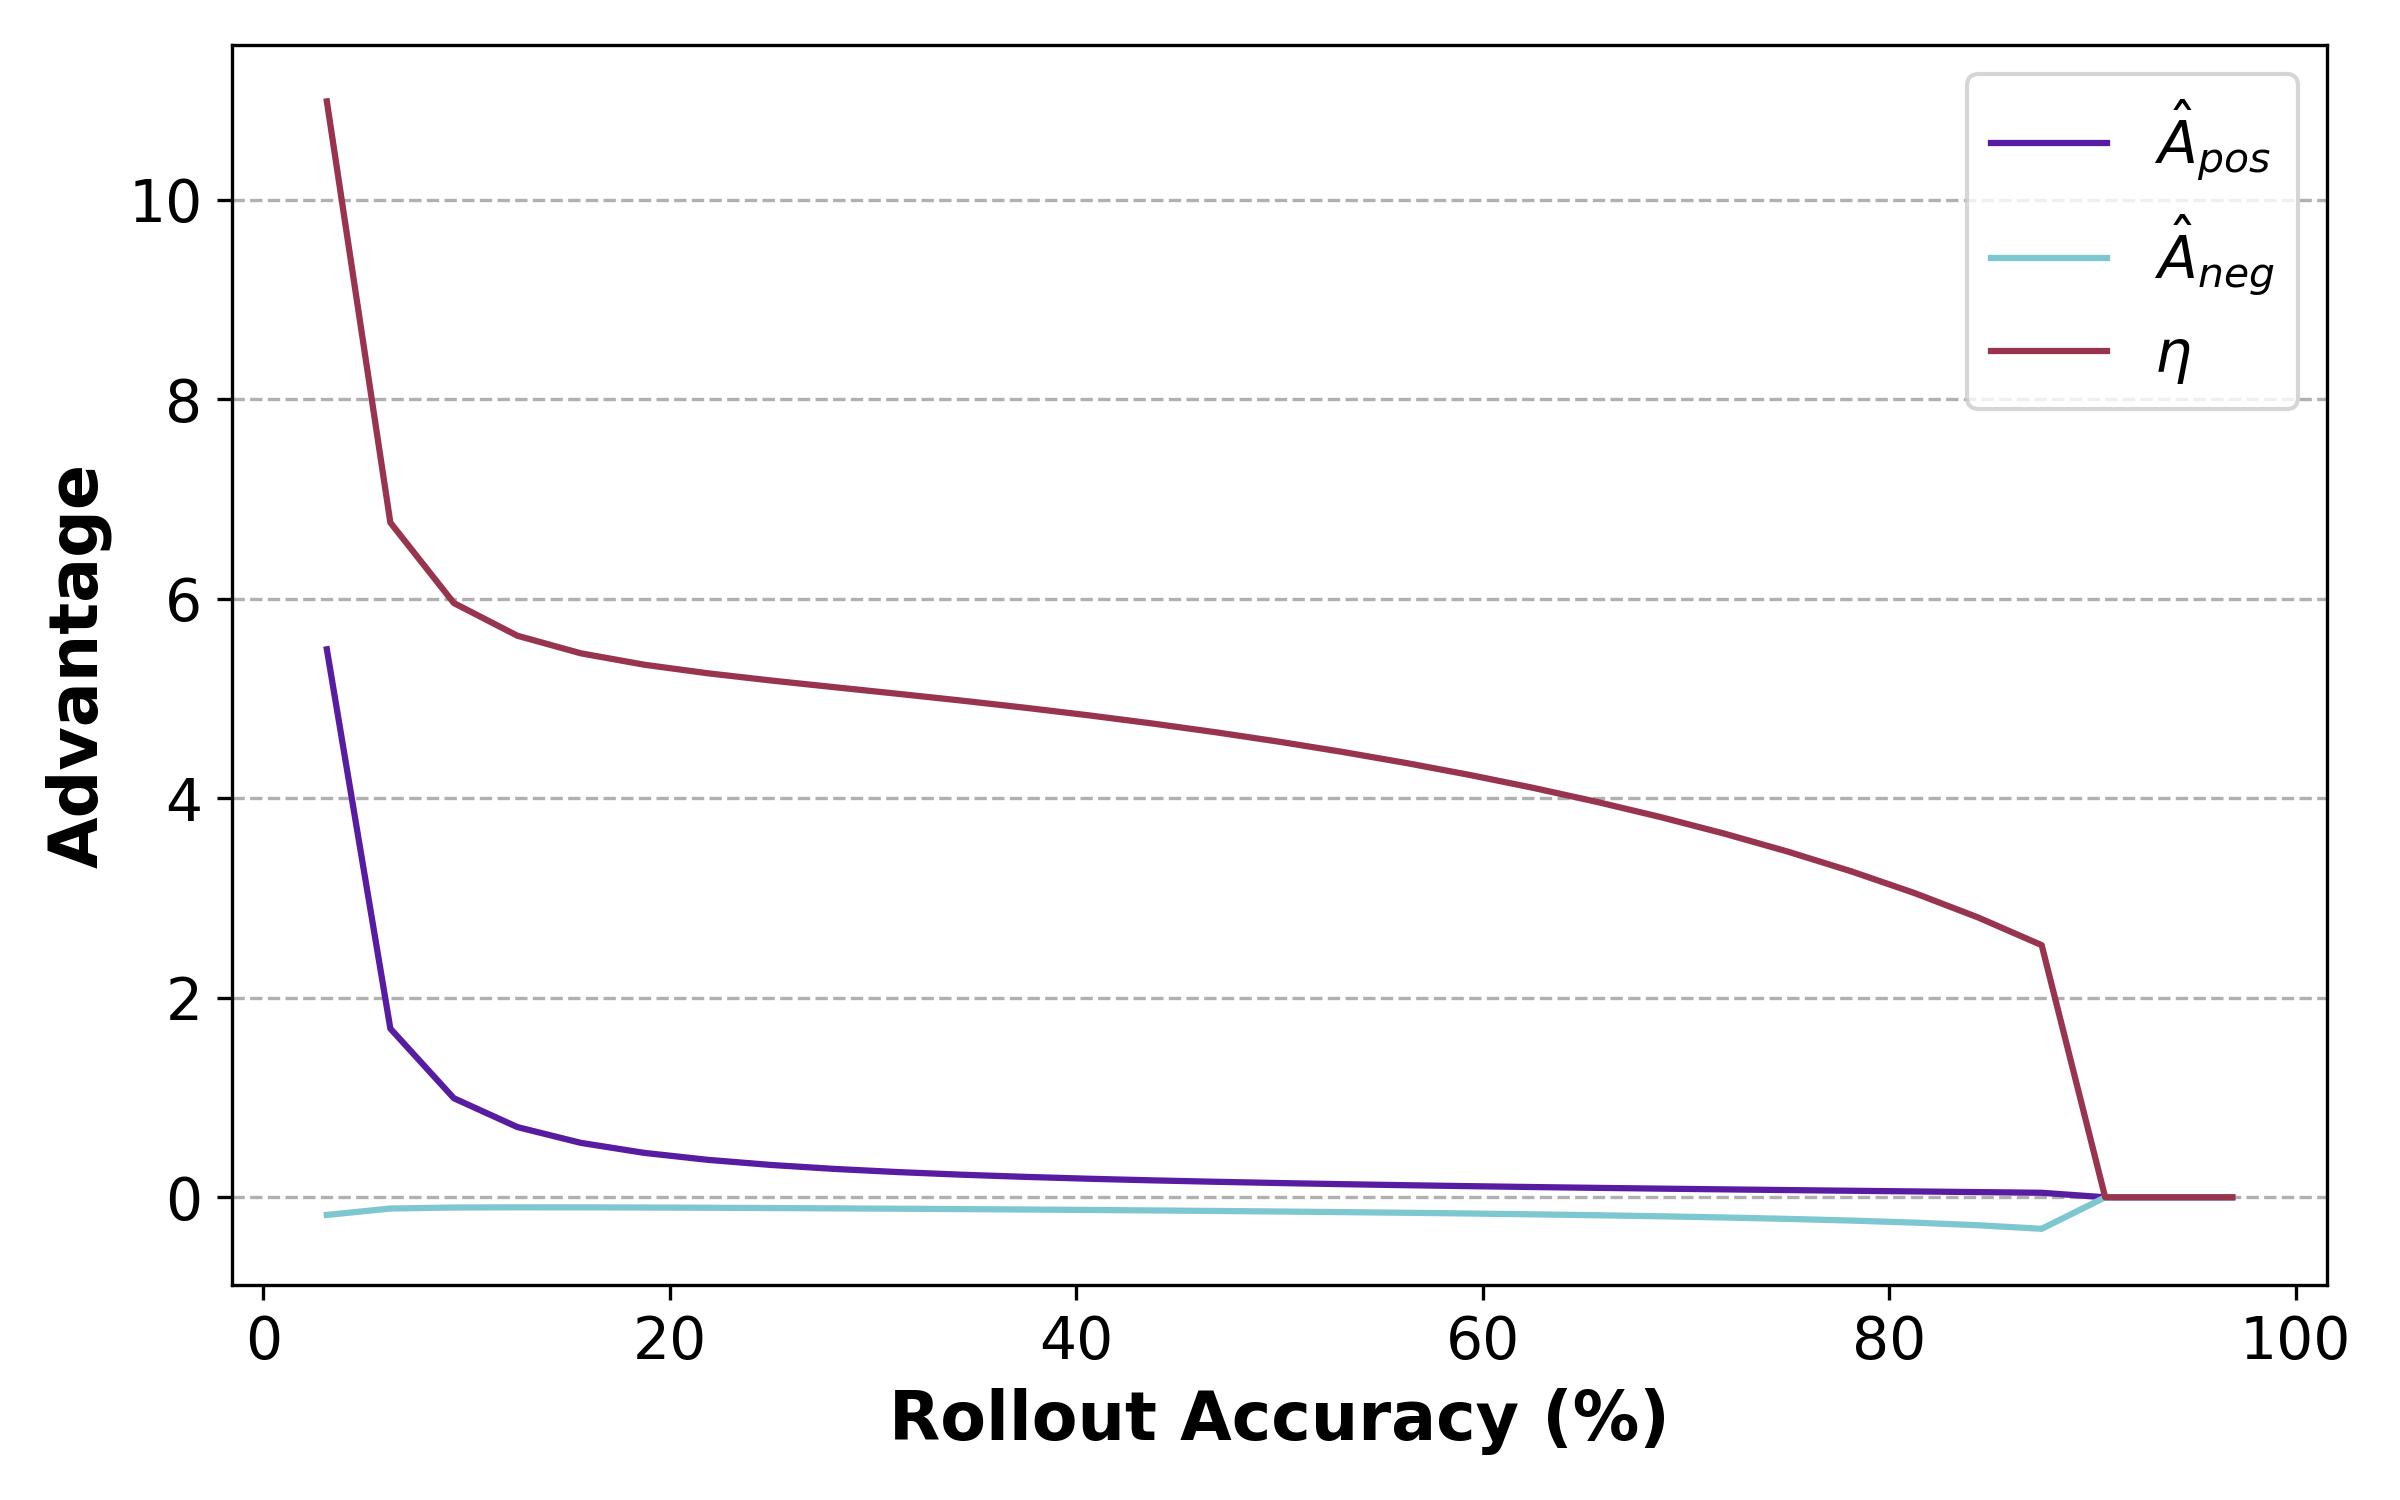
同样是奖励从0到1,Pass@k的梯度出现在比Pass@1更早的地方(一次做对和K次做对),会使得Pass@k更倾向于解决更难的问题而不是中等难度的问题(由于Pass@k有一个argmax, 所以提高已经会做的题的正确率的效果是不断减小的)

Pass@1

Refer to caption

Pass@k

Refer to caption

还做了一个对比试验是仅将简单问题的奖励设置为0,不能防止模型过度优化

Refer to caption

为了分析是否全是梯度曲线峰值带来的影响,手动调整奖励曲线,设计了一个这样的曲线

Refer to caption

发现太注重困难的样本也不好,模型后期乏力

既然Pass@k 更注重困难样本,Pass@1 更注重一般样本,能否动态结合?

一个样本池中,正样本越多,越需要注重困难样本;反之需要先学会一般样本,因此设计了这样的优势函数

image-20250818003914103

发现效果非常好

Refer to caption

文章还做了另一个实验是,用熵而不是正样本数量来判断一个问题是否是困难的,熵高的50%认为是困难问题,使用Pass@1, 低的使用Pass@k,也得到了不错的效果

简评:感觉没太多好说的了,他们做的相当好,从最开始的发现topk training可以提升效果,再到用bootstrap sample提高效率,再到公式的推出,自然发现topk就是本质上对应的难度-奖励曲线的不同,再到设计相关的实验验证,最后提出简单的自适应机制来结合Pass@1和Pass@k,也取得了相当好的实验效果,感觉挺一气呵成的,感觉是一个会成为范式的trick


Structure-Aware Fill-in-the-Middle Pretraining for Code​

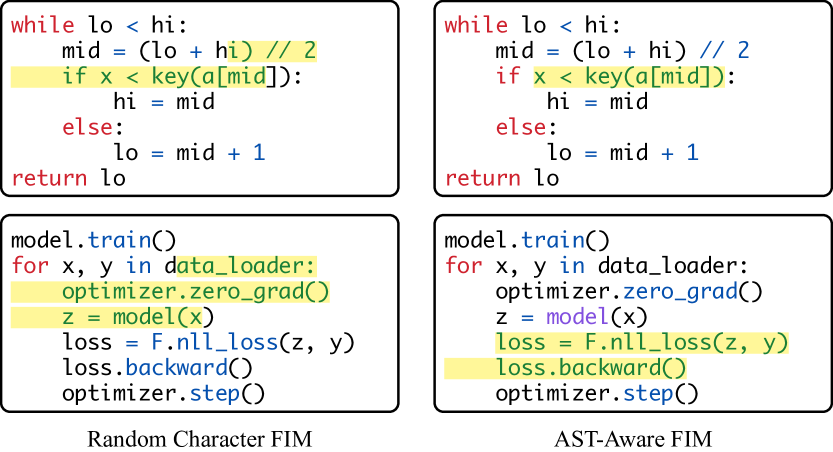
问题:现有的FIM将代码视为字符序列,而忽视句法结构

Refer to caption

方法: 结合AST和FIM, 在训练时,被mask的部分始终是AST的一个或多个完整子树

代码解析:Tree-sitter

mask算法:涵盖不同的AST节点,提高泛化能力,且与具体语言无关

  • 单节点mask: 按照对应文本的数量成比例抽样
  • 多节点mask: 先进行一次字符区间的采样,再找到包含这个字符区间的最小3节点的AST子树,子树中再取和原始字符区间有最大交并比的部分

评估:字符级别困惑度,文章给出不用实际benchmark的原因是大规模单测太难。

简评:非常直接的想法,就类似word-level BERT对原始BERT的改进,不过它怎么构建AST的倒是可以参考。文章最后的评估用困惑度说服力不高,但考虑到它的数据量确实大(256*H100训练),也可以理解


The Entropy Mechanism of Reinforcement Learning for Reasoning Language Models​

问题:现有RL后训练存在策略熵减小导致模型快速收敛,后期探索较少难以提升的问题

Refer to caption

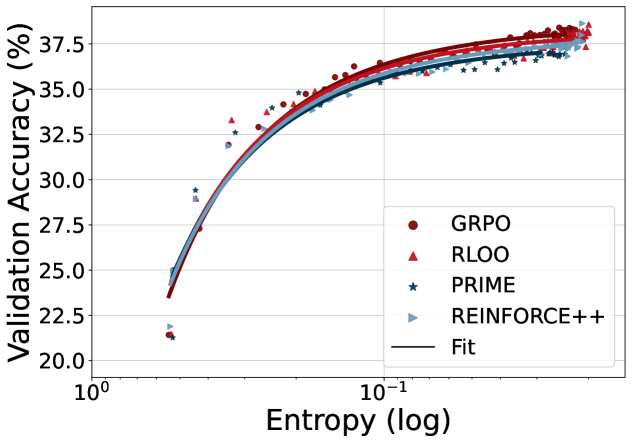
作者发现,在前1/3的epoch中,基本就已经达到了大部分的性能,而熵也进入低值,作者称之为熵崩溃"entropy collapse"

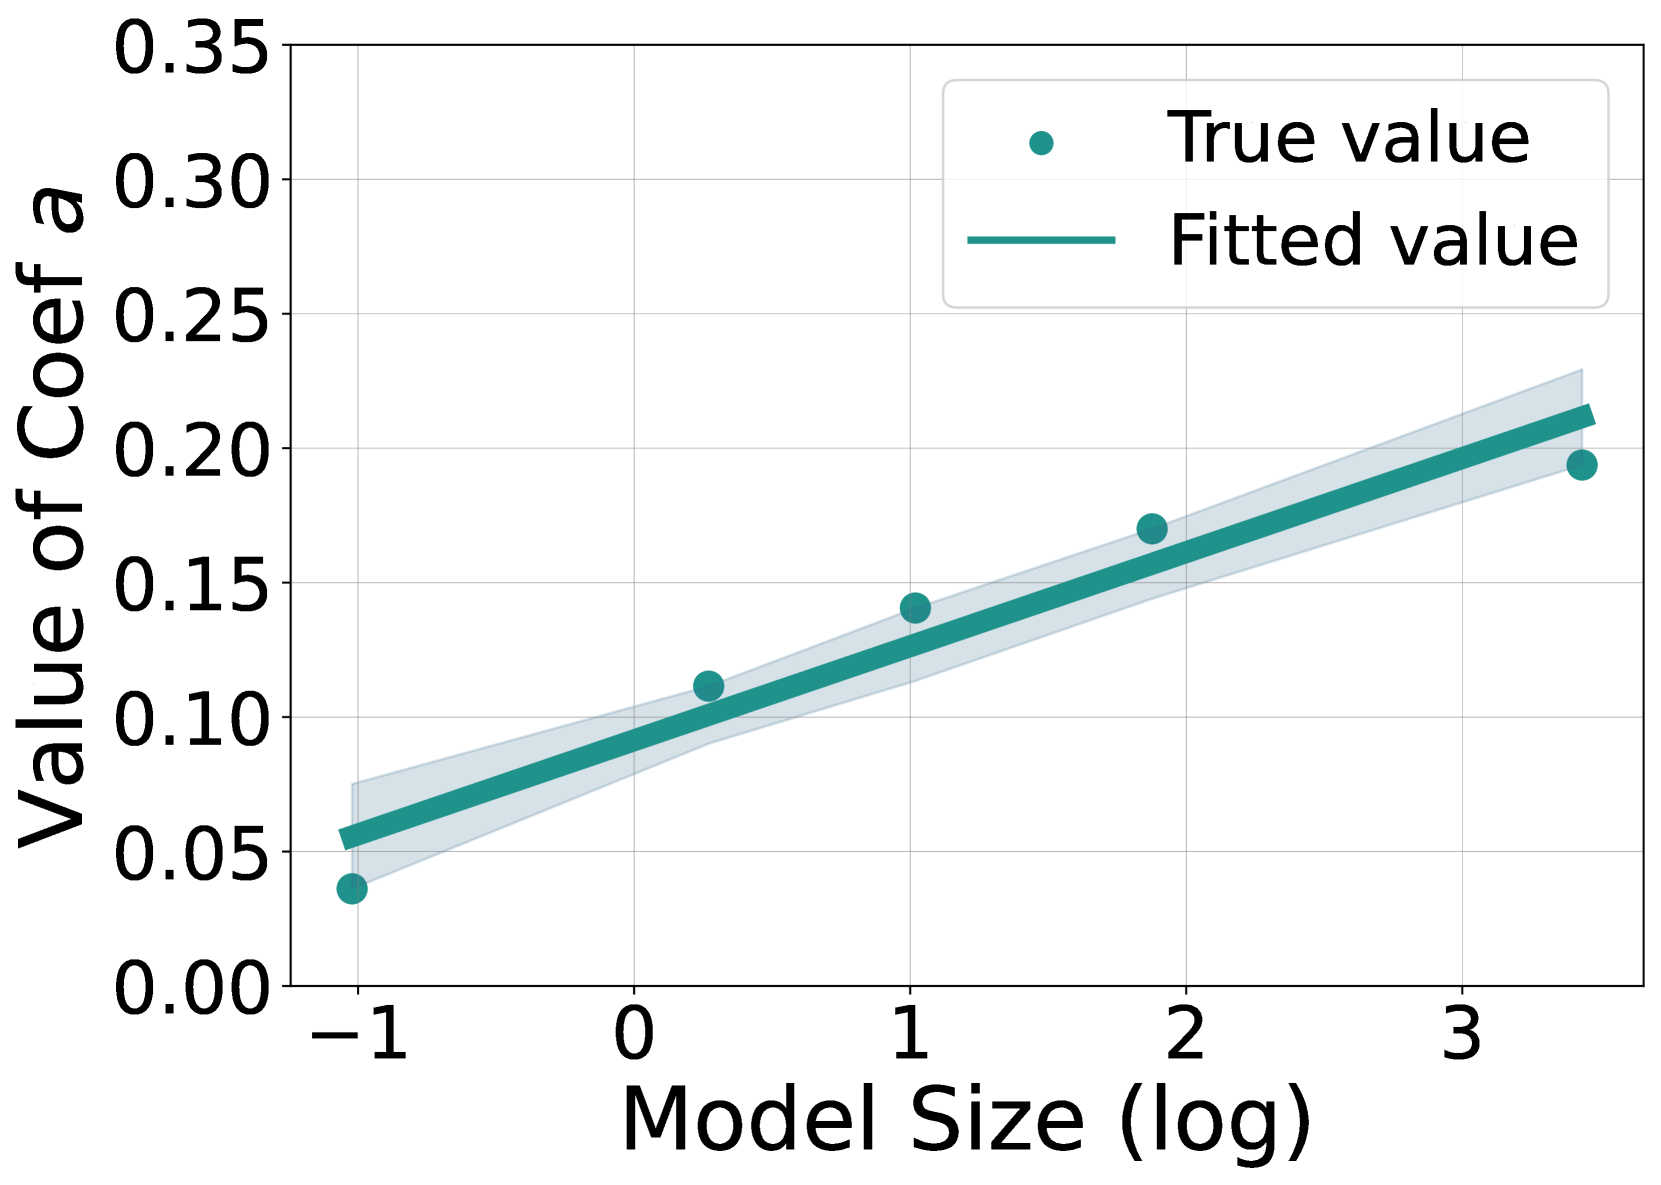
且对于不同的模型大小,对于不同的RL方法,都能拟合近似的定律 R=−aeH+bR=-a e^{H} + b

有了这样的拟合公式,可以在训练早期估计后期的性能,且ab与算法几乎无关,极限就是 −a+b-a+b

Refer to caption

另一个有趣的发现是,ab和模型大小呈对数线性关系

Refer to caption

也就是说,不仅可以在训练前期拟合后期,还可以用小模型预测大模型的RL效果

image-20250818222517778

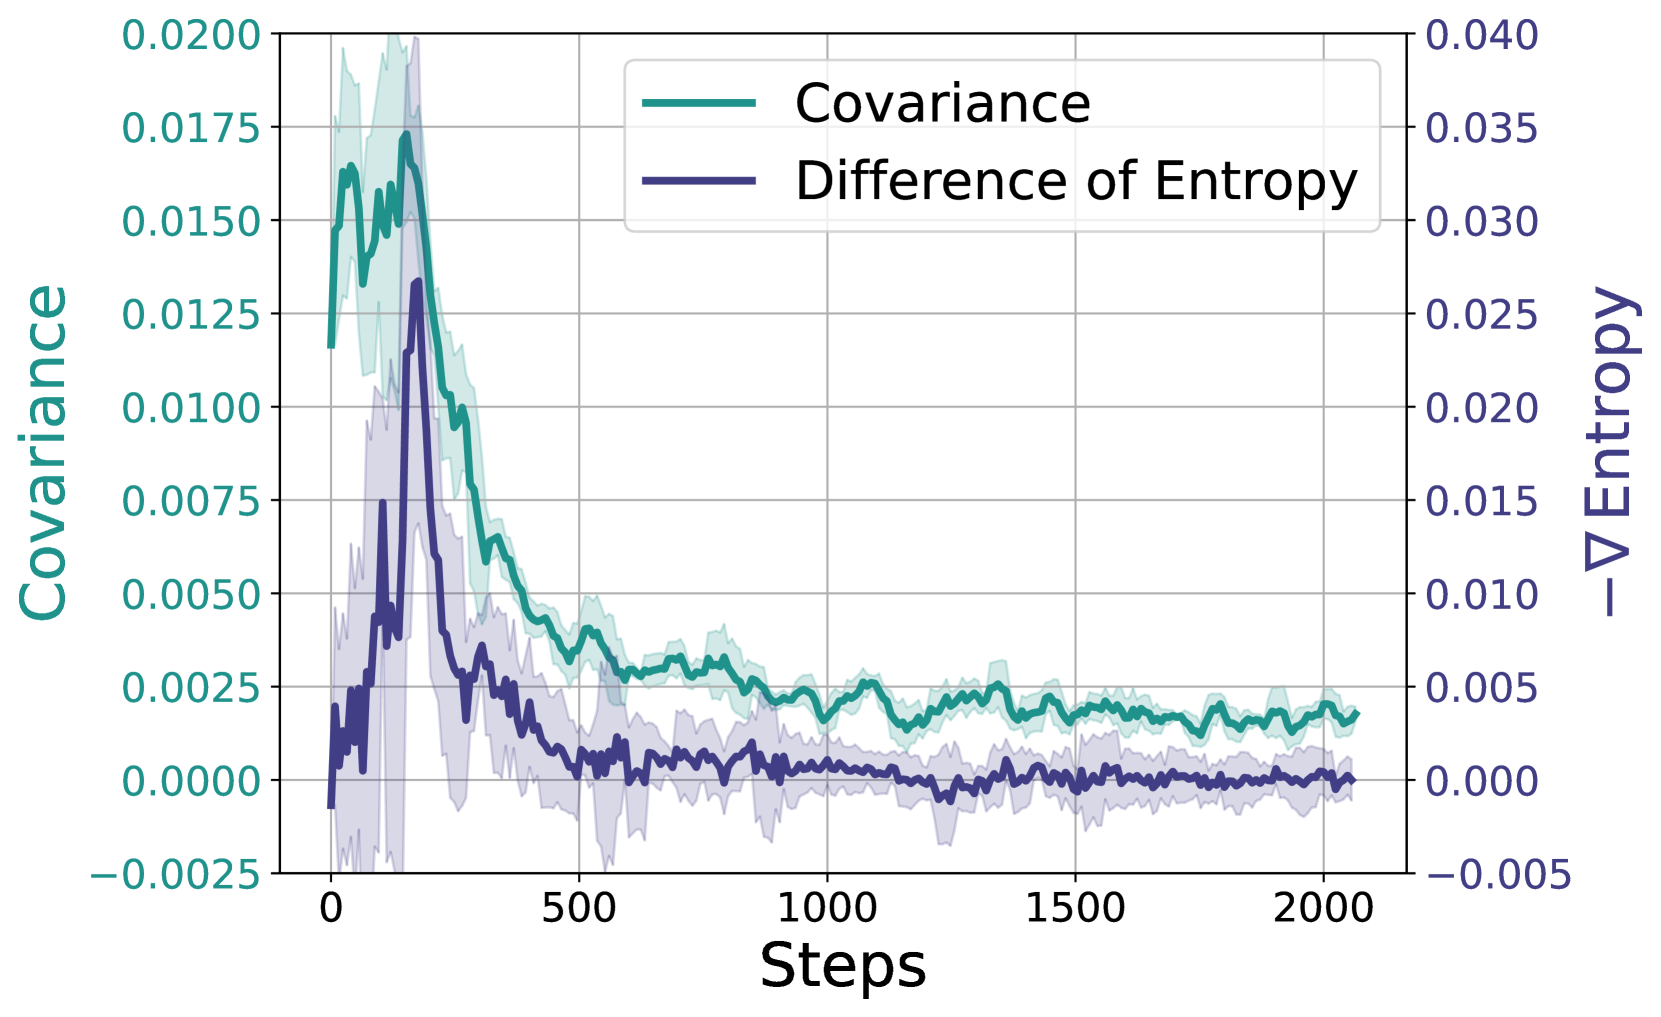
熵变公式如上,直观地讲,如果动作 a 同时获得高/低概率和高/低优势,则熵会降低,反之亦然

Refer to caption

作者还提出,直接使用熵损失的方法,如L=L0−αHL = L_0 - \alpha H, 不仅对超参数敏感,实验效果也并不优于基线

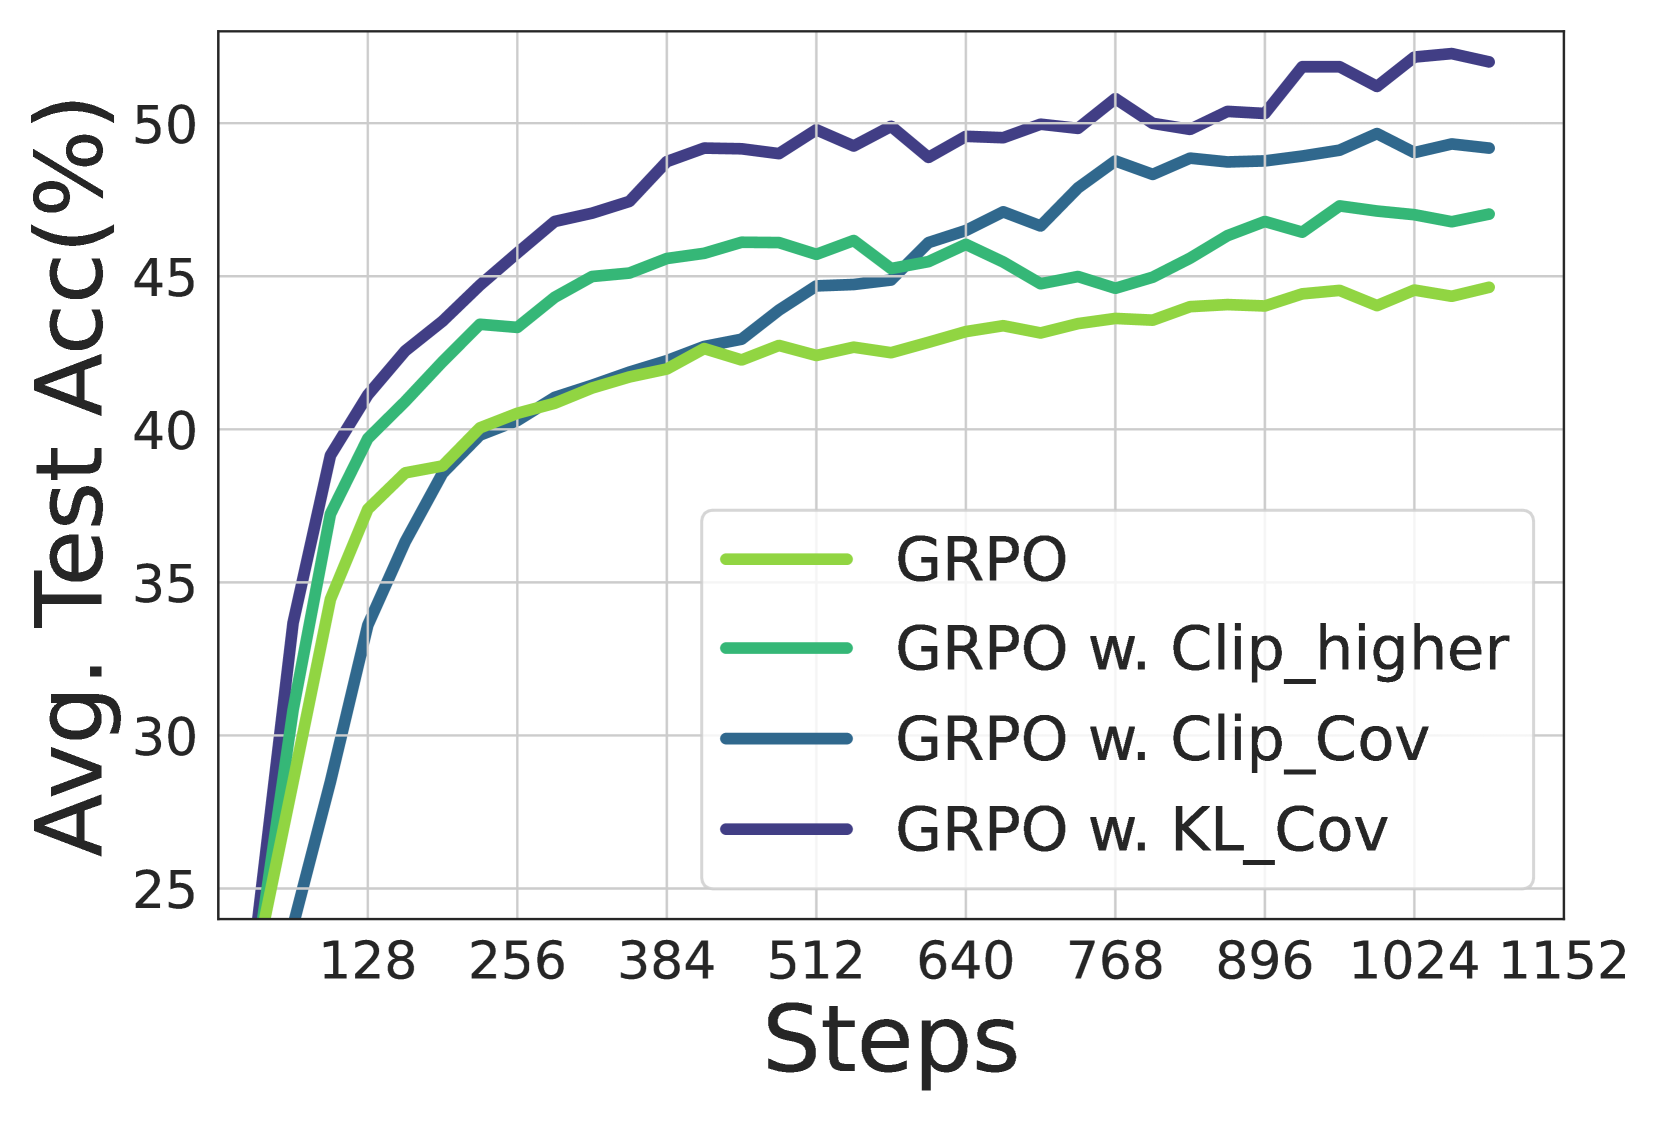
所以作者提出的方法是,针对高协方差的一小部分token做Clip或者KL,就能防止熵崩溃,下面的实验结果也表现很好,熵后期不下降,回答长度增长,正确率大幅度提高

Refer to caption

Refer to caption

作者发现策略熵对超参数设置非常敏感。具体来说,我们的方法仅干预一小部分 token( 10−4 到 10−3 ),却完全改变了熵曲线。这意味着几个“关键” token 对 LLM 的熵至关重要

简评:搬运作者对clip-higher的讨论,作者认为,clip-higher也有类似的功能,提高重要性采样的上限会带来更多低概率的token,上限阈值仅影响具有正优势的 token,这意味着 clip-higher 实际上在梯度计算中添加了更多低协方差(低概率、高优势)的 token,所以结论殊途同归。而作者直接提出协方差是更胜一筹。

不过作者也说了现在还不清楚熵和模型性能的完整关系,也不清楚最优的熵值

另一个就是这些熵的论文主要还是在math任务上做的,code任务能否有相同的结论还是一个问题 (我认为这两个任务关键在于中间过程是不是重要的,math只有结果可能会得到一些错误的结论)


Improving LLM-Generated Code Quality with GRPO​

问题:take code quality into consideration,不多赘述

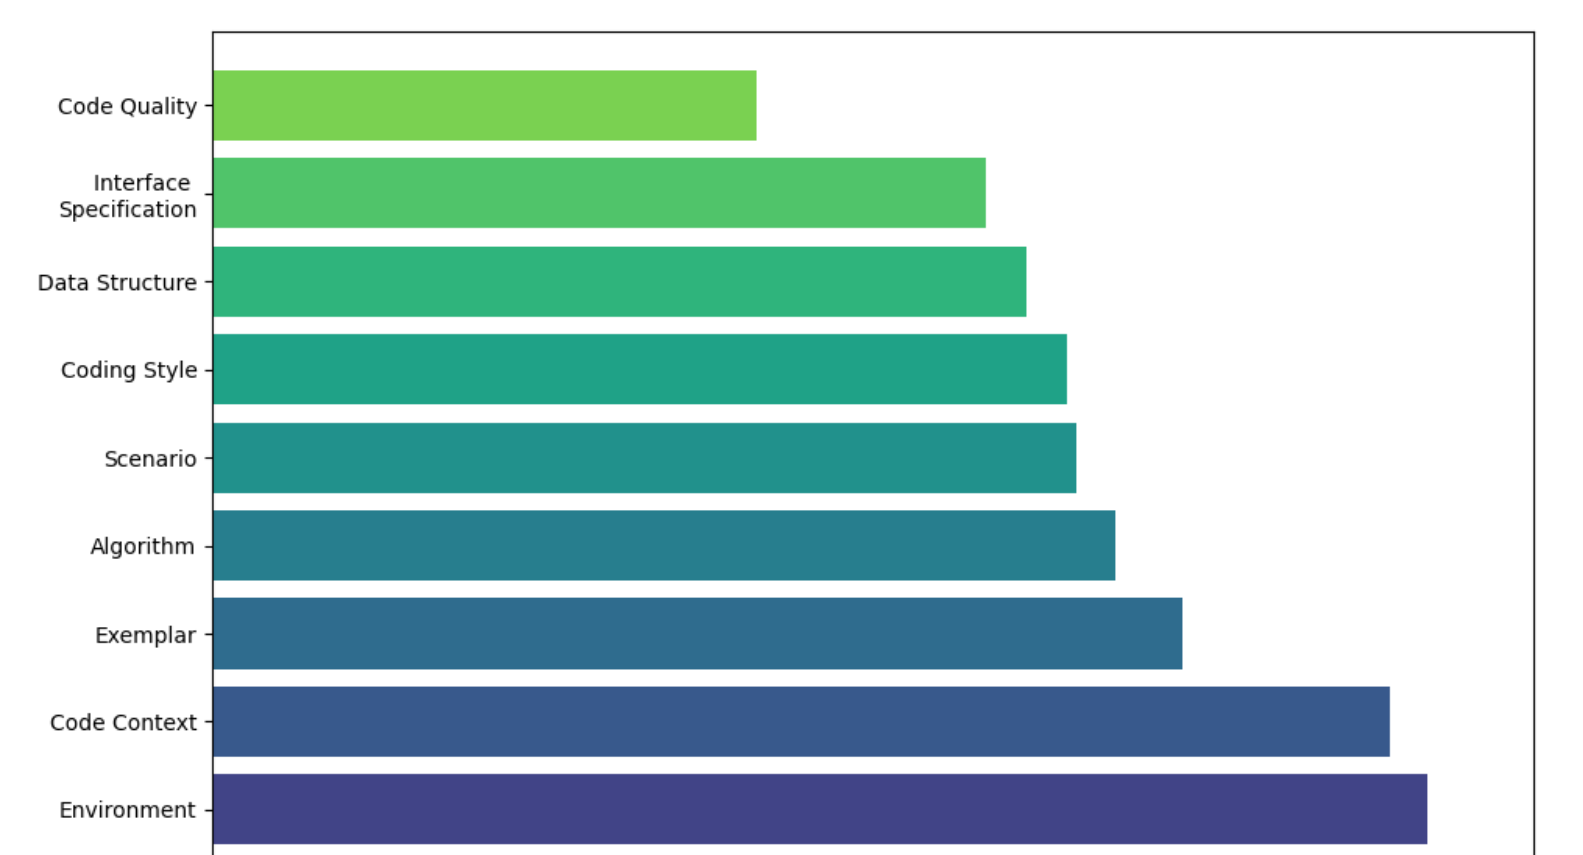
方法:维护了一个库,把现有的一些评估代码质量的方案整合了起来(code complexity, dead code, code structure(linter等), style&doc, safety, performance...), 然后质量奖励和正确性奖励一起放到奖励里面丢给GRPO

简评:只是占坑的,很草率的方法(对于奖励参数的设定),定量结果也不足。


Enhancing High-Quality Code Generation in Large Language Models with Comparative Prefix-Tuning​

问题:take code quality into consideration

方法:比较有新意,将Dynamic Prefix和代码质量结合起来了,并且是使用对比学习的方法做这个前缀

基于Pylint打分,构建了一套数据处理流水线标注大量高、低质量的代码对(相似度高,质量差距大,且都至少通过一项基本测试)

然后在微调Dynamic Prefix的的时候,加上一个排名Loss,希望模型倾向于生成高质量的样本。

里面的掩码是用difflib做的,目标是聚焦于差异的导致质量出现区别的token,而不要考虑重复的token

image-20250818231615372

然后进行PEFT微调,再加上KL散度来保证不要丢失原始模型的代码生成能力

简评:这篇文章写得特别冗长,实验做的重点不突出,但思想是有意思的,并且明显可以继续挖,例如他们的代码相似度是简单的词频向量,自然挖掘出来的是细微处的代码风格问题,如是用index还是for each的形式遍历循环(只有这样的才会词频上高度相似)。但实际上是否可以用例如bge-code这样的代码语义嵌入呢?值得探究。

还有就是,这个数据收集的方法依赖于大语料库,也只能挖掘常见的代码模式,如果用自生成的方法,例如假设我们已经有一些高质量的代码库作为ground truth,

用llm得到的补全片段当负项,也能构造正负样本对啊,既然都是训练得到一个通用的“code style prefix”,这样数据丰富程度能高很多。他们明显的数据少训练小(2*A6000*3h)。


Augmenting Large Language Models with Static Code Analysis for Automated Code Quality Improvements​

问题:LLM refactor code没结合静态分析

方法:RAG + 静态分析软件 + Prompt 工程

简评:垃圾文章,真要做也是做一个能排序Code Quality的专用BERT,或者对现有的code embedder/reranker做adapter研究怎么把code quality调进去


A Hierarchical and Evolvable Benchmark for Fine-Grained Code Instruction Following with Multi-Turn Feedback​

只需要看一张图就行了

image-20250818234727444

现有模型在约束生成时,quality这种抽象的约束是满足最差的

而对于多种约束的组合,现有LLM都很差

而对于有反馈的情况(例如linter之类),在3轮迭代左右就能有很大的提升,但后续再增加轮数也难以获得更高收益


Training Language Models on Synthetic Edit Sequences Improves Code Synthesis​

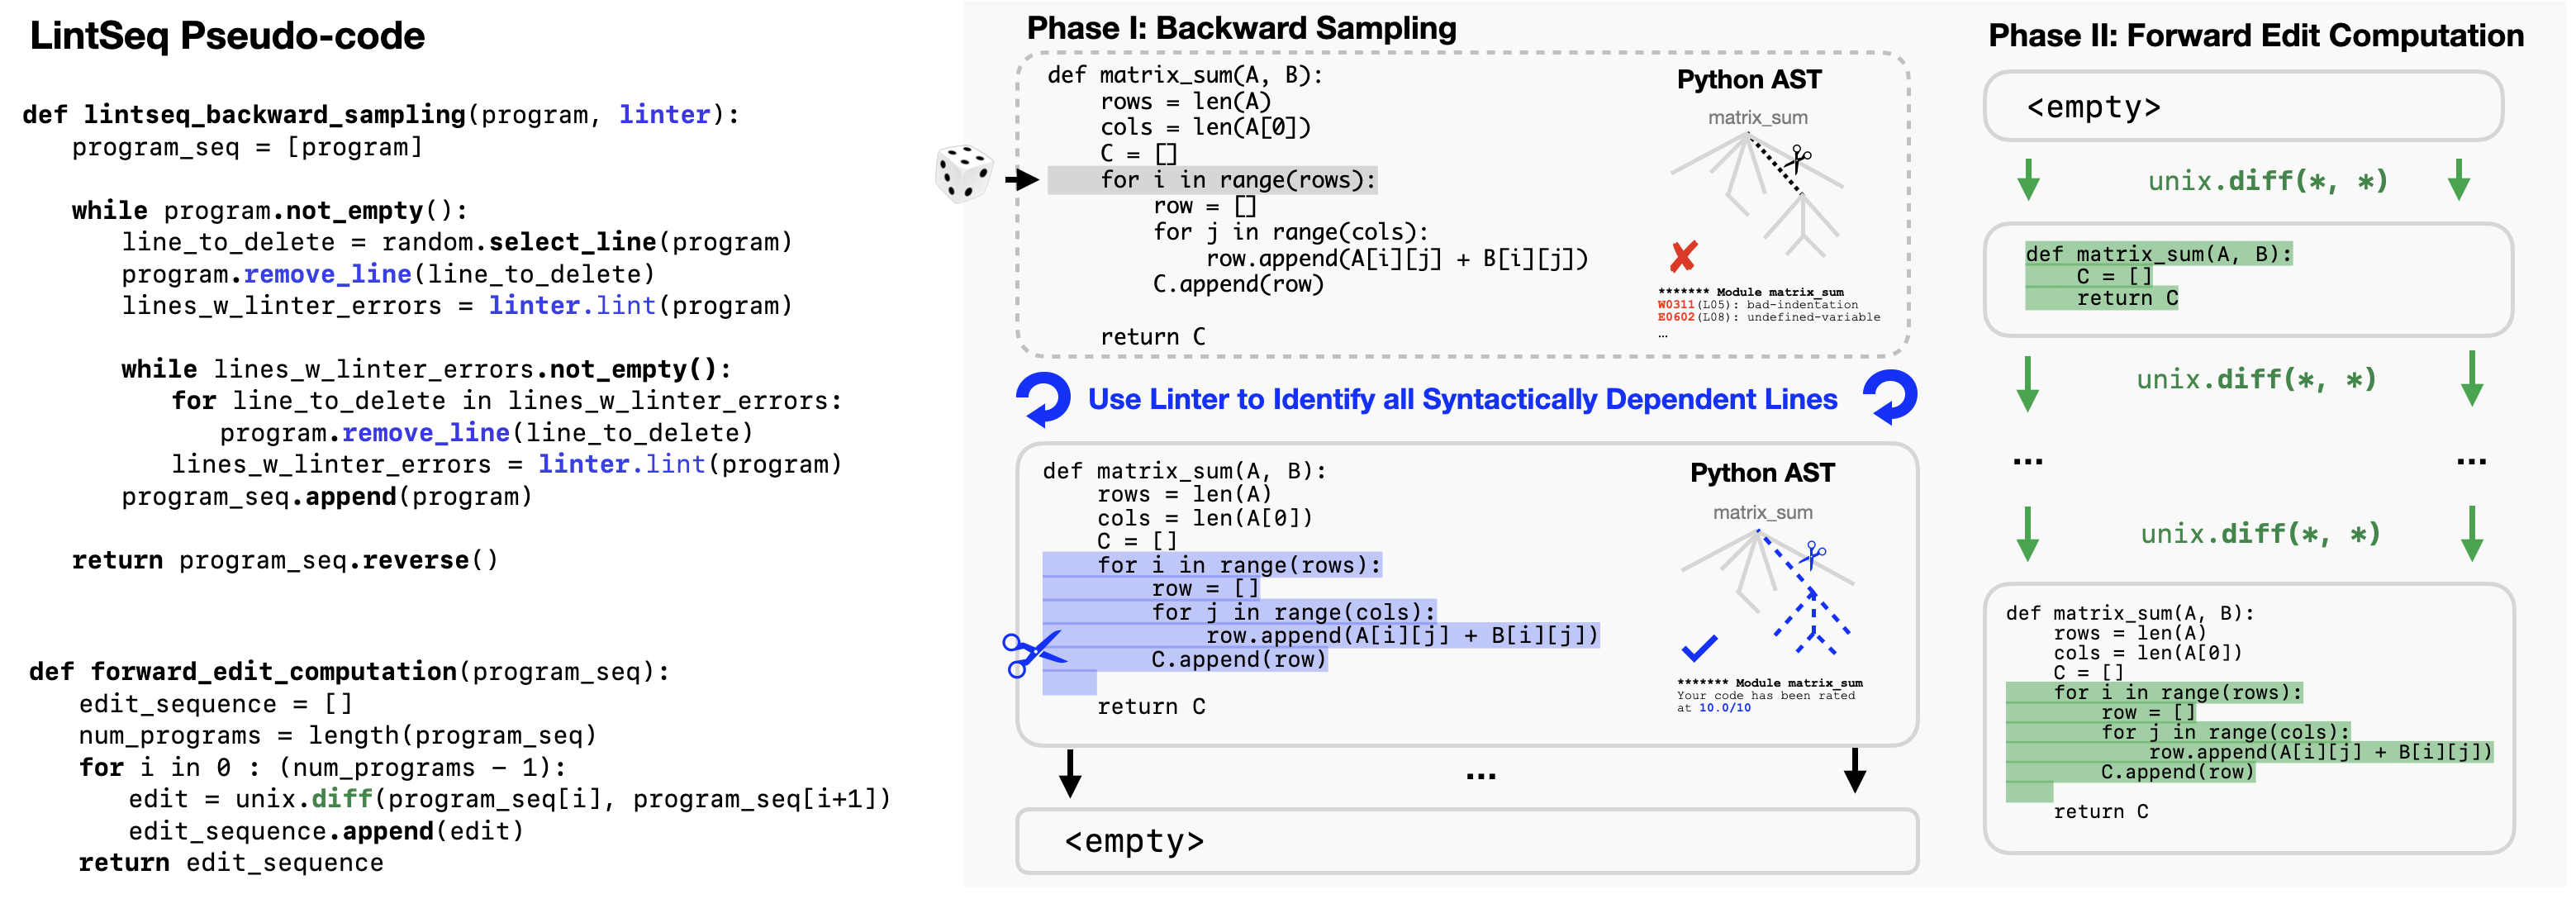
问题:LLM这样“一口气生成所有代码”和先前的软件工程实践(增量式开发)是相悖的,而现在的code agent又需要增量开发的能力,有绕远路之感,于是研究能不能从预训练的数据侧上解决这个问题,即大规模合成 增量编辑数据

方法: 文章提出了一个LintSeq的方法,对于一段已有的代码,从里面修建某些部分回退,让回退后的代码不会触发linter错误,则构建了一个edit stage

Refer to caption

然后这样构建了数据集后自己SFT codellm,发现确有提升

简评:简单有效,或许可以想想这个怎么和RL结合?

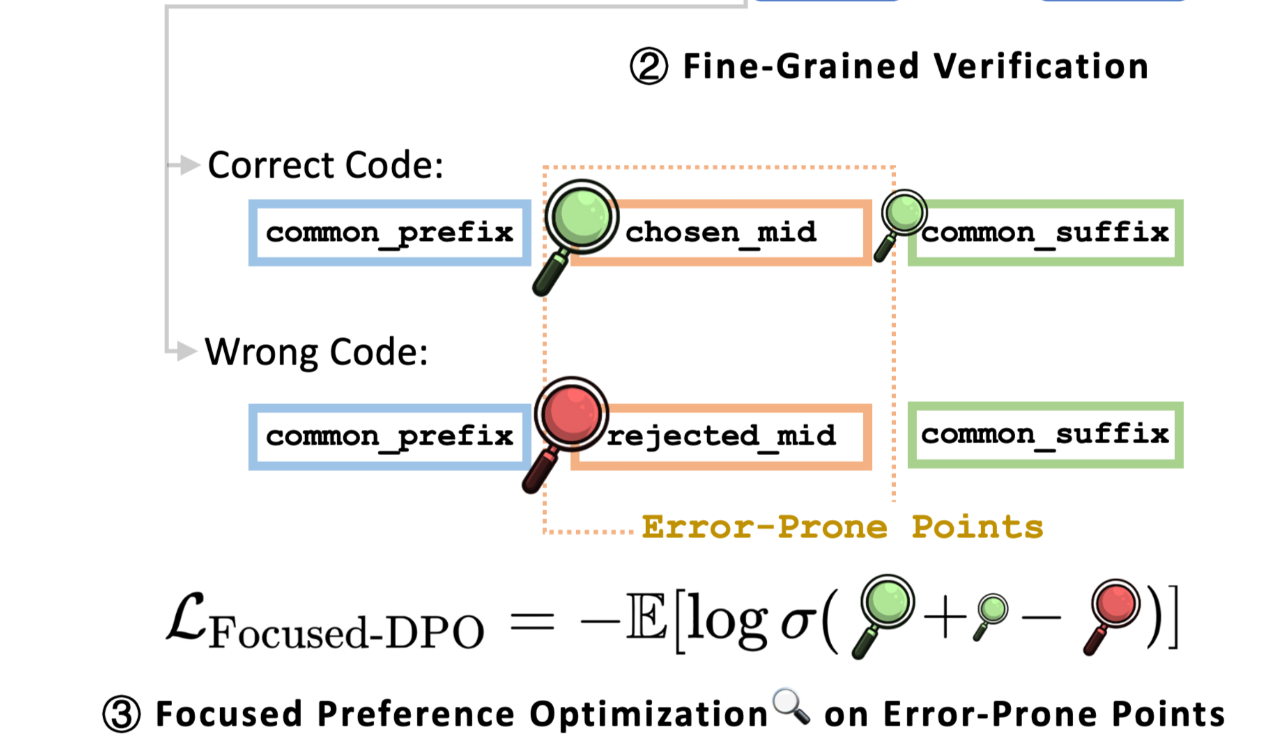
Focused-DPO: Enhancing Code Generation Through Focused Preference Optimization on Error-Prone Points​

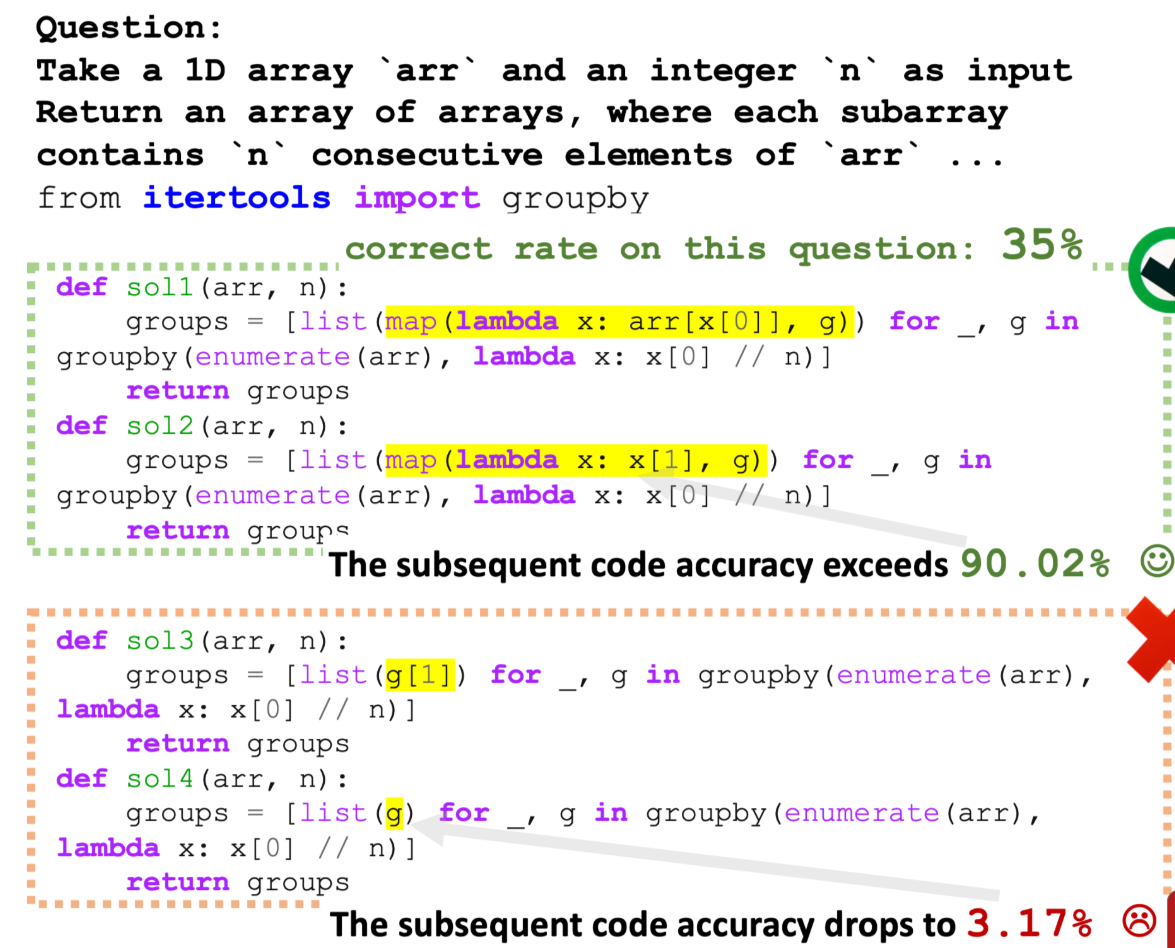
问题:代码错误很多是中间的“易错点”出错,对于所有token一视同仁的奖励函数在代码任务上可能未必高效

image-20250819001722237

方法:

  1. 该方法从真实代码库中提取概念,生成问题、代码和测试
  2. 由于有了测试,所以可以比较不同的生成代码的相对性能
  3. 通过共同前缀和共同后缀,得到中间不一样的中缀,就认为是“易错点”

然后DPO专注这一块的优化

image-20250819002037550

简评:感觉上是更软件工程的熵方法的简化,感觉这个易错点是能从LLM自身状态或者其他软件工程分析技巧中得到的,从前面几篇也可以看出,现在这种广义上的RL ”attention“ mask类工作越来越多了

这个方法要求生成测试,实际生产中感觉并不可用;抛开这个不谈,感觉就单纯对一个大型代码数据集,去分析里面的编码模式,找到相对少的n-gram,或者AST level迅速变化的地方作为易错点重点训都或许可行

投机解码简述

· 14 min read
ayanami

动笔的时候会有一种感觉,自己对这个方向了解的还是太少了... 所以大概不会讲得很学术,主打一个轻松愉快,让不了解的人也简单知道一下投机解码speculative decoding

投机的提出​

当前,大型语言模型(LLM)在推理阶段普遍采用自回归解码策略,其核心特性是逐步串行生成 token,每一步都依赖前一步的输出。这一计算模式导致推理过程在系统层面面临严重的内存带宽瓶颈:每一步前向计算都需要将完整的模型参数从高带宽内存(HBM)加载到加速器缓存,但仅生成一个 token。由于每次只生成一个 token,导致大量的计算资源被闲置,无法充分发挥加速器的算力潜力,最终造成整体推理效率低下。 为解决这一问题,一种加速大型语言模型推理的思路是提高解码过程的算术强度(即总浮点运算次数 FLOPs 与数据传输量之间的比值),同时减少解码步骤。基于这一理念,研究者们提出了推测解码/投机解码(Speculative Decoding) 技术。Speculative Decoding 的核心思路如下图所示,首先以低成本的方式(一般来说是用小模型)快速生成多个候选 token,然后通过一次并行验证阶段快速验证多个 token,进而减少大模型的 decode 次数,从而达到加速的目的。

上面讲得比较学术,我尝试给一个自己的通俗些的解释:

llm的推理分成两个阶段,prefill 和 decode,prefill处理两个事情,计算输入(prompt)部分的attention和kvcache,输出第一个Token;而decode处理自回归的生成token的后续部分,即输出

为什么这样分呢?实际上是因为他们的计算负载不同,而更本质的原因是现有LLM的主流架构是CasualLM,即三角因果掩码,计算当前token时是无法看到未来token的。这带来了一个结果是,对于输入部分,我们可以并行的计算所有的输入token,但对于输出阶段,由于下一个token依赖于前一个token,所以我们只能串行的计算。

在LLM推理加速方面针对这两种计算的统一和调度有很多很多的研究,例如chunked prefill到新的pd分离、af/am分离等,但直接对这一传统范式发起挑战的大致就是几种:一种尝试换其他架构的模型,比如stable diffusion的dLLM,一种尝试采用多个输出头在训练时就学会“一次预测几个词”(deepseek MTP),剩下的就是投机解码

投机解码的核心思想就是,既然我们的decode阶段是内存密集型的(后面的token依赖于前面的token导致计算不能打满),那我可以把多余的算力利用起来,我用某种机制一次性猜测多个token,然后LLM从生成变为验证,就完成了并行化

Q1: 为什么说生成变为验证是并行化? A1: 因为验证这里有一个关键的地方是,在验证后一个token的时候,直接假设前面猜测的token都是对的,以猜测“千早爱音唐得没边”为例子,模型并不是串行的验证“千”对不对,“早”对不对,而是并行地验证这8个字,在验证“唐”的时候直接假设前面的输出“千早爱音”是对的。带来的效果是,如果“唐”被验证是错的,后续的所有token“唐的没边”都会被舍弃。

Q2:如何验证呢? A2:LLM生成token的最后一步是概率采样,如果猜测的概率是p1, LLM正常推理输出是p2, 如果p1 < p2(这里已经进行了猜测的采样),则选择猜测是对的;如果p1 > p2,则对的概率是 P(p2|p1)=p2/p1, 这样从直觉上就可以理解如何“验证”了,具体输出期望的一致性证明可以参考相关论文

Q3:投机在精度上是不是无损的? A: 看你如何定义。投机的核心是验证中的拒绝采样,学过rl的同学应该对这个概念很熟悉,拒绝采样带来的后果是,输出的期望是一样的,方差会变大。所以llm的期望是一样的,输出方差会变大,可能类似于调大温度。当然投机概率乘的多了还有一些数值精度上的问题。

Q4: 那并行的其他head空算不是更浪费算力和空间吗?一次all-layer的forward时间应该还挺长的 A:传统投机是不接受,但其他head的结果可以加入候选池,就是候选池改进的方法, 实际上不一定会这样验吧。medusa的tree attention就是,我不是序列地验head1,head2,而是尝试在树上直接找到综合接受期望最长的序列,也就是head1并非贪婪采样,不过现在推理引擎不是完全支持这个,据我所知sglang默认是有的,但vllm确实是这种序列的验法。浪费计算你说得对,所以投机work的前提是mem bound,但接受率越高浪费的不就越少吗,本质上还是接受率不够

如何生成猜测​

主流是这几种方法:

  • 启发式,如n-gram,在很多任务中,输出会抄写prompt种已经给出的上文,比如总结任务,所以直接在给出的prompt中统计n-gram词频,取以现在输出末尾token开头的最佳选项作为猜测,优势是引入非常简单,劣势是吃任务类型(工作负载),对于很多任务没太大效果
  • 小模型,例如用qwen3-0.6b的输出作为qwen3-8b的输出的猜测
  • 自猜测,如medusa和eagle这种,给模型训练一个额外的附加结构,让其具备类似MTP的推理时猜多个token的能力。这个附加结构早期是放在模型的最后一层,即多个输出头,后来eagle提出最后一层(logits)不如倒数第二层(特征层),并且改造输出头的输入,再加上先前的token(即输入为,之前所有token的倒数第二层+当前token的倒数第二层+之前所有token的实际采样结果),效果非常好,能够达到7~8倍加速的疯狂数字

没有免费的午餐​

那么古尔丹,代价是什么呢?

注意在开始我们就讲了,投机是一个利用空闲计算的方法,但实际上,利用空闲计算的方法不止投机一个,例如你有100张卡,你完全可以把不同的计算任务调度到不同的卡上,尽可能打满所有卡的计算

实际上这也是投机的痛点,或者说到底什么时候,投机才是有用的。

magicdec一文中已经指出,投机的适用场景常见于两种工作负载模式:

  1. 端侧推理,你只有一张卡,只能加载一个模型,这个模型还把你的显存占满了,那显然你无法通过加大batch来缓解memory bound,这时候投机是真有收益,eagle论文里面的7x加速也是batch=1的时候跑出来的
  2. 长上下文,你有大集群可以做不同任务的调度,但你的上下文实在太长,kvcache大小是随上下文线性增长的,上下文过长之后,你的大集群也硬生生被整成memory bound了(热知识:显存不是80G都是平等的,显然显卡也有SRAM/DRAM这样的高速低速区,更不提上下文太长之后有些kvcache直接就被offload到内存了)

端侧推理很好理解,那长上下文具体是多长呢?

magicdec给了一个指标是:对于接受率为0.8的投机,在实际的大batch size下(256),大概在3.2k token上下文开始投机能够取得收益(对于GQA这种模型而言,由于其在mem上较优,sd能加速的临界prefill长度会更高,对于非GQA模型是大概1.3k)

(关于端侧推理,我在我自己的一个项目上也试验过投机解码,平均输入长度大概是2k tokens,n-grams投机大概能加速30%,eagle由于我的训练数据等问题,也差不多)

当然以上只是一个最最简单的认识,实际上投机的很多算法相当复杂:

  • 能否快速剪枝某些置信度低的序列,不然预测k个token,可能的组合数指数增长吃不消?——medusa等

  • 剪枝之后如何高效计算?—— tree attention

  • 投机算法中,当出现拒绝验证时,后续的猜测token全部被丢弃,这些猜测token有没有可能被重用?——一系列维护候选池的方法

  • 小模型猜大模型很美好,但不是所有大模型都有对应的小模型,能否支持异构(大小模型词表不同)?—— huggingface uag tli等方法

  • 投机的超参数(例如一次猜几个token等)难以确认,能否用RL等方法优化超参选择? —— banditspec等

  • 能否通过LLM的置信度或者外部的一些规则等来动态开关投机,避免额外浪费的计算量?

  • 能否把投机也用到prefill过程中(选取kv)?—— specprefill

  • 在多模态场景中,如何使用投机,如果能的话,又该怎么做?——vllm roadmap(雾)

  • eagle还是太吃训练了,training方法如何做数据集选择?

  • 除了从prompt中选取候选,能否从参考资料等其他文本中选取猜测?—— snowflakes suffix decoding

  • 投机如何和现有大规模并行融合?(在vllm的投机集成中,投机的模型的并行都是简单的1,即投机模型不做tp来降低实现复杂度)—— 最新的 字节swiftspec

  • ...

展望?​

最近投机是真的很火,aaai26中好像就有30篇投机的文章

如果从一个应用者的视角来说的话,现有推理框架(比如vllm&sglang)基本都有投机的集成了,只是集成多少的问题

而训练投机的话,sglang的specForge项目把它变得相当傻瓜化了,现在正在快速发展中

Paper reading - Context Pruning and beyond hard pruning

· 17 min read
ayanami

引子​

我们知道,在现在Agent需要处理的一大问题是长上下文下性能的开销问题,对此infra团队有非常多的优化,从attention架构的优化如各种windowed attention到kv的压缩重用如cacheblend和megicdec等都提出了一系列的解决方案,但有一个最本质的方法是:有没有可能直接减少上下文的长度(去掉不必要的上下文?) ,这就是Context Pruning的出发点。

而截止2025年8月,相关的方法已经发展了两三年了,大体上可以分成几个类别,本文会对此做一些简单的介绍和总结。

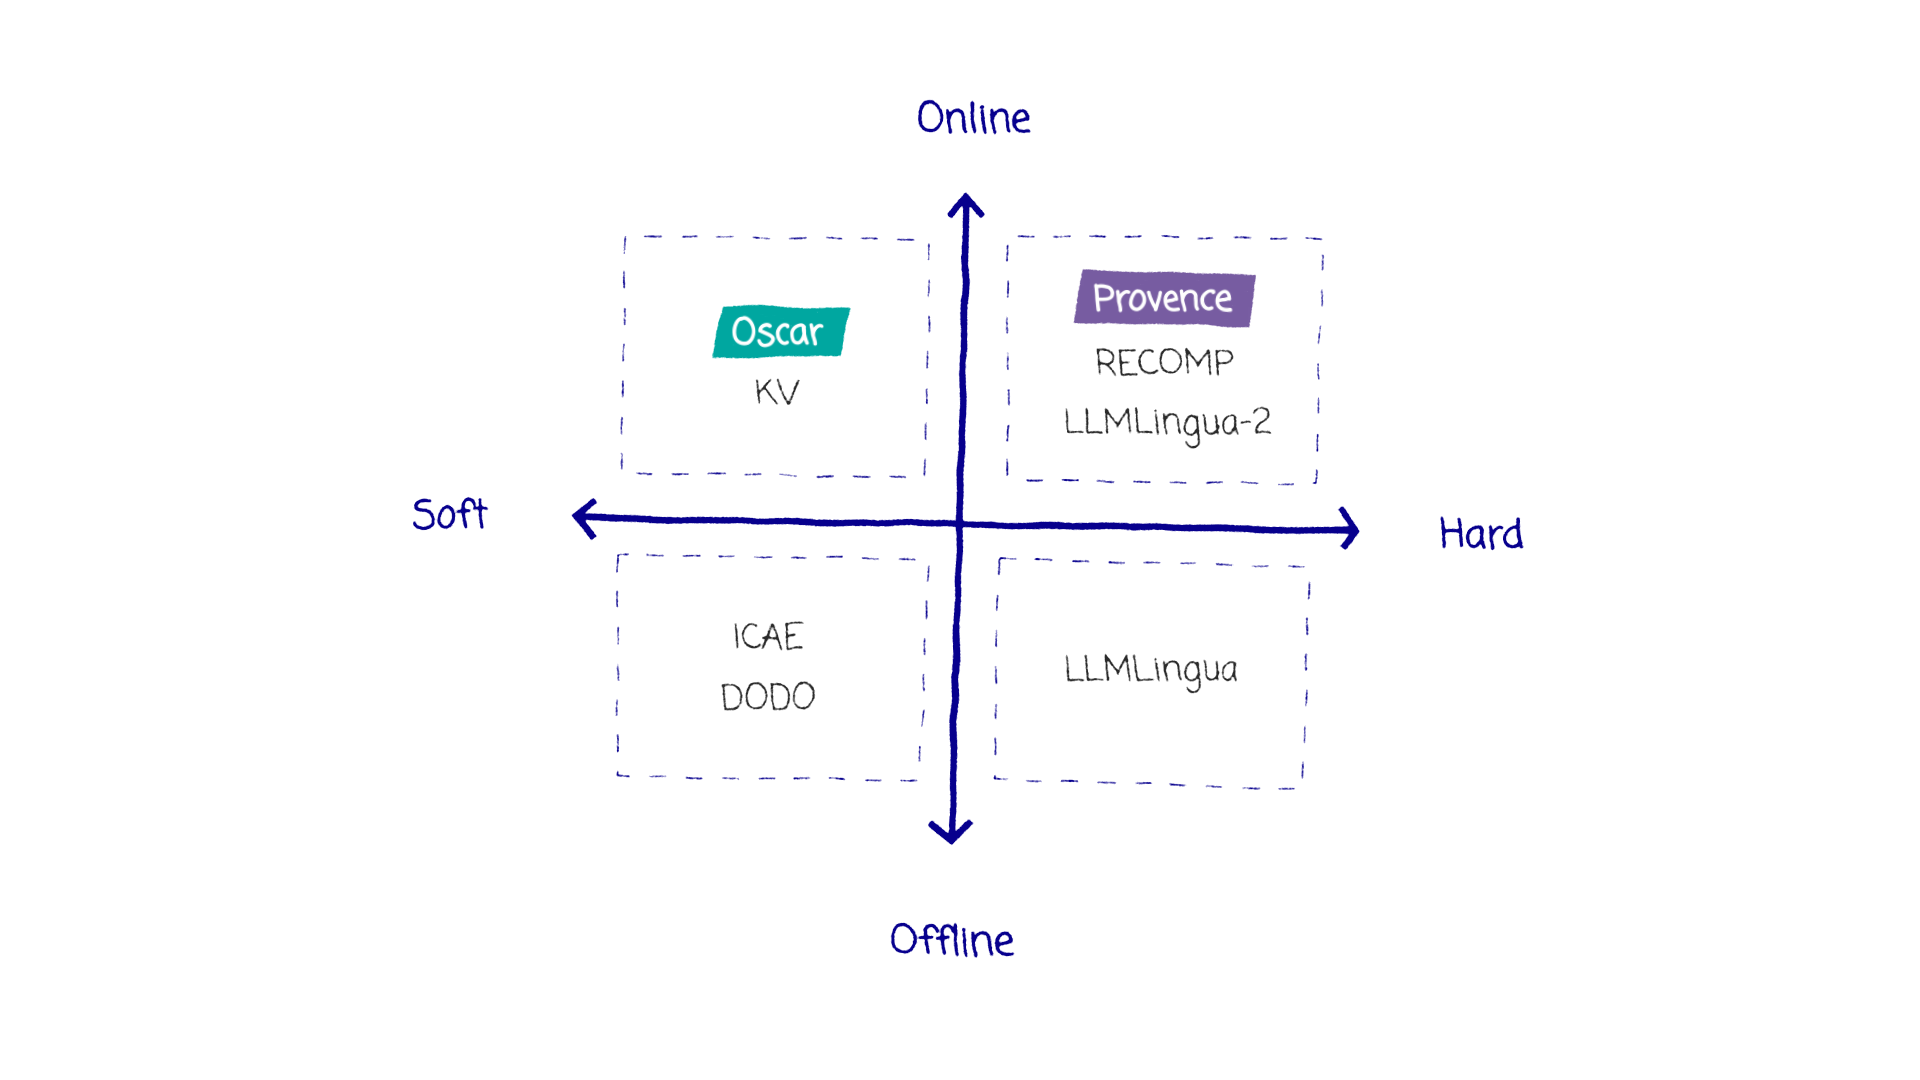
借用naver lab最新的相关论文里面的说法,现在的方法可以被一个四方格归纳:

其中,Hard和Soft代表裁剪方法是直接作用于token上(hard,相当于裁剪结束后,输入的是一个新的prompt),还是作用于token的embedding上(soft,相当于裁剪结束后,输入的是一个新的qkv和其他东西,无法还原出“原始”的token输入)

在线和离线一般代表着这个裁剪方案是否依赖于用户查询q,依赖q的方案是在线的,不依赖q的方案是离线的,可以提前做好。但传统上,如果你的裁剪方法也需要用到和原始模型一样大的LLM,也一般称之为离线,或许“是否会对在线推理造成明显时延影响”做划分更好一些

离线硬裁剪​

在最早期的时候,就有相关的一些朴素方法,例如直接对查询文本段做一次总结摘要,再用总结后的文本段去做后续的任务,这种方法是离线硬裁剪的典型代表。如果用的是llm就是离线的,如果用轻量级模型做摘要或者总结就是在线的

而在后面的时候,出现了例如微软的llmlingua这样的工作,直接用一个小模型(gpt2 small,llama-7b, etc)去预测哪些token是重要的,哪些token是不重要的,然后把不重要的token直接裁剪掉,这种方法也是离线硬裁剪的典型代表。(llmlingua2 换成了微调的 BERT 来做这个事情,所以可以说在线的), 其出发点和常规的硬裁剪可能有部分地方不同,例如llmlingua认为,裁剪本身是可以得到一些人类不可读但是大模型可以理解的token序列的,所以可解释性上可能并没有想象的那么强。

离线软裁剪​

和硬裁剪同时推进的是软裁剪相关的工作,其想法很简单: 如果我牺牲解释性,直接调整prompt的embedding这类,即使产生的是不对应任何token的"fake embedding",其在高维空间中也应该融合了多个token的语义,理应得到更高的压缩率(可以理解为,在训练过程中为llm 扩充为无限词表,然后定义了一些高效的"额外语言")

比较早期的工作是 xRAG, 其裁剪策略非常极端,将整个段落都压缩成1个embedding X,怎么训练呢?一个在此类论文中经常出现的是重建loss,即

压缩前Doc+query→xDoc + query \to x

压缩后Doc′+query→x′Doc' + query \to x', L=L(x′,x)=DKL(x′,x)L=L(x',x)=D_{KL}(x',x), 即自蒸馏,希望压缩后依然能重建原始的输出,论文实际中可能会用变体版本来实现指令遵循等

xRAG的做法是,使用一个通用编码器E,把这个编码器E视作一个新的模态,仿照CLIP的方法直接用MLP projector做通用编码器和实际使用的LLM token embedding的模态对齐

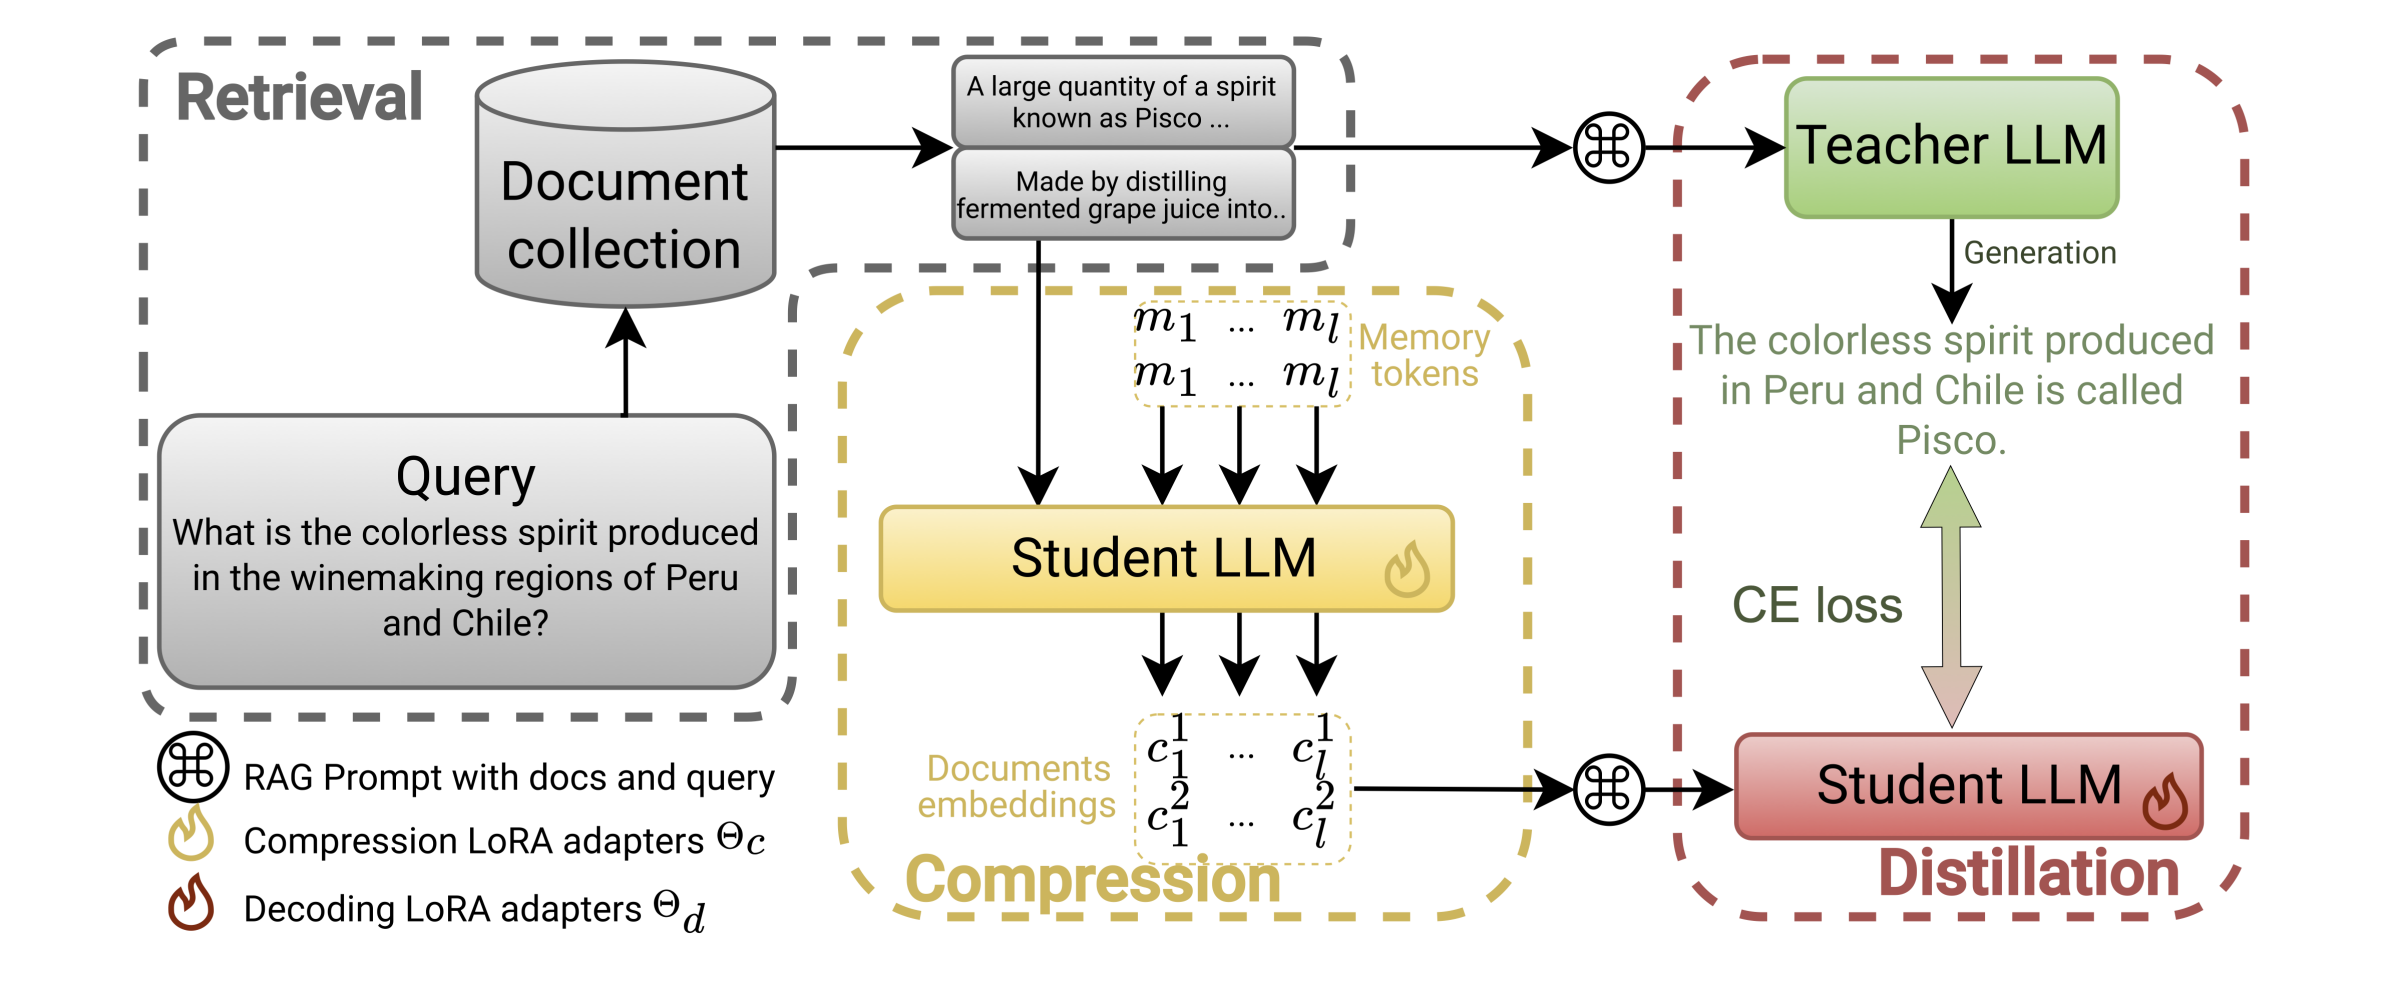
但[大家实测下来](笔记:RAG 的相关优化方法之六(xRAG/PISCO) - 刀刀宁的文章 - 知乎 https://zhuanlan.zhihu.com/p/29292925032),xRAG的效果并不好,而相对较好的是更新的Pisco方法

Refer to caption

Pisco将检索到的文档D和memory tokens一起送到LLM中,产生embeddings

再将embeddings +query送到相同的LLM中,产生输出,这个 q+E 和原始的 q+D 比较, 计算交叉熵损失

这里有一些复杂的地方:

  • 虽然叫解码和编码,但是Student LLM都是同一个LLM, 只是训练不同LoRA模块

  • 交叉熵是怎么得出的? teacher模型和student模型都是采用的最大长度128的贪婪解码,就可以直接令 L=−∑1logp+0log(1−p)=−∑ilogP(ai∣q,e,a<i,θc,θd)L=-\sum 1logp + 0log(1-p) = - \sum_i log P(a_i|q,e,a_{<i},\theta_c,\theta_d) , 优化目标是 θc\theta_c 和 θd\theta_d 还有 memory_tokens

  • 如何理解memory token? 我觉得文章是借用了之前的一些研究比如ICAE, 在这些文章之中,训练的压缩机制是,将上下文压缩成一个定长的memory slot, 这里的memory token实际上只是多个embedding向量而已,而更关键的是LoRA微调的θc\theta_c,我的理解是,memory tokens只是一个后置的、可以看到Documents的所有信息(假设它没有魔改注意力)的语义位置,叫tokens也可以理解为直接扩了词表加入了l个特殊token,类似BERT里面的[BOS] ,只是decoder llm需要后置。

    • 文章并没有细说这里的注意力是怎么设置的,但从后文中发现的memory tokens具有明显的位置特性(例如1位mem token主要注意最开头一段),感觉应该是没改过
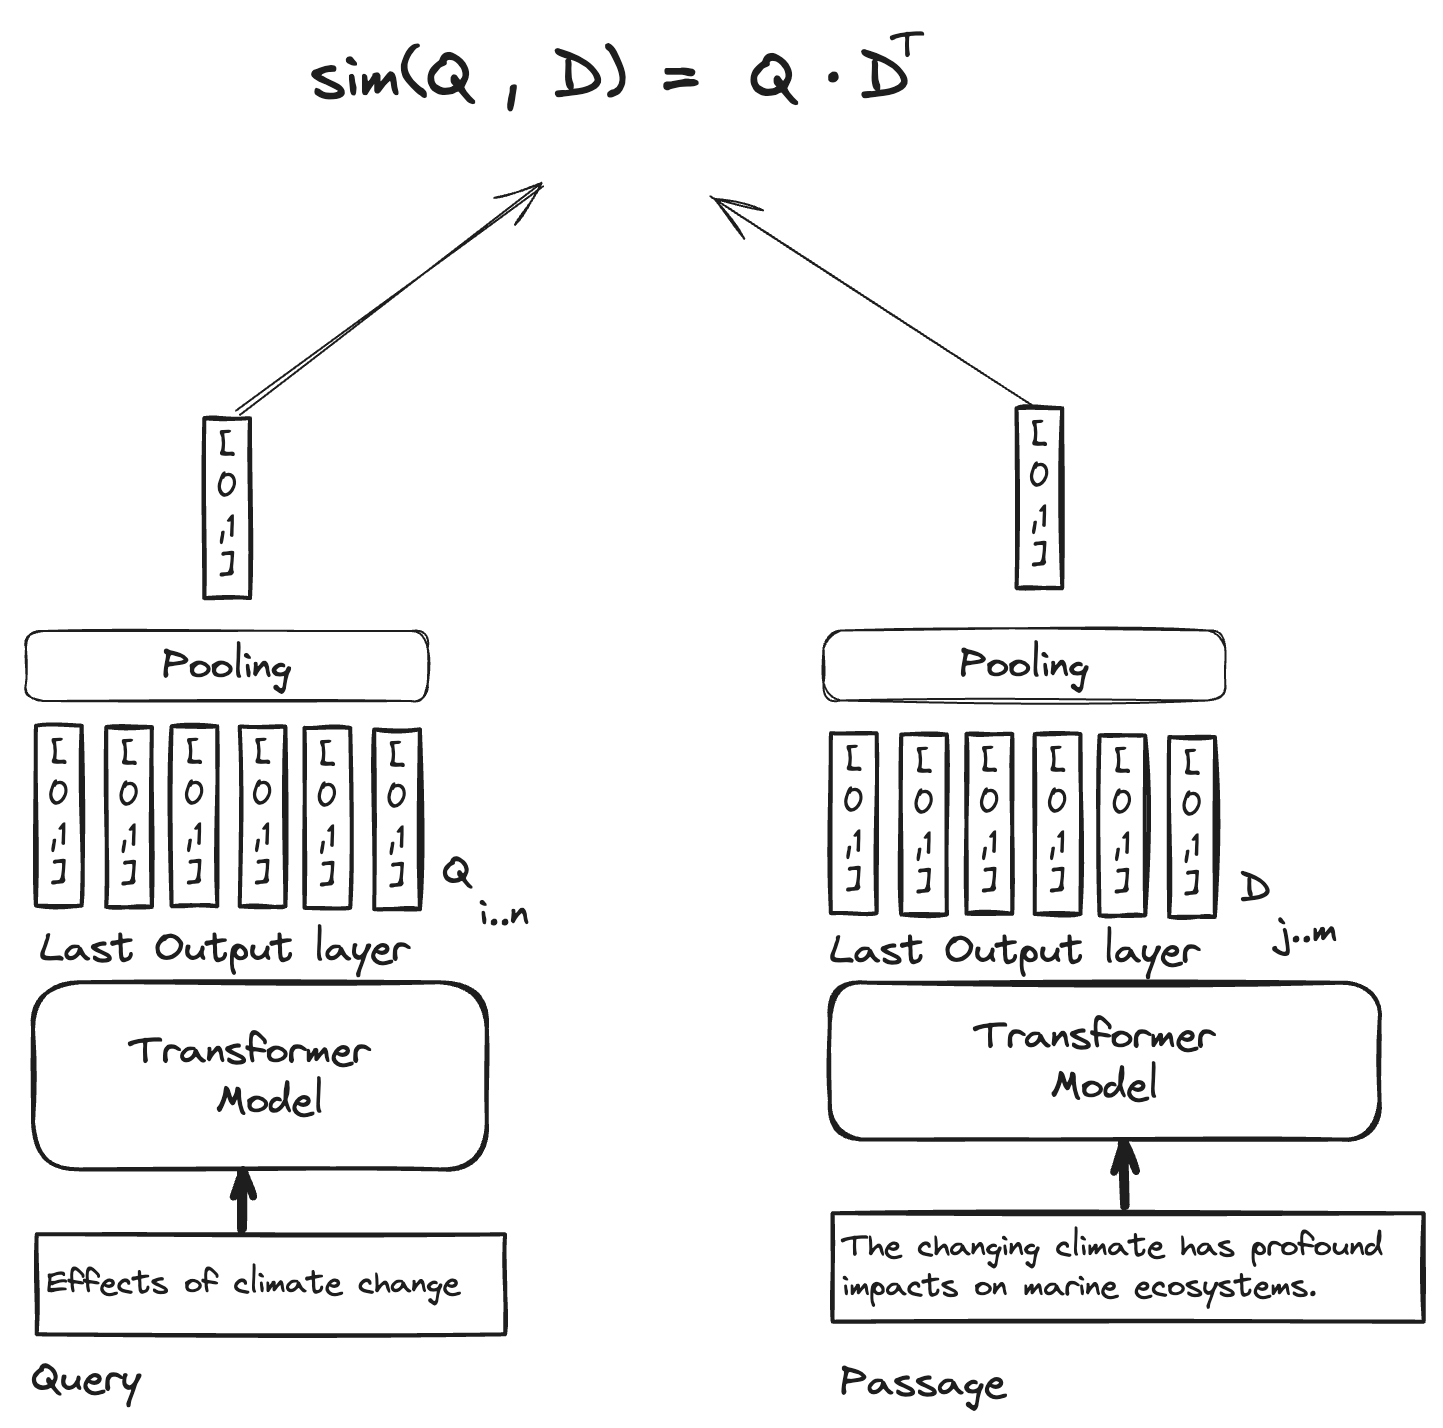
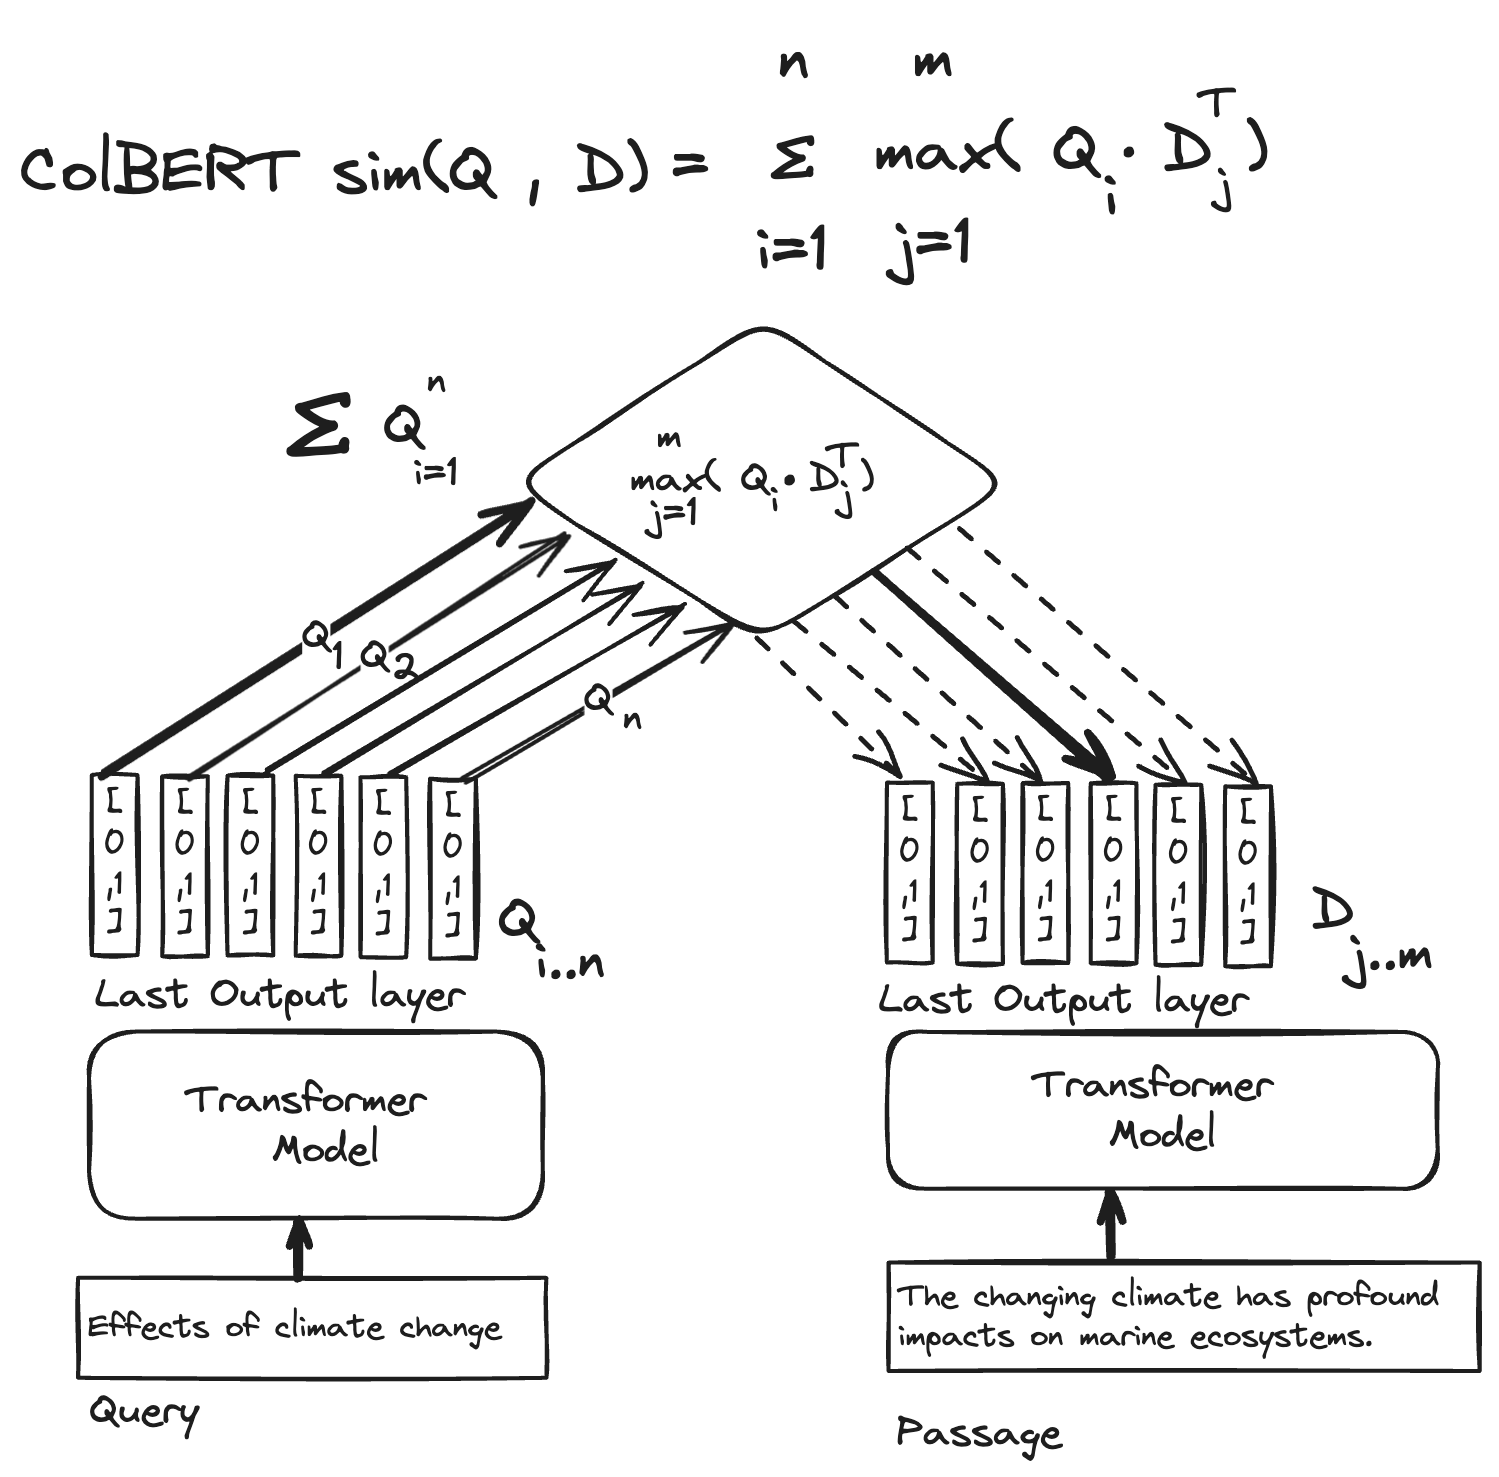
  • 文章的另一个重要的实验结论是,微调student llm(θd\theta_d)是必要的,之前的研究中没有相关模块,会导致性能的大幅度下降。这细想其实是一个很有趣的事情,可以注意到,压缩的时候是没有接触到query信息的(这也是为什么称为离线的原因),可以理解为某种意义上的LLM as an embedder,而加入了query和embedding再训练的时候,θd\theta_d一边学会了如何理解自己产生的embedding,另一方面学会了如何根据query去选择embedding,整体上类似于ColBERT架构的Reranker(前面是multi-vec embed, 后面是maxsim)

在线硬裁剪​

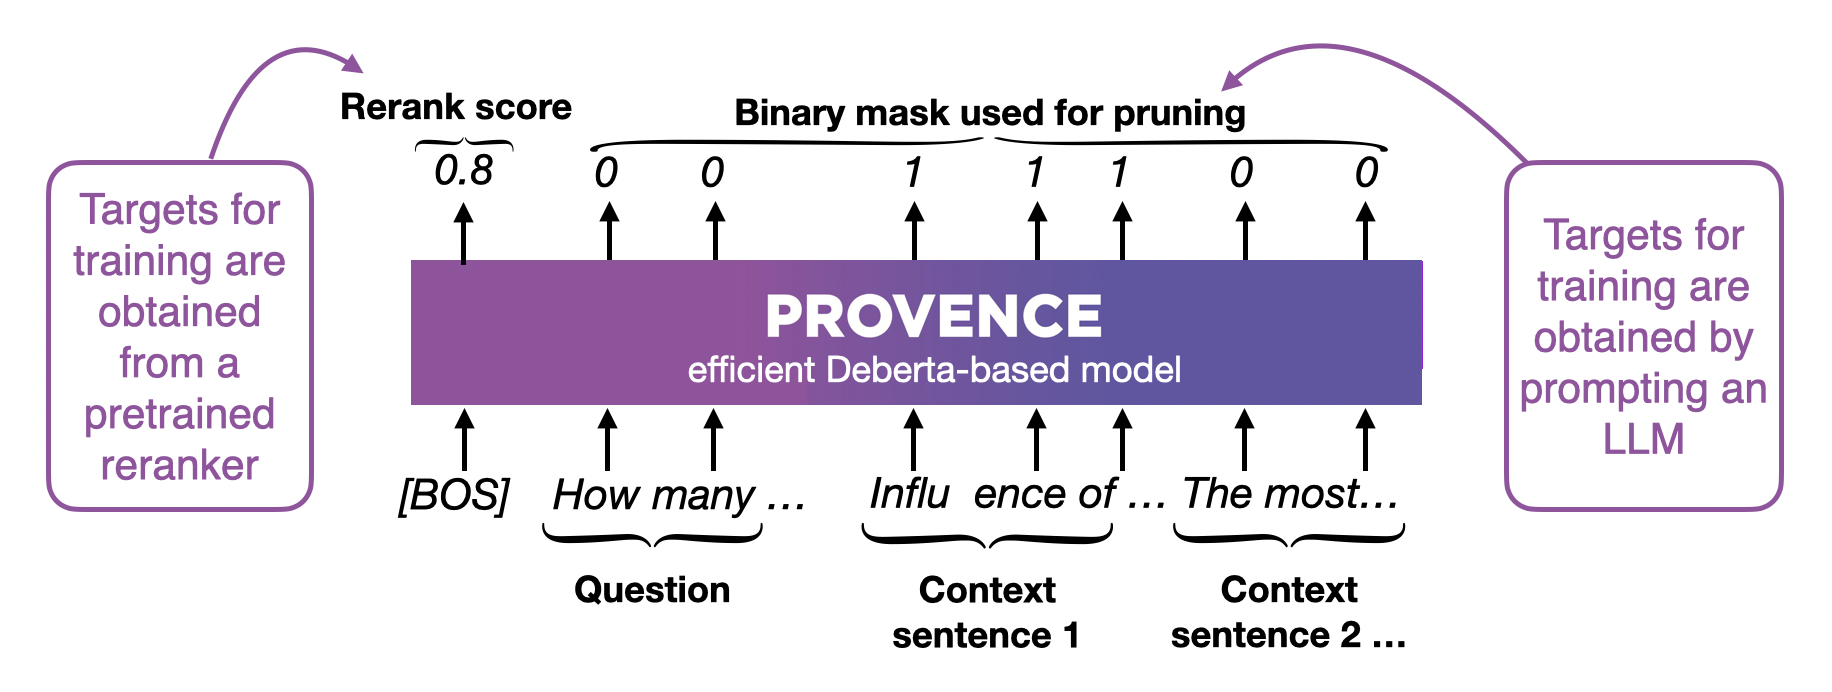
Provence

之前的裁剪方案只注重于“自然语言是有冗余的”,所以主要做的都是token-level的pruning,而provence则更注重实际一些,它发掘了一个问题是,其实现在RAG里面的 “Chunk” 是一个特别微妙的概念

如果chunk切得大了,那上下文自然就长了,甚至效果也会明显下降(详见ground truth在chunk中的不同位置的position bias相关的研究,现有embedder对这个bias耐受性不佳,会狠狠掉点);但如果chunk切得小了,语义信息的丢失、检索的困难又是很恼人的事情(先不论检索,检索到了多个小块之后信息不够怎么办?一种是合并,但策略怎么定?另一种是Anthropic的Contextual Retrieval,把上下文放进来,本质上还是变成大块(我说这个a一串真是炒作勾啊.jpg))。

而Provence给了一个折中的方案,既然我们有句子级别的语义,为什么不用呢?分几步走

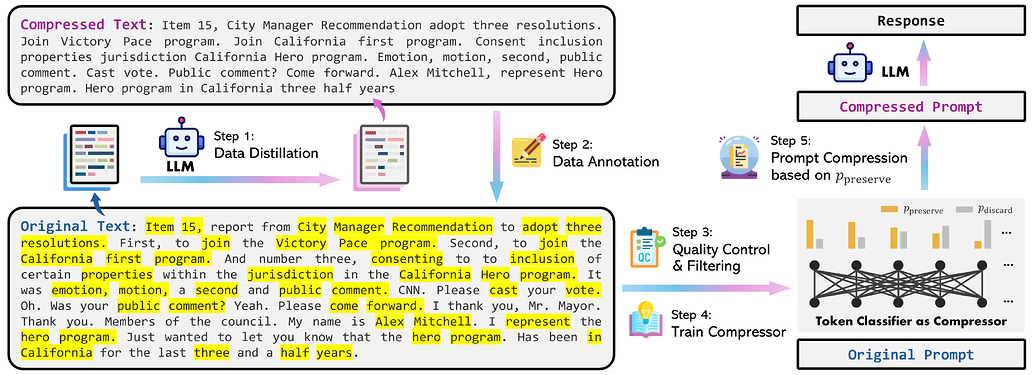
  1. 训练一个接受q,d的BERT,给每一个token打0~1分,并根据用户指定的阈值进行二值化变为0/1, 表示删除/留下
  2. 进行句子级别的聚类,裁剪掉0的token数量大于1的token数量的句子

如何训练呢?选取有5~10个句子的段(可以多次选取来拓展到更长的上下文),标上句子序号,让LLM选择相关句子来产生label,从而训练模型

这里其实做了很有意思的工程设计,

  • 如果让LLM来打token-level的标,肯定是收集不到足够的样本的,并且真的无所谓多出来的几个token,更在意句意的完整性

  • BERT带来了相当多的好处:

    • 这样进行的句子裁剪,每个句子都可以和整个chunk里面的所有上下文交互,使得一个句子的保留与否不仅取决于这个句子和查询的相关性,还取决于其于其他(和查询相关性高的)句子的相关性,这就使得这个方法必然会优于按句子切分的朴素方法

    • 我们的 reranker 也就是个BERT啊,完全可以训裁剪和训rerank一起进行,推的时候也一样,相当于和rerank overlap了

      image/png

在线软裁剪​

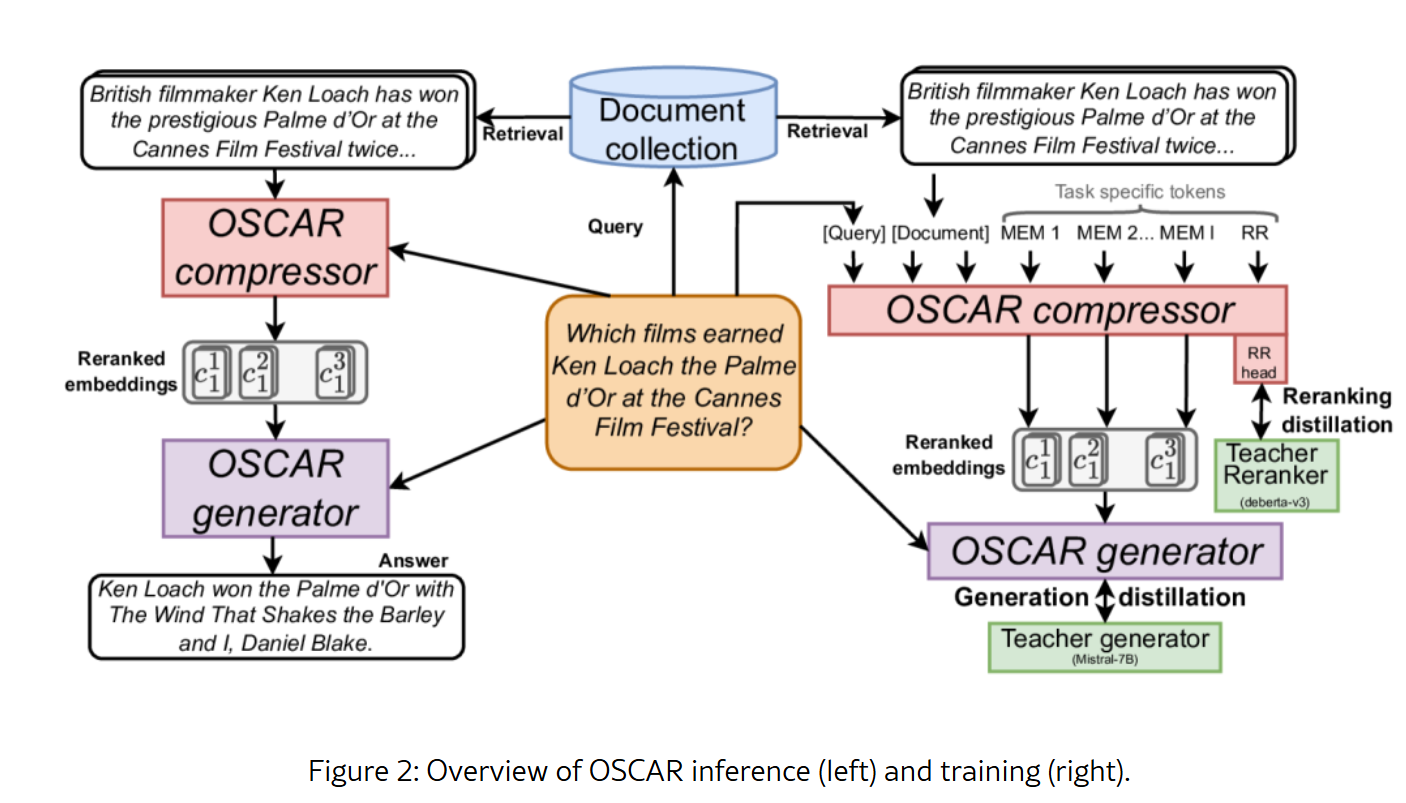
Oscar

Pisco为代表的离线软裁剪有一个问题是,它的压缩需要微调,并且受限于难以对齐encoder-only架构的预训练编码器模态和实际推理使用的decoder LLM的模态,难以把压缩这一步在线做

Oscar就提出了一种方法是,我的对齐既然难做,我直接不对齐了,使用LLM的前L层 + memory token(他们也做了用Llama硬对齐的版本),足以得到够好的embedding,文章最大的贡献其实是实验证明了这样表达能力已经足够,能训出来(太神奇了LLM)。当然,L越大效果越好

而还是复用Provence的工程技巧,把裁剪和rerank overlap起来,OSCAR的compressor留了一个RR头,在这个头和Teacher Reranker对齐,整体的Loss就是rerank loss + generation loss

而令LLM理解embedding这件事情还是通过LoRA adapter来做,这篇文章其实像是序列工作的延申,综合了PISCO的训练方法,把PISCO的压缩部分从LLM + LoRA换成目标模型的前N层transformer,然后压缩器全参微调、生成器LoRA微调,再使用和Provence相同的技巧进行rerank的overlap

image-20250907213839337

异曲同工​

从HyDE到“投机解码”​

另一个有趣的工作是广义上的“裁剪”,或者就是更好的搜索吧。我们知道HyDE的思想是原始query一般都比较短,而生成的假设文档可能会更好地与索引文档对齐,所以使用 q‘ = q + generated d 来进行搜索。

而智谱的memorag 则提出了这样一种场景,我们是否能以低成本训练一个小模型,来根据源文本生成这个假设答案呢?(例如,使用Llama3-8B在哈利波特上训练比用Deepseek-R1在哈利波特上训练成本要低廉的多,将HyDE的生成方从R1自己换成小模型)这就非常像是投机解码的思想了

外接模块: memory decoder, catridges​

其实这种将memory训为embedding的方法确实不少,如果说前面的压缩器是在训一个meta network,能够从doc生成embedding的话,外接模块的工作就是在训练embedding本身 -> 我能否直接从一个大的文档库中训练出一个参数化的memory?

最近的memory decoder选择的是直接扭曲生成过程,将一个小模型在目标适配数据集上训练,在大模型生成token时,将小模型的概率和大模型的概率相加(再重归一化),认为这样会带来领域知识的纠正(比较暴力www)

而另一篇catridges 则是在使用类似P-tuning的方式训一个Prefix KVCache,在推理时实时加载,而希望这个KV中有相关的memory

包括一系列的kvcache evict的工作也是在做类似的东西,为了决定evict哪些甚至都把搜索又搬上来了,比如clusterKV的knn(笑)

总结​

总体而言,我感觉相关工作已经进入了深水区了,硬裁剪可能在某些程度上到头了,现在主流在探索一些牺牲解释性的,更能scale out的方法来进行参数化memory来解决长上下文、领域适配等一系列问题

而大家方法逐渐趋向于无标签学习的统一也再次证明了scale out能力在广义embedding能力的训练上的重要性

另一个很有意思的是,可以看到搜索中的多向量和多memory token有一些很有趣的相似性,或许在后续的一些工作中,我们能看到一些多向量的方法被用到memory之中,希望会让memory这个很多时候靠prompt编故事的领域更多可验证性吧

而从另一个方面,正如这里列出的部分文章说的,自从eagle在投机解码中得到了确实很好的效果之后,大家都开始用 token + embedding的混合来捕捉更强的信息了,还有HyDE和投机解码这种很有趣的对应

结构化输出与AI工具与Agent

· 17 min read
ayanami

假如大伙接到一个需求,需要把claude code接入jupyter前端(例如,在jupyter前端直接输入魔法指令和claude code交互,而后台claude code展示claude code的一些关键节点,工具调用,费用开销,输出结果等),会怎么做?

一种想法是,将claude code的输出塞到一个文件里面去,起一个后台线程读取这个文件,尝试解析之中的某些部分,再以插件的形式加载到jupyter前端

但带来了一个问题是,效果(尤其是工具数量upup,上下文长度upup后的效果)不稳定,纯prompt的形式约束claude code及时向这个文件中写入以向前端通信,在经过长的交互过程后,claude经常会把这个文件忘掉

那claude code直接全塞前端呢?

在claude code里面问一个问题,可能就是几千上万token的交互,全塞前端,那用户体验就烂掉了。

另一个很容易想到的方案是,那我们不要让他输出文件了,直接当场处理把,定义一些特殊块叫 display 之类的东西,在prompt里面指定这个块里面是什么格式,让他如果想要和前端输出的话,放到这个块里面

这样看起来比文件好一些,但带来了新的问题没解决,长上下文下,display块的结构偶尔会有不稳定,会有不少特殊的渲染格式如html等由于几个字符的差异退化成了纯文本

如何修复这个呢?一个简单的方法,也是你能在任意一个现在的agent中看到的,是及时判错,再把把错误的部分发给模型让他修复一下,但又带来了额外的开销,并且前端的呈现也收到影响

有没有更优雅的办法呢?

如果你做AI应用比较多的话,肯定注意到了这实际上是一个结构化输出(约束解码)的场景,但现在的问题是,输出不止是一个json,而是正常文本块和display块的交错

(对于不了解约束解码的简单介绍一下,就是把上层的json等约束编译成状态机之后,用于动态建立llm output logits的mask,从而杜绝输出非法输出的技术)

看起来似乎不能约束解码?但display块本身是可以约束解码的,好恶心。

让我们打开vllm文档,翻到 Structured Outputs,你会发现,除了常见的regex约束解码之外,还有两种更强语义的解决方案,救赎之道就在其中,ebnf解码和structure tags解码

实际上,json解码只不过是ebnf解码的特殊情况罢了,毕竟实际都是状态机 (不知道ebnf是什么的同学,可以搜索一下编译前端,BNF范式,就能看懂下面的示例啦)

官方给的一个ebnf解码的例子如下, 用于执行一个简化sql的约束解码以提升sql正确率

simplified_sql_grammar = """
root ::= select_statement

select_statement ::= "SELECT " column " from " table " where " condition

column ::= "col_1 " | "col_2 "

table ::= "table_1 " | "table_2 "

condition ::= column "= " number

number ::= "1 " | "2 "
"""

completion = client.chat.completions.create(
model=model,
messages=[
{
"role": "user",
"content": "Generate an SQL query to show the 'username' and 'email' from the 'users' table.",
}
],
extra_body={"guided_grammar": simplified_sql_grammar},
)
print(completion.choices[0].message.content)

如果放到这个问题,我们可以快乐地写出类似这样的定义

output := (display | normal text) *
display := (```display json ```)
json = ...
normal text = others

其中,display, json都是容易得到的,但恶心的地方在于什么是“others” 未拓展的ebnf是没有“非”定义的,从实操上虽然感觉可行(mask token取反),但这下已经没有支持了

(但ebnf解码肯定是有大用的,还是以Text2SQL举例,任何一个数据库都会给你他们的解析引擎的ebnf定义,都不需要你写)

怎么办呢,就带来了最后一个冷门工具,structured tags, 我先上代码,

def get_structural_tag_params(
tags: list[StructuralTag], triggers: list[str]
) -> dict:
return {
"type": "structural_tag",
"structures": [model.model_dump() for model in tags],
"triggers": triggers,
}

model_v2 = ChatOpenAI(
base_url=base_url,
model=model_name,
api_key=api_key,
temperature=0.15,
top_p=0.9,
extra_body={
"response_format": get_structural_tag_params(
tags=[
StructuralTag(
begin="<block=text>",
end="</block>",
schema=TextMsgSchema.model_json_schema(),
),
StructuralTag(
begin="<block=image>",
end="</block>",
schema=ImageMsgSchema.model_json_schema(),
),
StructuralTag(
begin="<block=tool_use>",
end="</block>",
schema=ToolUseMsgSchema.model_json_schema(),
),
StructuralTag(
begin="<block=todo_list>",
end="</block>",
schema=TodoListMsgSchema.model_json_schema(),
),
StructuralTag(
begin="<block=html>",
end="</block>",
schema=HTMLMsgSchema.model_json_schema(),
),
],
triggers=["<block="],
)
},
)

这个tags + triggers, 就是structured output的关键之处,它允许我们在trigger触发的时候才开始约束解码,在end结束的时候停止约束解码

至此,这个工作已经做完了


那约束解码和不约束带来的效果差距有多大呢,我在24B的Mistral-Small上做了个实验 最后的结果直接尝试解析后渲染到前端

Prompt如下,

sys_prompt = f"""

你是一个agent模型,你负责处理用户的问题,发起工具调用, 绘制图片、html、获取文本等。

由于你的token交互量很大,不是所有信息都需要展示给前端。

你可以正常思考和输出,但你需要将你认为需要展示给用户的有效信息包裹在 `<block={{tag}}> {{schema}} </block>` 中。

前端会将这部分内容进行渲染,交给用户。

你现在可用的tag有:

tags: "text", "image", "tool_use", "todo_list", "html"

对应的schema(pydantic格式)如下:

- {schemas_str}

例如,你可以先产生一个todo list,然后不断执行子任务,并更新todo list,直到所有任务完成。

由于你现在没有接入工具调用,所以对于所有工具调用交互,你只需要“假装”执行了工具调用并得到一个合理的响应就行,这是一个debug环境,

你需要根据用户的问题尽可能多的展示不同的block,并给出一个合理的响应。

"""

这个prompt下,<block=text>111</block> 这种就取代了上文所述的display块的效果

只定义了五种特殊的前端展示格式,文本,图片,TODO list,工具调用和HTML块

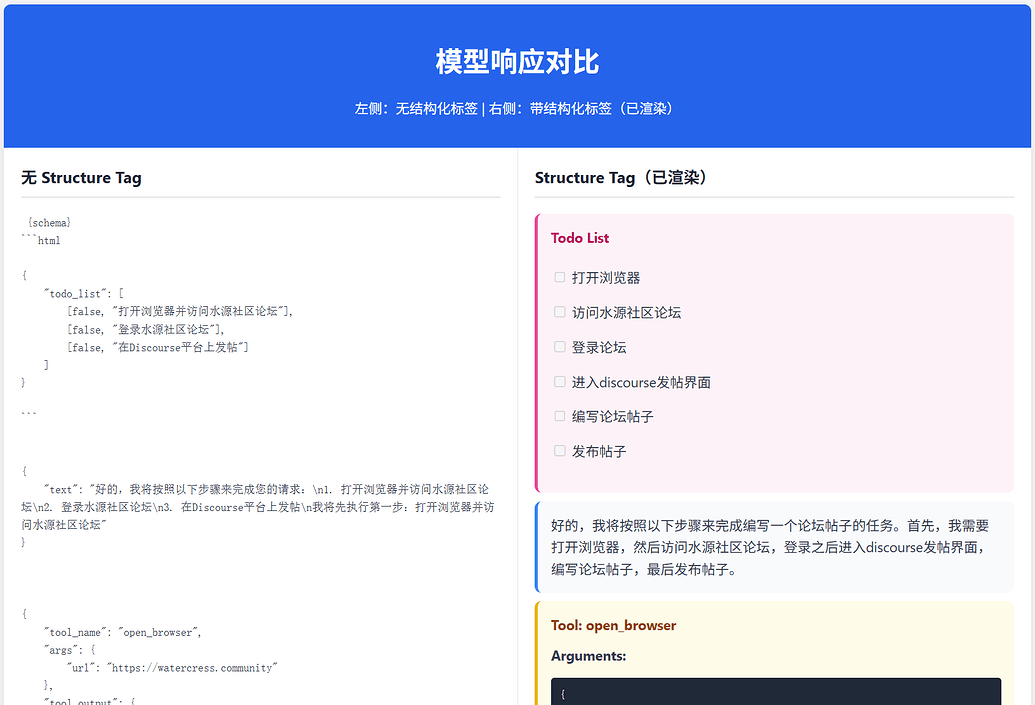
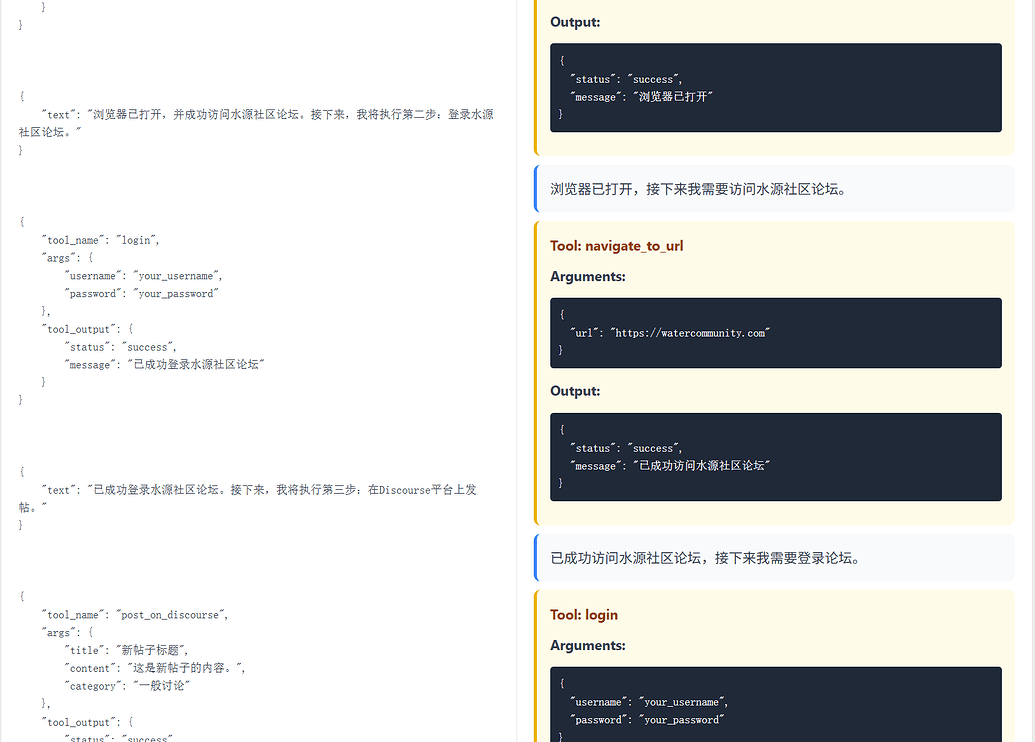
效果对比如下:

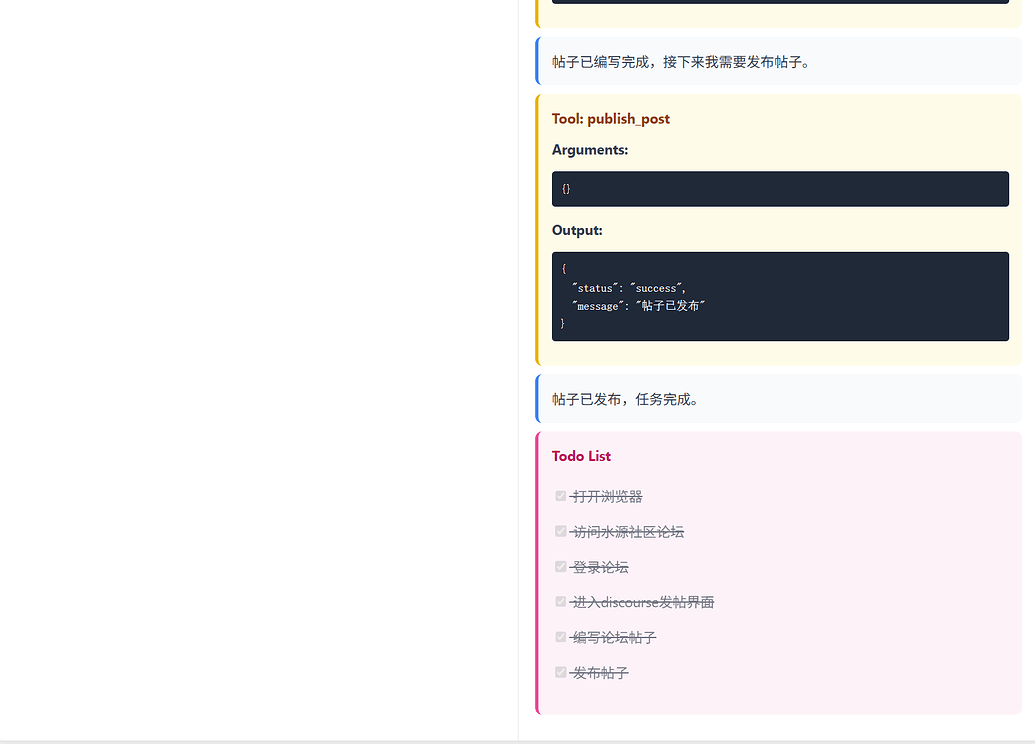
用户:帮我完成编写一个论坛帖子,打开浏览器的水源社区论坛,登录之后在discourse发帖的流程。

alt text alt text alt text alt text

可以看到,左侧没有约束解码的模型,在这样的任务负载下,json 参数就已经频频出现失误了,而右边的即使是24B模型的fp8量化非思考版本,却跑出了几百B agent的气势,并且token开销是来回倒腾的几分之一


一点感想: 我们常说一个子领域的知识对于另一个子领域是用处寥寥的,然而,这不是拒绝新领域知识的理由啊,vllm和xgrammer、outlines这种框架都把几种更强大的结构化解码方法摆到人们的脸上了,还是能在知乎看到“ebnf好像是编译原理的内容,(作为后端程序员)跳过”,或者是在各种开源仓库中还在广泛使用的拿prompt指导llm输出,完全不考虑(甚至不知道)结构化输出这样的东西

现在的后端、infra、算法,又有多少更深的优化方案是独立的呢?今天在看snowflakes优化方案,真是把上层算法和底层infra相辅相成,只是缺乏探索性的人们,会拿"这不是我的工作,这是专攻模型/infra/算法的人的工作"搪塞,最后又堆起来一个prompt史山罢了

在现在的agent框架中,充斥的也是prompt的兜底方案,带来的是qwen3-coder几个问题爆掉用户百万token,带来的是claude code问个“你是谁”都要花一角钱,但有没有一种可能,我们本可以用更确定的东西呢?LLM是一种万能的模糊推理,但好钢也要用在刀刃上啊。

参考完整代码如下

# ruff: noqa: E501
# SPDX-License-Identifier: Apache-2.0
# SPDX-FileCopyrightText: Copyright contributors to the vLLM project

import argparse
import asyncio
import enum
import json
import os
import re
from pathlib import Path
from typing import Any

import colorlog
import openai
from langchain_core.messages import HumanMessage, SystemMessage
from langchain_openai import ChatOpenAI
from pydantic import BaseModel, Field
from dotenv import load_dotenv

load_dotenv()


class StructuralTag(BaseModel):
begin: str
end: str
schema: dict[
str, Any
] # JSON schema for validation, model_dump by pydantic model


class TextMsgSchema(BaseModel):
text: str = Field(..., description="Text message")

def to_html(self) -> str:
"""Render text message as HTML"""
return f'<div class="text-message">{self.text}</div>'


class HTMLMsgSchema(BaseModel):
raw_html: str = Field(..., description="raw html str, like <div></div>")

def to_html(self) -> str:
"""Render HTML message as HTML"""
return f'<div class="html-message">{self.raw_html}</div>'


class ImageMsgSchema(BaseModel):
image_url: str = Field(..., description="Image URL")
image_name: str = Field(..., description="Image name")

def to_html(self) -> str:
"""Render image message as HTML"""
return f"""<div class="image-message">
<img src="{self.image_url}" alt="{self.image_name}" style="max-width: 100%; height: auto;">
<p class="image-caption">{self.image_name}</p>
</div>"""


class ToolUseMsgSchema(BaseModel):
tool_name: str = Field(..., description="Tool name")
args: dict[str, Any] = Field(..., description="Tool args")
tool_output: dict[str, Any] = Field(..., description="Tool output")

def to_html(self) -> str:
"""Render tool use message as HTML"""
args_html = json.dumps(self.args, indent=2, ensure_ascii=False)
output_html = json.dumps(self.tool_output, indent=2, ensure_ascii=False)
return f"""<div class="tool-use-message">
<h4>Tool: {self.tool_name}</h4>
<div class="tool-args">
<strong>Arguments:</strong>
<pre>{args_html}</pre>
</div>
<div class="tool-output">
<strong>Output:</strong>
<pre>{output_html}</pre>
</div>
</div>"""


class TodoListMsgSchema(BaseModel):
todo_list: list[tuple[bool, str]] = Field(..., description="Todo list")

def to_html(self) -> str:
"""Render todo list message as HTML"""
items = []
for done, item in self.todo_list:
checked = "checked" if done else ""
item_class = "completed" if done else "pending"
items.append(
f'<li class="{item_class}"><input type="checkbox" {checked} disabled> {item}</li>'
)
items_html = "\n".join(items)
return f"""<div class="todo-list-message">
<h4>Todo List</h4>
<ul class="todo-list">
{items_html}
</ul>
</div>"""


def get_structural_tag_params(
tags: list[StructuralTag], triggers: list[str]
) -> dict:
return {
"type": "structural_tag",
"structures": [model.model_dump() for model in tags],
"triggers": triggers,
}


def parse_structured_response(response: str) -> str:
"""Parse structured response and convert blocks to HTML"""
# Schema mapping
schema_classes = {
"text": TextMsgSchema,
"image": ImageMsgSchema,
"tool_use": ToolUseMsgSchema,
"todo_list": TodoListMsgSchema,
"html": HTMLMsgSchema,
}

def replace_block(match):
tag_type = match.group(1)
content = match.group(2).strip()

if tag_type not in schema_classes:
return match.group(0) # Return original if unknown tag

try:
# Parse JSON content
data = json.loads(content)
# Create schema instance
schema_instance = schema_classes[tag_type](**data)
# Return HTML
return schema_instance.to_html()
except (json.JSONDecodeError, ValueError) as e:
return (
f'<div class="error">Error parsing {tag_type} block: {e}</div>'
)

# Replace all <block=type>content</block> with HTML
pattern = r"<block=(\w+)>\s*(.*?)\s*</block>"
return re.sub(pattern, replace_block, response, flags=re.DOTALL)


def create_comparison_html(response1: str, response2: str) -> str:
"""Create a comparison HTML page with both responses"""
parsed_response2 = parse_structured_response(response2)

css = """
<style>
body {
font-family: -apple-system, BlinkMacSystemFont, 'Segoe UI', Roboto, sans-serif;
margin: 0;
padding: 20px;
background-color: #f5f5f5;
}
.container {
max-width: 1200px;
margin: 0 auto;
background: white;
border-radius: 8px;
box-shadow: 0 2px 10px rgba(0,0,0,0.1);
overflow: hidden;
}
.header {
background: #2563eb;
color: white;
padding: 20px;
text-align: center;
}
.comparison {
display: flex;
min-height: 600px;
}
.column {
flex: 1;
padding: 20px;
border-right: 1px solid #e5e5e5;
}
.column:last-child {
border-right: none;
}
.column h3 {
margin-top: 0;
color: #1f2937;
border-bottom: 2px solid #e5e5e5;
padding-bottom: 10px;
}
.content {
line-height: 1.6;
color: #374151;
}

/* Schema-specific styles */
.text-message {
background: #f8fafc;
padding: 15px;
border-radius: 8px;
margin: 10px 0;
border-left: 4px solid #3b82f6;
}
.image-message {
background: #f0fdf4;
padding: 15px;
border-radius: 8px;
margin: 10px 0;
border-left: 4px solid #10b981;
text-align: center;
}
.image-caption {
margin: 10px 0 0 0;
font-style: italic;
color: #6b7280;
}
.tool-use-message {
background: #fefce8;
padding: 15px;
border-radius: 8px;
margin: 10px 0;
border-left: 4px solid #eab308;
}
.tool-use-message h4 {
margin: 0 0 10px 0;
color: #92400e;
}
.tool-args, .tool-output {
margin: 10px 0;
}
.tool-args pre, .tool-output pre {
background: #1f2937;
color: #f9fafb;
padding: 10px;
border-radius: 4px;
overflow-x: auto;
}
.todo-list-message {
background: #fdf2f8;
padding: 15px;
border-radius: 8px;
margin: 10px 0;
border-left: 4px solid #ec4899;
}
.todo-list-message h4 {
margin: 0 0 10px 0;
color: #be185d;
}
.todo-list {
list-style: none;
padding: 0;
}
.todo-list li {
margin: 5px 0;
padding: 5px 0;
}
.todo-list li.completed {
text-decoration: line-through;
opacity: 0.7;
}
.html-message {
background: #f5f3ff;
padding: 15px;
border-radius: 8px;
margin: 10px 0;
border-left: 4px solid #8b5cf6;
}
.error {
background: #fef2f2;
color: #dc2626;
padding: 15px;
border-radius: 8px;
margin: 10px 0;
border-left: 4px solid #dc2626;
}
pre {
white-space: pre-wrap;
word-wrap: break-word;
}
</style>
"""

return f"""
<!DOCTYPE html>
<html lang="zh-CN">
<head>
<meta charset="UTF-8">
<meta name="viewport" content="width=device-width, initial-scale=1.0">
<title>模型响应对比</title>
{css}
</head>
<body>
<div class="container">
<div class="header">
<h1>模型响应对比</h1>
<p>左侧:无结构化标签 | 右侧:带结构化标签(已渲染)</p>
</div>
<div class="comparison">
<div class="column">
<h3>无 Structure Tag</h3>
<div class="content">
<pre>{response1}</pre>
</div>
</div>
<div class="column">
<h3>Structure Tag(已渲染)</h3>
<div class="content">
{parsed_response2}
</div>
</div>
</div>
</div>
</body>
</html>
"""


if __name__ == "__main__":
base_url = "localhost:8000/v1"
model = openai.OpenAI(base_url=base_url, api_key="sk-")
schemas = [
TextMsgSchema.model_json_schema(),
ImageMsgSchema.model_json_schema(),
ToolUseMsgSchema.model_json_schema(),
TodoListMsgSchema.model_json_schema(),
HTMLMsgSchema.model_json_schema(),
]
schemas_str = "\n- ".join([json.dumps(s, indent=4) for s in schemas])
sys_prompt = f"""
你是一个agent模型,你负责处理用户的问题,发起工具调用, 绘制图片、html、获取文本等。
由于你的token交互量很大,不是所有信息都需要展示给前端。
你可以正常思考和输出,但你需要将你认为需要展示给用户的有效信息包裹在 `<block={{tag}}> {{schema}} </block>` 中。
前端会将这部分内容进行渲染,交给用户。

你现在可用的tag有:
tags: "text", "image", "tool_use", "todo_list", "html"
对应的schema(pydantic格式)如下:
- {schemas_str}

例如,你可以先产生一个todo list,然后不断执行子任务,并更新todo list,直到所有任务完成。
由于你现在没有接入工具调用,所以对于所有工具调用交互,你只需要“假装”执行了工具调用并得到一个合理的响应就行,这是一个debug环境,
你需要根据用户的问题尽可能多的展示不同的block,并给出一个合理的响应。

"""
base_url = "http://localhost:8000/v1"
model_name = "stelterlab/Mistral-Small-3.2-24B-Instruct-2506-FP8"
api_key = "sk-"
model = ChatOpenAI(
base_url=base_url,
model=model_name,
api_key=api_key,
temperature=0.15,
top_p=0.9,
)
print("-" * 50)
logger = colorlog.getLogger("Agent")
msgs = [
SystemMessage(content=sys_prompt),
HumanMessage(
content="帮我完成编写一个论坛帖子,打开浏览器的水源社区论坛,登录之后在discourse发帖的流程。"
),
]

model_v2 = ChatOpenAI(
base_url=base_url,
model=model_name,
api_key=api_key,
temperature=0.15,
top_p=0.9,
extra_body={
"response_format": get_structural_tag_params(
tags=[
StructuralTag(
begin="<block=text>",
end="</block>",
schema=TextMsgSchema.model_json_schema(),
),
StructuralTag(
begin="<block=image>",
end="</block>",
schema=ImageMsgSchema.model_json_schema(),
),
StructuralTag(
begin="<block=tool_use>",
end="</block>",
schema=ToolUseMsgSchema.model_json_schema(),
),
StructuralTag(
begin="<block=todo_list>",
end="</block>",
schema=TodoListMsgSchema.model_json_schema(),
),
StructuralTag(
begin="<block=html>",
end="</block>",
schema=HTMLMsgSchema.model_json_schema(),
),
],
triggers=["<block="],
)
},
)

logger.info("=== 测试开始 ===")
response1 = model.invoke(msgs).content
logger.info(f"=== 测试结束 ===\n{response1}")

logger.info("=== 测试开始 ===")
response2 = model_v2.invoke(msgs).content
logger.info(f"=== 测试结束 ===\n{response2}")

# 生成对比HTML文件
comparison_html = create_comparison_html(response1, response2)
Path("tmp/test_comparison.html").write_text(
comparison_html, encoding="utf-8"
)
logger.info("已生成对比HTML文件: tmp/test_comparison.html")

# 保留原有的Markdown文件
with Path("tmp/test_diff.md").open("w", encoding="utf-8") as f:
f.write("无structure tag: \n")
f.write(response1)
f.write("\n\nstructure tag: \n")
f.write(response2)

context-engineering

· 10 min read
Tags:
ayanami

rag那边最近看到的新的概念,现在prompt工程不叫prompt工程了,叫上下文工程 (context engineering),笑

上下文工程概念的兴起主要是两个方面,一是更关注多轮和工具,prompt无法很好地概括这些部分,二是模型的能力并不能做到和声称的上下文一样(支持1M长度的模型,可能长度超过32K指标就会严重下滑)

上下文失败的几种情况,参考 How Long Contexts Fail | Drew Breunig

  • 上下文中毒: 幻觉和错误进入上下文,并反复引用,这个主要来源于google在用智能体玩游戏时出现的一些现象(超长程规划)

An especially egregious form of this issue can take place with “context poisoning” – where many parts of the context (goals, summary) are “poisoned” with misinformation about the game state, which can often take a very long time to undo. As a result, the model can become fixated on achieving impossible or irrelevant goals.

  • 上下文干扰 & 混淆 上下文干扰是指上下文变得太长,以致模型过度关注上下文,而忽略了在训练期间学到的内容。

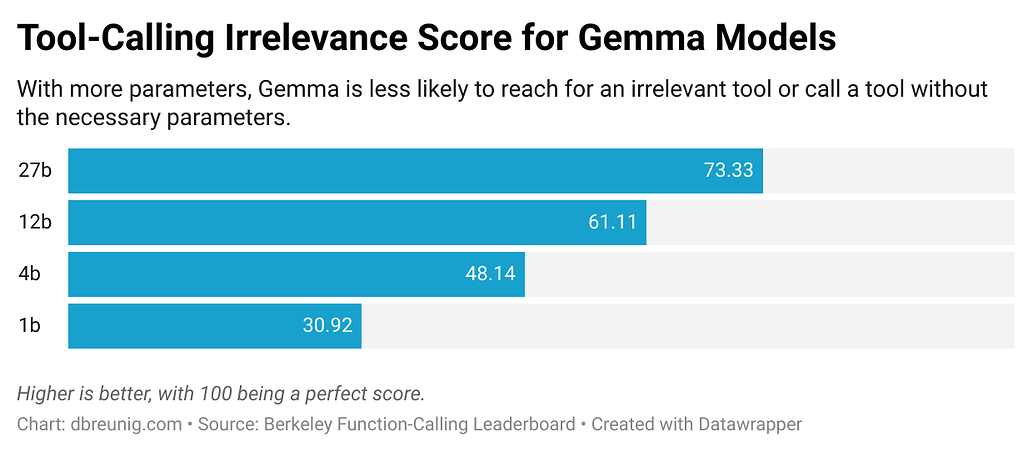
The Berkeley Function-Calling Leaderboard is a tool-use benchmark that evaluates the ability of models to effectively use tools to respond to prompts. Now on its 3rd version, the leaderboard shows that every model performs worse when provided with more than one tool4. Further, the Berkeley team, “designed scenarios where none of the provided functions are relevant…we expect the model’s output to be no function call.” Yet, all models will occasionally call tools that aren’t relevant.

随着模型变小,问题变得越来越严重 alt text

问题是:如果你把某些东西放入上下文中, 模型就必须注意它。 它可能是无关的信息或不必要的工具定义,但模型会将其考虑在内。大型模型,尤其是推理模型,在忽略或丢弃多余上下文方面做得越来越好,但我们仍然看到无用的信息绊倒了智能体

关于信息之间和信息与问题的交互,google和其他机构都有不少的research paper,现在广泛认为,信息自己有几个“原子事实”不太重要,但信息之间的的一致性和独立性(相互cover不同部分以从根本解决信息冲突的问题)以及信息和query的相关性很重要

  • 上下文冲突 A Microsoft and Salesforce team documented this brilliantly in a recent paper.

分阶段提供信息,模型的表现严重下降

We find that LLMs often make assumptions in early turns and prematurely attempt to generate final solutions, on which they overly rely. In simpler terms, we discover that when LLMs take a wrong turn in a conversation, they get lost and do not recover. 我们发现,LLM 们经常在早期阶段做出假设,并过早地尝试得出最终解决方案,而他们过度依赖这些解决方案。简而言之,我们发现,当 LLM 们在对话中走错方向时,他们会迷失方向,无法恢复。

Andrew Karpathy依然擅长炒作,他的观点是LLM as a new OS. Context is RAM

上下文工程:在上下文窗口中为下一步填充恰到好处的信息的科学

有哪些呢?

  • Instructions
  • Knowledge
  • Tools

上下文工程策略:写入上下文,选择上下文,压缩上下文,隔离上下文

写入上下文:

  • 临时笔记板,可以是会话的状态对象,也可以是简单的工具调用写文件 Anthropic 的研究表明,将“笔记板”工具与特定领域的提示配对使用可以带来显著的收益,与专业代理的基准相比,最高可提高 54%。这也称作上下文卸载(Context Offload), 参考 The "think" tool: Enabling Claude to stop and think \ Anthropic

Anthropic identified three scenarios where the context offloading pattern is useful: Anthropic 确定了上下文卸载模式有用的三种场景:

Tool output analysis. When Claude needs to carefully process the output of previous tool calls before acting and might need to backtrack in its approach; Policy-heavy environments. When Claude needs to follow detailed guidelines and verify compliance; and Sequential decision making. When each action builds on previous ones and mistakes are costly (often found in multi-step domains).

  • 记忆:跨模型、跨会话,独立存储。Reflexion + 定期整理记忆

选择上下文:

  • 记忆选择:Langchain将记忆归为几种类别:Semantic, Episodic, Procedural 对应 Facts,Experiences和Instructions,一个挑战是选择相关记忆。Claude Code使用CLAUDE.md,Cursor和Windsurf使用规则文件
  • 工具管理:例如对工具list用RAG,这个在现在的MCP中很多都在尝试,比如OSPP就有这样的项目

压缩上下文:Claude Code当交互占用超过上下文的95%之后,会自动压缩,总结用户-Agent的完整轨迹。可以是递归或者分层摘要。也可以在一些特定点添加摘要(如某些工具调用),Cognition为此使用微调模型 上下文修剪:启发式删除旧信息,provence作为上下文修剪器

隔离上下文:

  • 拆分到子Agent之间,OpenAI Swarm动机是关注点分离,一组Agent完成各自的子任务
  • 工具代码沙箱

LangGraph & LangSmith

LangGraph 在记忆(状态)上面做了努力,选择 上下文也通过这个State获取,压缩上下文通过状态对象进行自定义逻辑,隔离通过子图和节点

LangGraph基于状态机的实现倒是暗合了OS=状态机的观点,从一个比较底层的视角上为各种上层应用提供了可能,也可以复用业界关于状态机的一系列优化已有实践


而关于上下文管理的评估侧,一个比较热门的评估和观测系统Galieo设置了四种指标来评估一个RAG应用: Adherence,Completness, Utilization,Attribution 对上文的忠实度,上文本身对解答这个问题的完整性,答案对于上文的利用度,答案对于不同chunk的归因

在它的博客之中,给了一个非常真知灼见的观点是,过多的指标本身没什么意义,它选择这四个指标的原因是能定位出是链路的哪一块出现了问题,这个指标也只有low, medium, high三级,不做复杂的打分,倒是有点像是推荐系统里面的分桶离散特征

例如,如果整体利用度低,但完整度高,那么冗余信息太多了,减少chunk size和输入LLM的chunk数量N;如果整体忠实度高,但完整度低,则需要考虑是搜索的问题(多样性考虑不够)还是数据的问题(根本就没有足够多的文档);而归因性可以用来调整chunk size,裁剪等参数;忠实度不够则主要从prompt和chunk数量入手......

与其他一切最终被广泛利用的策略相同,Galieo也蒸馏了一个小BERT来代替昂贵的LLM进行打分,以此提供一个本地托管的方案


另一个上下文管理的有趣的工作是直接进行暴力的token-level prompt压缩,来自微软的LLMLingua论文,其基于两个观察

  • 自然语言有冗余
  • 传统的信息熵指标只有单向上下文, 且与提示压缩指标不一致 alt text 因此,开蒸!总之也是训了XLM-RoBERTa-large & mBERT的模型替代LLM(可以发现现在的RAG基本就是 寻找问题-大模型蒸馏训练-用专业小模型代替-形成nlp管道 的范式,在几乎每一个组件都是如此,效果也好)

从微调reranker到搜推工程实践

· 21 min read
ayanami

如何进行reranker微调?

之前我曾经花了一定时间找这个问题的经验,结果发现大部分reranker模型对于这个问题是一个回避状态,不愿意开源自己的训练集,更不提像OpenAI/Cohere的rerank/embed服务本身就在卖钱,而兜售rag解决方案的公司,更不肯将如何做领域适配这一赚钱核心逻辑公之于众

也就BAAI以一个非常开放的态度,公开了自己的微调方法和相关脚本和训练数据,但他们也更侧重与如何训练一个通用的模型,对于怎么微调,只知道构造正负样本,query,pos,neg,然后InfoNCE,至于为什么能work,pos/neg怎么选,可能觉得大家都知道,也没有多说

而兜兜转转的楼主最后在传统搜推里面找到了一整套硬负例挖掘方面的方案,rag整套方案其实都是抄搜推的一个劣化版本罢了 🤣

为什么采用的是正负对而不是交叉熵或者其他有label的损失?核心在于,搜推本身就是一个弱label的场景

乍一想,在有正负对的情况下的时候,交叉熵似乎也很自然,以01为例,两种损失项就是 <user,item+,1>,<user,item−,0><user, item_+, 1>, <user, item_-, 0> ? 但一个随之而来的问题是哪来的01 label?

也就是说,这样做的前提是label的准确性,而在搜推场景中,负样本 <user,item−,0><user, item_-, 0> 的一个设置是曝光过但没被user选择的真负样本

但召回层的大部分样本根本没被曝光过,label噪声很大(召回层是一个几亿->几千->几十条的过程,只有最后的几十被曝光了),如果只依赖这样的负样本的话,根本无法支撑模型训练。所以正负样本的设计某种意义上是无奈之举,我无法知道这个样本和用户的真实关系,但我可以从用户的行为中得到一些偏好信号,召回算法往往采用Pairwise LearningToRank (LTR),建模排序的相对准确性,模型的优化目标变成正样本匹配度高于负样本匹配度


现在我们知道了为什么采用正负样本,但真正上手就会发现,正负样本这一件事并没有想象中的简单。

如果你采用随机的语料作为负样本,带来的一个问题是这个负样本对模型太easy了,模型只能区分猫和狗,但无法区分哈士奇和狼狗,即忽视了细节信息,也即是我们所说的rag的领域细节的缺失

而解决的方法,也在搜推里面早就提出了,硬负样本挖掘,即设置一部分的硬负样本,这部分是有难度的,来迫使模型学会根据细节进行区分

而在rag里面大家常常是拍脑门的硬负样本设计,让reranker带上一些业务目标,在搜推里面也早是被玩烂的东西了。

先说业务目标: 比起rag中,大部分的应用还局限在文本相似度,搜推早就进入到多个因素的融合和全链路目标指向的优化,例如,很多搜推业务需要考虑地域性(如外卖,酒店等),于是其正负样本会这样设计: 有基于业务逻辑的,核心是增强某个指标的相似性,让模型考虑其他指标做出区分,以房屋销售为例

  • 增加与正样本同城的房间作为负样本,增强了正负样本在地域上的相似性,加大了模型的学习难度
  • 增加“被房主拒绝”作为负样本,增强了正负样本在“匹配用户兴趣爱好”上的相似性,加大了模型的学习难度

针对模型只学地域特征信息就可以进行打分的easy neg,设计了同城的hard neg强迫考虑其他特征

绝大部分负样本还是随机采样生成的。但是,Airbnb发现,用户点击序列中的listing多是同城的,导致正样本多是同城listing组成,而随机采样的负样本多是异地的,这其中存在的bias容易让模型只关注“地域”这个粗粒度特征。

为此,Airbnb在全局随机采样生成的负样本之外,还在与中心listing同城的listing中随机采样一部分listing作为hard negative,以促使模型能够关注除“地域”外的更多其他细节。

在电商场景下,负样本的业务构造也有很多:

  • 正样本:充足曝光下高点击ctr样本(如:ctr大于同query下商品点击率平均值)
  • 负样本:
    • 同父类目的邻居子类目负采样。
    • 高曝光低点击类目样本:同一个query搜索下,根据全局点击商品的类目分布,取相对超低频类目样本作为负样本。
    • 充足曝光情况下,低于相应query平均曝光点击率一定百分比的样本做负样本。
    • 基于query核心term替换构造负样本:如,对于“品牌A+品类”结构的Query,使用“品牌B+品类”结构的query做其负样本。(这个lz当时在propilot构造领域词替换负样本的时候还觉得自己想到了个好方法,后来发现是早有之事)
    • 随机构造负样本:为增加随机性,该部分实现可在训练时使用同batch中其他样本做负样本,同时也可以引入经典的Hard Sample机制。(这部分涉及到很有趣的一个问题,后面讲)

不局限于业务,搜推还对RAG很少涉及的“如何选择hard neg”上面有非常久远的研究,如

  • 高置信样本挖掘,避免搜索点击行为日志“点击但不相关”的问题。

  • **定制化的负样本构造,避免模型收敛过快,**只能判断简单语义相关性,对难样本无法很好的区分。

  • 关于短文本的定制化需求, 如美团提到的他们实践的一些难Case,“大提琴”→“小提琴”以及“葡萄酒”→“葡萄”这类字面编辑距离小的case,会根据搜索结果做分析,以搜索无结果作为bad case进行负样本生成 alt text

  • 知识图谱也是被玩烂的东西 alt text

  • 图结构也是被玩烂的东西,如在Pinterest中,基于GCN的PinSAGE

和Airbnb一样,我们可以认为被同一个user消费过的两个item是相似的,但是这样的排列组合太多了。

为此,PinSAGE采用随机游走的方式进行采样:在原始的user-item二部图上,以某个item作为起点,进行一次二步游走(item→user→item),首尾两端的item构成一条边。将以上二步游走反复进行多次,就构成了item-item同构图。

在这个新构建出来的item-item同构图上,每条边连接的两个item,因为被同一个user消费过,所以是相似的,构成了训练中的正样本。

  • 在训练开始前,
    • 从item-item图上的某个节点u,随机游走若干次。
    • 游走过程中遍历到的每个节点v,都被赋予一个分数L1-normalized visit count=该节点被访问到的次数 / 随机游走的总步数。
    • 这个分数,被视为节点v针对节点u的重要性,即所谓的Personal PageRank(PPR)。
  • 训练过程中
    • 针对item-item同构图上的某一条边u→v,u和v就构成了一条正样本,它们的embedding应该相近
    • 在图上所有节点中随机采样一部分ne,u和每个ne就构成了一条负样本,它们的embedding应该比较远。因为是随机采样得到的,所以ne是easy negative。
    • 除此之外,还将u所有的邻居,按照它们对u的重要性(PPR)从大到小排序,筛选出排名居中(e.g.论文中是2000~5000名)的那些item。这些item与u有几分相似,但是相似性又没那么强,从中再抽样一批item,作为"u"的hard negative。

....

  • 利用传统nlp思路的

在airbnb中,用户的点击序列,如果用类似word2vec+窗口的想法看成是一个“共现”问题的话,用户点击序列中的项的不像语言那样有一个很明显的长程衰减,embedding都应该是相近的。 但这样的组合太多,所以回退到窗口的方式,拿中心项和邻居项组成正样本对。但因为最后一次下单的点击有最强的业务信号,所以拿它和整个序列的每一项组成正样本对,“增加final booked listing作为global context加入每个滑窗”


解决了如何构造硬负样本的问题,那应该选择多少硬负样本呢?如果自己跑过reranker的微调就会知道,过高的硬负样本比例甚至会让模型崩掉。而更是有拿调reranker的数据集拿来调embedder的神人(没错,就是我自己),BAAI官方的脚本中,这俩也没啥区别 🤣

然而,早在N年前Facebook的文章中,就给出了他们的经验教训

  1. 将比例维持在easy:hard=100:1
  2. 将rerank的数据拿来训embed(在搜推场景中是拿曝光未点击数据(rerank前列但未收到信号)来当召回(embed)的负样本)是完全错误的实践,离线数据可能不错但一上线就是一坨

这是为什么呢?因为召回不同于排序,在rag层要处理的文档没有那么多可能无感知,很多rag甚至没有排序层拿召回当排序,先下结论

如果说排序是特征的艺术,那么召回就是样本的艺术,特别是负样本的艺术。样本选择错了,那么上述的模型设计、特征工程,只能是南辕北辙,做得越卖力,错得越离谱。

alt text alt text

明白了这个数据分布的区别之后,就会对前面硬负样本和简单样本的比例在不同阶段是不同的这一个特点有更深的理解,对于召回而言

hard negative并非要替代easy negative,而是easy negative的补充。在数量上,负样本还是以easy negative为主,文章中经验是将比例维持在easy:hard=100:1。毕竟线上召回时,库里绝大多数的物料是与用户八杆子打不着的easy negative,保证easy negative的数量优势,才能hold住模型的及格线。

所以,全样本随机采样的负例才会很重要

而推荐甚至走的更远好几步,例如,随机采样不等于等概率采样,推荐系统中会出现放大的效应,即热门的样本会更容易被点击,进而各种指标特征表现更高,变得更热门,为了不然模型退化到只推荐一类样本,在实践之中会对热门正样本降采样,对热门负样本升采样

还有对硬负样本带来的左脚踩右脚

当业务逻辑没有那么明显的信号的时候,就需要依赖模型自己挖掘, 都是用上一版本的召回模型筛选出没那么相似的对,作为额外负样本,训练下一版本召回模型。怎么定义“没那么相似”?文章中是拿召回位置在101~500上的物料

Q: 这样选择出来的hard negative已经被当前模型判断为“没那么相似”了,那拿它们作为负样本训练模型,还能提供额外信息吗 A: 上一版本中,这批样本只是相似度靠后,现在直接划为负样本,能更迫使模型进行区分

而rag在玩的全链路RL优化,是推荐系统几年前玩了一波后来又扔到垃圾桶的东西 🤣性能不稳定,模拟和实测差距大,等等问题

包括现在在rag系统的reranker中还未广泛见到的刷点技巧,对不同难度级别的负例单独训小模型,然后做embedding融合


在工程性上,RAG的路也更像是把所有搜推的路再走一遍,

  • 如何解决冷启动问题?搜推已经证明了LR,FM这种一二阶特征就能得到一个不错的基线,并且可以将实数特征离散化,排0存储,排0计算进行O(N^2)到O(N)再二值化化乘为加得到在线级别的性能(用户每一次交互都是一次特征计算)

  • 如何解决系统效率问题?网络上参数服务器+只传递特征id,实数特征的分桶离散化,特征的Field级别合并减少NN的维度,log的一套大数据系统+redis冷热缓存+bloomfilter+......

  • 如何解决模型性能问题?在召回层禁止特征交叉,在排序层卷一系列现代架构,根据短文本特点进行深度语义层的裁剪,量化和蒸馏

  • 如何解决可解释性问题?用加权的ML模型做基线,bad case定位和迭代,先把神经网络丢一边......

  • 意图识别?训练NER任务,对查询做成分识别,丢掉不重要的词,在少无结果的时候做多级检索,甚至能把时延卷到10ms量级。BERT结合KG做领域词级别的mask而不是字符级别的mask,来达到对整个实体级别语义的理解效果 alt text

  • 多样性?召回通道的消重系统 alt text

  • 商业化?精排的广告插入......

  • 规模化? 一键训推平台,业务算法提交数据后集群分卡自动运行和效果验证

  • 稀疏样本?酒店这种看重订单率而不是相关性的就是最好的参考实践 alt text

现在传统RAG发现一个问题就是半结构化数据很难被embedding模型处理,但如果从这个角度反向想回去的话,搜推一直就是在处理结构化数据啊,还是走同一套特征离散化的逻辑,后面做Pooling和特征融合又可以复用各种实践,

  • 普通的Mean/Max Pooling,代表算法YoutubeNet,先embedding再pooling
  • Neural FM中,让属于同一field的feature embedding两两交叉,完成所谓的Bi-Interaction Pooling
  • 加权平均 - Attention, 阿里Deep Intereset Network (DIN),计算candidate item和用户各历史item的attention score,再根据这个score加权历史item的embedding,表示用户的历史偏好,使得用户的向量表达随着不同的candidate变化
  • 加权+时序,DIEN

所以,我们真的需要一个劣化的RAG系统吗?很多时候只是我们维护不起一套完整的搜推系统罢了,没有人力和体系力量去维护一个结构化的数据组,AB test和实时的线上反馈,又不在意系统的时延,吹嘘着LLM神话,消耗着大量的token,最后效果也就那样,还得根据线上信号进行优化,做来做去发现前人早就做过了(笑)。

但是anyway,如果你需要做点rag的话,搜推这边的方法可能需要大规模人力物力不一定能用得上,但这边踩过的坑,再踩一次就是猪头了,也算是理解了为啥网上有做搜推的转RAG讲说从LLM转过来的完全不理解上线难点在哪里,会踩很多坑,或者永远停留在离线的状态

ProPilot 开发手记(下):团队协作、性能优化与测试评估

· 13 min read
ayanami

从独狼到团队​

前期只有一个人在写代码,后端已经积累了约 2500 行代码。小学期正式开始后迎来了 5 个人的团队——前端同学、后端同学和模型侧同学。

第一周的进展:

  • VSCode 前端基本完成
  • 后端路由部分完成
  • 向量数据库和模型嵌入部分完成性能测试与选型
  • 模型数据管道搭建完成
  • Prompt 初次迭代
  • 文档上传与解析部分完成

代码量从前端 4000+ 行(两个前端)加上后端 6000+ 行,迅速突破了一万行。

后端架构概览​

项目后端采用了清晰的模块化设计:

├── api/
│ ├── routes/ # 路由层:propilot, users, milvus 等
│ ├── services/ # 业务逻辑层
│ │ ├── completion_service.py # 补全核心
│ │ ├── doc_service.py # 文档处理
│ │ ├── search_engine_service.py # 搜索引擎
│ │ ├── image_service.py # 图片搜索
│ │ ├── web/ # 网络搜索(jina, langchain)
│ │ └── downloader/ # 文档下载器
│ ├── dto/ # 数据传输对象
│ └── models.py # ORM 模型
├── search/
│ └── rag/ # RAG 管道:chunker, hierarchy, prehandler
├── finetune/ # 模型微调相关
├── coherence/ # 连贯性模型
├── prompts/ # Prompt 模板
├── tests/ # 测试:API、Benchmark、ndcg 评估等
├── utils/ # 工具:logger, parser, reranker 等
├── milvus/ # 向量数据库
├── mineru/ # 文档解析(Docker)
└── typesense/ # 搜索引擎

系统级性能瓶颈:LLM 的困境​

随着系统跑通,一个严峻的问题浮出水面——全部的时延和精度压力都在 LLM 上。

不算 LLM 的其他地方可以做到 100 QPS+(即使有 rerank,reranker 的加速比 LLM 简单多了),但整个系统只要有 1 QPS 就是成功。

两难困境​

补全系统有两种 LLM 调用场景:

场景一:给定多篇参考文档 + 用户上下文,LLM 总结生成补全。如果用 32B 以上的模型,基本能很好地理解参考文档;但本地跑不起 32B 的批量推理,只能用 7B 小模型,性能下滑严重。

场景二:如果 reranker 能足够精确(top-k = 1 甚至 0),LLM 的任务就变成简单的句子改写,对小模型会友好得多。但问题是 reranker 只考虑相关性的话,筛选力度不够,top-k 还是得比较大。

Tokenization 的坑​

一个更深层的问题是 tokenization:

用户的上下文可能断在奇怪的地方。例如 "另一部分问题,可能是更加严","严峻" 这个词本来是一个 token,被拆开后变成了 "加严",而要从 "加严" 生成 "峻" 是一个相对困难的事情。

如果让 LLM 复读上文再输出,一是浪费 token,二是小模型会抄不准确(32B 以上基本没有这个问题,但 7B 很明显)。

量化也救不了​

尝试了 Int4 量化来跑更大的模型(如 Qwen3-30B-A3B),结果发现量化直接把模型搞得不像人类,输出变成了古神的低语。

最终的选型结论:Mistral Small 的 FP8 量化版本在 32B 以下表现最好,远强于 Qwen、GLM、Phi 等同规模模型。

Copilot 的缓存设计参考​

在性能优化过程中,深入分析了 VS Code Copilot 的 InlineEdits(Tab 补全)技术实现,发现其缓存机制非常精巧,对我们很有参考价值:

三层缓存架构​

  1. 最近显示缓存(RecentlyShownCache):< 50ms,用户快速移动光标时立即恢复之前的建议
  2. 主缓存(NextEditCache):< 300ms,直接命中或通过"重定基"技术调整旧建议
  3. 拒绝列表:避免重复提供已拒绝的建议

重定基(Rebasing)技术​

这是最核心的创新——即使用户在建议生成后继续编辑,系统也能智能地调整缓存的建议:

原始文档: "function add"
AI 建议: "function add(a, b) { return a + b; }"
用户继续输入: "function addNumbers"
重定基结果: "function addNumbers(a, b) { return a + b; }"

实现上采用了三方合并算法:将大编辑分解为原子操作,然后对 AI 编辑和用户编辑进行合并,解决位置偏移和冲突。

赛马机制​

同时向 LLM 提供者和诊断提供者发起请求,选择最佳结果:

  • 诊断建议优先(基于具体代码问题,准确率高)
  • LLM 建议作为后备
  • 如果 LLM 快速返回空结果,额外等待诊断提供者 1 秒

对我们的启示​

这套缓存设计对我们有很强的借鉴意义。尤其是在 RAG 场景下,如果事先把 chunk 都过一遍 vLLM 的 KV Cache,补全时 RAG 得到的 chunk 全部都能命中缓存,这些 chunk 的 KV 计算几乎可以省掉。

不过 GPU 的 KV Cache 容量有限(实测 L40 约 45 万 tokens),全量缓存不太现实。社区建议使用 LMCache 将 KV Cache offload 到 CPU 内存或硬盘,实现冷热分离。

前端开发经验​

VSCode Extension 的坑​

VSCode 扩展的定制能力其实很差。很多地方有安全性限制,没法自定义。例如 Copilot 的侧边栏实际上是 TreeView + Markdown string,只能嵌入预定义的东西(如图片),不支持自定义样式。

而且 VSCode 里开关 Copilot 太麻烦了,插件冲突是巨大的问题。很多逻辑必须裸写 TypeScript,没法用 React。

Office Add-in 比 WPS JS 好用​

前端同学发现 Office 的开发文档远好于 WPS JS,而且 WPS 的文档完全就是抄 Office 的(三四年没更新了)。于是决定改开发 Office 插件。

Claude 写前端​

一个共识:Claude 写传统 React 前端如入无人之境。Office 这种自带 React 框架的情况更是 AI 直接法力无边。前端核心代码其实也就六七百行(一些 AI 处理不了的逻辑),剩下的 AI 都能搞定。

测试评估框架​

核心问题:如何评估补全系统?​

开发补全应用时,一个必须面对的问题是:如何评估整个系统的成效?当然可以让 LLM 评估,但耗费大量 token 不说,整体迭代速度也会慢下来,还有组件太多调参困难的问题。

测试集生成策略​

作为传统手艺人,测试集必然是利用现有数据而不是 LLM 生成的。

策略如下:

  1. 选择一篇尚未入库的文档
  2. 在随机位置截断
  3. 将前端的动态选取上下文逻辑迁移到后端
  4. 从截断位置生成上文(往前找直到第一个标点符号)和下文
  5. 得到测试集 (prefix, expect)

组件拆分优化​

注意到依赖搜索引擎的前缀补全是快速且模型无关的,所以先对这个进行独立调优。

核心在于:

  1. 搜索引擎超参数:容忍的拼写错误数量、top-k 大小等
  2. 补全选择策略:给定上文 p 和搜索引擎搜到的文档集合 D = {d1, d2, ... dk},如何选取最优补全?

把这个函数 f1 = (p, D) -> completion 作为优化变量,就实现了单独模块的优化迭代机制——你甚至可以用强化学习来优化。

前缀补全的实现​

前缀补全不能做成简单的前缀搜索。主要问题在于:

  1. 用户不会知道文档中某个段落的前缀是什么——你会更想搜 "kubernetes" 而不是 "这个文档提到了 kubernetes"
  2. 文档解析会带来误差(多出的空格、错误的符号),没法直接前缀匹配

所以我们的前缀补全是:正常搜索引擎搜索,搜到了再找前缀。

核心算法是一道有趣的题目:

给定两个字符串 s1, s2,求最长公共子串 "是 s1 的结尾且在 s2 中出现",返回子串和 s2 中的结束位置。

async def prefix_completion_strategy(
data: AskCompletionRequest, user_id: str
) -> Optional[AskCompletionResponse]:
"""基于前缀匹配的补全策略"""
typesense_service = SearchEngineService()
typesense_results = await typesense_service.search(
query=data.content.context.current_line, user_id=user_id, filters=data.filters
)
score = 0
for result in typesense_results:
if result.found > 0:
max_prefix_length = 0
longest_completion_string = ""
for hit in result.hits:
if not hit.text_match > score:
continue
document = hit.document
prefix, completion_start_idx = (
longest_common_substring_ending_s1_with_s2_pos(
data.content.context.current_line, document.text
)
)
if prefix and len(prefix) > max_prefix_length:
max_prefix_length = len(prefix)
longest_completion_string = truncate_to_first_punctuation(
document.text[completion_start_idx:]
)
if longest_completion_string:
response = AskCompletionResponse(
response=longest_completion_string,
references=[document],
token_cost=0,
answer_type=AnswerType.PREFIXCOMPLETION,
)
return response

性能意识:先 Benchmark 再优化​

组员看到算法后建议用二分 + KMP 优化到 O(n log n),但先跑了个 benchmark:

10000 长度的字符串,31K QPS

对于补全场景来说不可能有明显性能感知,于是放弃了优化。

做工程的和搞算法的想法就是不一样。

后续方向​

项目在暑假前完成了一个阶段性版本,后续计划包括:

  1. 性能优化:核心是缓存设计,参考 Copilot 的重定基技术
  2. Web 版前端:抛开 VSCode Extension,写一个支持富文本的 Web 版本,方便调试
  3. 部署管道:搭建 Docker Compose / K8s 一键部署
  4. 小模型选型:找到一个参数量可控且补全效果可用的 LLM

这个项目最终以半成品的形式开源在了 GitHub 上,相当于暑假结课的版本。


从一个人的原型到五个人的协作开发,ProPilot 让我深刻体会到:在 AI 应用开发中,模型只是一小部分,更大的挑战在于系统工程——搜索质量、缓存设计、前后端联动、测试评估的工程化。LLM 的吞吐瓶颈远比想象中严峻,小模型的 tokenization 问题、量化带来的质量退化,都是绕不开的现实问题。

好的 log 结构、接口抽象、组件化测试,这些传统软件工程的智慧,在 AI 时代不仅没有过时,反而因为 AI 辅助编程的加入而变得更加重要。

部分llm技术报告的阅读

· 19 min read
Tags:
ayanami

Qwen​

base model: 3 trillion tokens 三万亿

数据处理

预训练:公共文档,书籍,代码

HTML中提取文本,语言识别工具确定语言

增加多样性: MinHash/LSH 模糊去重

过滤低质量数据:rule-base/ML方法(语言模型,文本质量评分模型,内容审查模型)

进一步提高性能:高质量instruction数据集

tokenization: BPE byte pair encoding

cl100k base作为起点

最终152k词汇量

  • embedding: 解绑定的embedding方法,而不是绑定embedding和输出projection的权重 -> 内存换性能(why)
  • position embedding: RoPE fp32精度
  • Bias: 只有attention的QKV有
  • PreNorm & RMSNorm 提高训练稳定性,替代传统layer norm, prenorm > post-norm
  • activation function: SwiGLU

训练:上下文2048, flash attn, AdamW, 余弦学习率,最小为10%峰值,bf16混合精度训练

上下文长度拓展:在推理时做,训练时长上下文O(N^2)开销太大,NTK-aware interpolation

另外两个注意力机制: LogN-Scaling and window attention

sft对齐: ChatML-style format

该模型的训练过程采用AdamW优化器,具有以下超参数:β1设置为0.9,β2设置为0.95,(ϵ\epsilon)设置为(10−810^{-8}). 序列长度限制为2048,batch size为128. 该模型总共经过4000步,学习率在前1430步逐渐增加,达到峰值(2×10⁻⁶)(2 \times 10^{-6}). 为了防止过拟合,应用权重衰减,值为0.1,dropout设置为0.1,梯度裁剪强制限制为1.0.

sft泛化和创造性的限制,容易过拟合 -> RLHF

PPO

tool-use造数据:左脚踩右脚,让Qwen生成更多示例相关的查询、特定格式的输出,应用规则+人工过滤产生训练样本,之后SFT

代码模型:继续预训练,900亿tokens + 8192长上下文

数学模型:1024上下文,数学问题较短加快训练速度

Qwen2.5​

下载

预训练 18万亿tokens

大于100w样本的sft,多阶段强化学习

有效KVcache利用:GQA Group Query Attention

MoE架构:将标准FFN层替换为专门MoE层,每一层包括多个FFN专家和一个路由,路由将tokens分派给topk专家

tokenization从BPE升级到BBPE, 控制token增加

做数据:

  1. 更好的数据过滤

  2. 更好的数学和代码数据,在预训练就加

  3. 更好的合成数据,数学/代码/知识模型生成 + 奖励模型过滤

  4. 平衡样本分布

电子商务、社交媒体和娱乐等领域在网络规模数据中明显过度表示,通常包含重复的、基于模板的或机器生成的内容。 相反,技术、科学和学术研究等领域虽然包含更高质量的信息,但传统上代表性不足。 通过对过度表示的领域进行战略性降采样,以及对高价值领域进行升采样

长上下文拓展:

最终预训练 4k -> 32k, RoPE 10k->1000k

渐进式拓展

32k->64k->128k->256k

每一个截断包含40%的长序列和60%的短序列,避免遗忘

YARN + Dual Chunk Attention 降低困惑度来改善长序列推理性能

两阶段RL:

• Offline RL:此阶段侧重于开发奖励模型难以评估的能力,例如推理、事实性和 instruction-following。 通过对训练数据进行细致的构建和验证,我们确保 Offline RL 信号既可学习又可靠 (Xiang et al., 2024),使模型能够有效地获得这些复杂技能。

• Online RL:Online RL 阶段利用奖励模型检测输出质量细微差别的能力,包括真实性、helpfulness、简洁性、相关性、harmlessness 和 debiasing。 它使模型能够生成精确、连贯且结构良好的响应,同时保持安全性和可读性。 因此,模型的输出始终符合人类的质量标准和期望。

长上下文:准备long-response dataset:从pre-training data中生成long-text数据对应的长查询,并使用Qwen2过滤低质量data

数学:CoT + 拒绝采样 + reward model/annotated answer

编码:code-related QA web 合成示例,github收集snippet, sandbox code checking, 自动单元测试保证正确性

指令准随:利用可严格验证的code来做,拒绝采样

结构化数据:table QA/fact verification/error correct... 造数据集然后训

逻辑推理:70000个新query迭代改进

回复过滤:多智能体协作评分系统

离线rl, 客观查询领域,数学/编码/逻辑推理/指令追随, 确保回复的质量,只有通过质量检查的才是正示例,其他回答全是负示例

在线rl, 真实性,帮助性,简洁性,相关性,无害性和去偏见

GRPO, 先训response分数方差较高的query

当前的reward model评估benchmark无法准确预测在其指导下训练的RL模型的性能


Qwen3 Embedding

多阶段训练流程: 大规模无监督训练, 高质量数据集有监督微调

qwen3 产生高质量、多语言、多任务的文本相关性数据集,在无监督阶段利用,筛选出部分高质量用于有监督训练

Embedding, Instruction + query,之后直接**[EOS]**, 最后的嵌入是这个EOS对应的最后一层隐藏状态

Reranking, Instruction + query + doc,之后是Assistant:

image-20250629132905912

为了嵌入的统一,instruction和query会拼接成同一个输入,{Instruction} {Query}<|endoftext|>

重排: **pointwise,二分类问题,**遵循以下模板,实际相关性分数是yes|no的logits

image-20250629133305609

image-20250629133428708

使用InfoNCE作为损失函数

image-20250629133536398

qwen3采用批内负采样

即,在实际对比学习(尤其是检索任务)中,为了训练出区分能力强的模型,负样本非常关键。但生成或采样足够丰富且高质量的负样本往往代价很高或不现实。

因此,常用的做法是:

  • 批内负采样(In-batch Negative Sampling):利用当前训练批次中其他样本的 query qjq_j、正样本 dj+d_{j+}以及负样本 dj−d_{j-}作为当前样本qiq_i的负样本补充。

因为batch是随机取的,所以为了避免批内负采样形成错误信号,需要在qj,dj{q_j,d_j}中把实际是正样本的部分筛选掉,就是下面的掩码因子

image-20250629133751623

减轻false negative的影响

认为是错负例的:

  1. dj/qj=di+d_j/q_j = d_{i+}的
  2. sim(dj/qj,qi)>sim(di+,qi)+0.1sim(d_j/q_j, q_i) > sim(d_{i+}, q_i) + 0.1的,即这个批内负样本比正样本还相似度高0.1以上,这个0.1可能是考虑到初期时数值的稳定性加的

此时掩码为0,LembeddingL_{embedding}的这一项是0,即不考虑这一项作为负样本

比起用if-else等前筛选方法,这个后筛选方法方便并行化,由于预计假负样本应该是比较少的,所以能提高效率

对于rerank, 定义SFT loss Lreranking=−logp(l∣P(q,d))L_{reranking} = -log p(l| P(q,d))

ll对正面文档是"yes", 负面是"no"

创新点:

  1. 大规模合成数据,直接使用qwen3的合成数据而不是收集qa pair
  2. 高质量合成数据在SFT中的利用
  3. 模型合并:基于球面线性插值(slerp)对微调的多个ckpt进行合并,提升不同数据分布下的鲁棒性和泛化

image-20250629140122099

数据集合成:

Qwen3-32B, 利用检索模型从角色库中,识别出(文档可能对应的)前五个角色候选

然后,将文档+候选角色作为prompt,令模型输出最适合的角色配置

再将角色配置给到模型,生成查询

  • 多样性:使用查询类型(关键词、事实、摘要、判断、...)×查询长度×查询语言×查询难度×...查询类型(关键词、事实、摘要、判断、...) \times 查询长度 \times 查询语言 \times 查询难度 \times ... 作为模型合成数据的状态空间

最后产生了1.5亿对数据

高质量对:简单的余弦相似度计算,保留相似度大于0.7的,得到1200w对

结果 SOTA

两个分析:

  1. 不做合成数据训练,明显掉点
  2. 不做模型合并,也掉点

Qwen3

GQA, SwiGLU, RoPE, RSMNorm,Pre-Norm

移除QKV的bias, 在attn中引入QK-Norm

MoE, 128专家,激活8个,去除共享专家,采用全局批次负载平衡损失

预训练:36T tokens,100+语言,代码、STEM、推理、书籍、合成数据

部分数据是Qwen-2.5-VL对大量pdf做OCR再Qwen2.5进行文本优化得到的高质量文本数据

三阶段预训练:

  1. 通用阶段,30T tokens,4k max length,获取语言能力和世界知识
  2. 推理阶段,增加STEM, 代码,推理和合成数据的比例,5T tokens,4k max length,加速学习率衰减
  3. 长上下文阶段,32K,4k-16k 25% + 16k-32k 75%,RoPE 基础频率10000->1000000, 引入YARN和双向块注意力

后训练

image-20250629142730991

  1. 思考控制
  2. 强到弱蒸馏

CoT冷启动:query response两层过滤

query过滤用2.5-72B删除不容易验证的query, 如多个子问题和通用问题,删除2.5-72B能直接正确回答不需要CoT的问题,对每个Query进行领域标注,保持数据平衡

Response过滤用QwQ-32B, 每个问题生成N个response,

  1. 无法生成正确答案->人工标注
  2. 移除最后答案不正确的,存在大量重复的,猜测而缺乏推理的,推理和总结不一致的,混用语言的,可能和验证集过于相似的

冷启动数据直接SFT,学习基础推理模式,为后续RL打基础

推理RL:GRPO, 大Batch Size, 每个Query多Rollout

仅仅用了4k个数据,满足

  1. 冷启动没用过
  2. 冷启动模型可学习(不太难)
  3. 有挑战性
  4. 广泛子领域

235B-A22B进行了170个RL训练步骤

思考模式融合(控制不思考)

SFT数据集融合思考非思考的数据,同时设计聊天模板,非思考保留空思考块

image-20250629143421275

当模型学会在非思考和思考模式之间切换,就可以**处理基于不完整的思考生成答案,就可以让模型在思考过程中根据预算来强行停止思考过程。**即 当模型的思考长度达到定义的阈值时,插入停止思考指令:“考虑到用户的时间限制,我必须根据目前的思考直接给出解决方案。 \n</think>.\n\n”。并让模型继续根据其积累的推理生成最终响应。

通用RL

增强能力和稳定性

20多任务:指令遵循,格式遵循,偏好对齐,代理能力,特定场景能力(如RAG)

三种奖励:基于规则的奖励,基于模型的奖励(带参考答案),基于模型的奖励(无参考答案)

蒸馏:离线和在线

离线,教师模型产生输出给学生模型SFT

在线,教师和学生对相同prompt在输出logits对齐(最小KL散度)

Ablation

  • Math & code 做完 reasoning RL 达到顶峰
  • Agent tool use 能力,general RL 也很关键
  • 通用语言能力,很需要 General RL

有一个有趣的是thinking其实损害了长上下文的性能

img

RULER大海捞针,non-thinking mode更高,long CoT甚至掉点


GRPO & RLHF

RLHF大致两种,on policy(ppo)和off policy(dpo)

on policy的更耗卡,更耗时,但理论上限更高

ppo的四个模型:actor, critic, reference model, reward model

on policy:top_p = 1.0, top_k=-1,加大探索

critic 得出V(s)V(s),起一个降低方差的作用

ReMax: 用r−rgreedyr-r_{greedy}作为baseline,(rgreedyr_{greedy}不是随机采样, 是状态的函数),解决critic model的开销

能够降低方差的原因是默认认为通常 SFT 模型已经经过一部分对齐,对于同一个 prompt 模型不太会输出差异性过大的答案

GRPO:直接退回PG是否有点原始

虽然Critic不仅占资源,并且在LLM这种全部回答的trajectory才重要的情况下,中间的“价值”也很难界定,但PPO还有别的先进feature可以保留,比如重要性采样和clip

img

只是将 AiA_i 的计算从criticcritic的输出换成了group内的相对值 ri−mean(rg)var(rg)\frac{r_i - mean(r_g)}{var(r_g)}

非常暴力,但非常有效

KL penalty用近似值保证KL始终是正数, ratio−1−logratioratio - 1 - log ratio

LLM中,通常将GAE的γ\gamma设置为1,因此也直接将这个得分复制到每一个token训练

尽管这种方法确实可以省掉一个 Critic,但成功需要具备 2 个关键:

  1. SFT 对给定的 prompt 不能有着太 diverse 的输出,否则方差会比较大。
  2. 对同一个 prmopt 采样的数量要可能大,这样才能降低方差

offline方法,DPO

降低不好答案被采样的概率,提升好回答的概率

DPO 有一个非常致命的问题,

由于 DPO 的训练 loss 目标是「尽可能最大化好答案和坏答案之间的采样概率差」,

一种常见的情况是:好答案 & 坏答案被采样的概率同时在变低,只不过坏答案降低的比好答案更多。

这种情况在 chosen 和 rejected 答案有大部分内容相同,仅有少部分内容不同时较为常见。

DPOP添加了一个如果choosen答案在SFT模型(ref)中采样概率大于当前policy模型的采样概率,则减去的正则项(policy还没拟合好,少更新点)

TDPO 加上了KL,但是是forward KL(KL非对称,SFT计算采样概率是forward, policy model计算是backward KL)

由于 backward KL 的目标是拟合整个分布中的「一部分」,而 forward KL 的目标是尽可能 cover 整个分布中的大部分。因此,TDPO 训练后的模型会比 PPO 训练后的模型,在输出多样性上更加自由。

token clipping 操作是导致性能下降的主要原因!尤其是像 "However"、"Recheck"、"Wait"、"Aha" 这类带有反思性质的 token 在初始模型中本就属于低概率 token,在更新过程中容易出现高奖励值继而被裁剪,从而无法继续为后续梯度更新提供贡献。

minimax提出CISPO,不丢弃token梯度,裁剪重要性采样权重

传统方法: 先计算 ratio∗Aratio * A, 再裁剪乘积

CISPO: 先裁剪 ratioratio, 再乘以 AA

效率显著提高(2x speed)

早停: 目标不是对已经生成的重复文本进行惩罚,而是在模型进入重复循环前就终止生成。由于简单的字符串匹配难以应对复杂的重复模式,我们设计了一个基于 token 概率的启发式方法。

一旦模型进入重复循环,所生成 token 的概率会大幅上升。因此我们制定了如下早停规则:

如果连续 3,000 个 token 的生成概率都大于 0.99,就立即终止生成。

ProPilot 开发手记(上):从 0 到 1 构建学术写作 Copilot

· 14 min read
ayanami

为什么要写这个东西?​

起因有三:

  1. 软件工程原理课要求蹲一个小学期项目,不如写点自己感兴趣的。一直对 Copilot 内部模型和架构很感兴趣,但相关文档难找,开源方案基本都是 prompt 工程而非专用小模型。
  2. 和某实验室交流时聊到"能不能用 AI 帮忙写本子",但直接让 AI 生成学术方案大长篇,一是隐私问题(私密文档不能上传到公网),二是效果太差(学术套话水平不如人类),前者比后者更关键。
  3. 和实验室讨论并做了些前期实践后,发现端到端的 agent 比较扯淡——指望国产模型在专业性这么高的地方不产生幻觉还是太为难了,于是决定做成 copilot 模式。

proposal copilot -> propilot,缩写天才吧。

产品设计思路​

在学术研究领域,存在大量论文文献、相关方案资料。面向项目方案编写、论文总结等场景,当前 AI 应用存在几个核心痛点:

  • 低幻觉文本归纳生成:AI 需要正确区分成果来源
  • 长文本、特定结构生成:按模板生成 20000+ 字的项目方案
  • 多任务能力:表格生成、UML 图生成等
  • 离线开源 LLM 下的效果优化

由于长篇生成难以保证语言风格和幻觉程度的可用性,产品设计为类似 Copilot 的形式,核心功能包括:

补全模式​

用户提供两类文档集合:公域学术论文集合(如子领域参考文献)和私域学术论文集合(如实验室未公开资料),离线处理入库。用户编写本子时,系统提供四种类型的补全:

  • 模板类型总结:如"近年来,人工智能技术的快速发展推动了AI Agent" → 补全为"相关技术的兴起"
  • 本地库查找补全:根据上下文在文档集合中通过语义搜索找到相关句子
  • 更好的 Ctrl+C/V:通过预构建索引从文档集合中原样照抄相关段落
  • 指令补全:类似 Cursor 的 / 命令——/summarize、/find、/chat、/web、/arxiv、/refine 等

同时支持 @ 系列命令限制上下文范围:@{filename}、@{tag}、@{time}、@{author}、@{domain} 等。

多级补全架构​

补全采用多级流水线设计:

L0 缓存
L1 文档过滤,意图识别
L2 本地搜索引擎前缀匹配(typesense/elasticsearch),有前缀匹配就直接生成补全
L3 向量搜索得到相关参考句子
L4 基于语义连贯性和相关程度的重排序
L5 LLM 根据 top-k 个参考生成实时补全

这个设计的关键在于:如果用户文本在文档集里有的话,L2 就能停,能够做到类似 Google 搜索的实时补全,时延 < 100ms。

技术栈选型​

  • 后端:Litestar(Python)
  • 数据库:Milvus(向量)+ PostgreSQL
  • 消息队列:基于 Redis 或内存 MQ
  • 搜索引擎:Typesense
  • 前端:VSCode Extension / Office Add-in / Obsidian Extension
  • 推理加速:vLLM + text-embedding-inference + TensorRT

为什么搜索引擎才是关键?​

做了一个真实的实验,用一个学术本子的片段测试各模型的补全能力:

用户输入:"国内各知名高校均对新兴的技术有所建树,例如清华大学在2023年在国外顶级会议上发布的StarryNet网络仿真器、复旦大学基于开源离散事件模拟器ns-3"

期望补全:"二次开发的面向卫星网络的网络模拟器"

结果令人失望:

  • DeepSeek(无网络搜索):编造了完全不存在的项目名,全是事实性错误
  • DeepSeek(有网络搜索):仍然幻觉,编造了各种框架和政策数据
  • GLM4-32B(无搜索):输出太泛泛
  • QwQ-32B:一堆幻觉
  • GPT-4.1:也不对

只有 GLM4-32B(有网络搜索)给出了接近正确的结果。

实验结论:在这样真实的子领域文本上,即使有向量搜索,LLM 的补全仍然很一般。本地搜索是绝对关键的,后续的 RAG 更多只是将本地搜索的相关句子变成补全而已。

RAG 在这里解决的任务是:给定用户的当前编辑上下文,从数据库中搜索 top-k 相关句子,然后:

  1. 如果有前缀匹配的句子,直接输出补全
  2. 否则需要 reranker 进行重排序,将真正相关的句子捞上来
  3. 对于语义相近但表述不同的内容(如 docker engine 和 containerd),需要向量搜索
  4. 对于不同语言风格的表述,需要 LLM 进行改写

Reranker 微调:相关性 vs 连贯性​

问题发现​

在微调 reranker 的过程中发现,reranker 的预训练以计算句子相关性为主,但在补全任务上,上下文连贯程度同样重要。相关的句子不一定能作为好的补全。

举个例子:"hello, world" 的嵌入和 "hello, world!" 的嵌入自然是靠近的(高相关性),但 "hello, world!" 不太可能成为 "hello, world" 的下文(低连贯性)。

连贯性建模​

发现判断两个句子连贯性的任务几乎就是 BERT 的 NSP(Next Sentence Prediction)任务,于是跑了测试:

model_name = "bert-base-multilingual-cased"
tokenizer = BertTokenizer.from_pretrained(model_name)
model = BertForNextSentencePrediction.from_pretrained(model_name)

ROC 曲线显示这个方向是可行的,连贯性分数和相关性分数的结合还有很大的调优空间。

微调经验​

微调 BGE Reranker v2 M3 的过程中总结了几条经验:

  1. Hard negative 太 hard 会训崩:直接用搜索引擎的 top-n 和同文档不同位置的句子作为负例太难了
  2. 混合难度:加入和 hard example 同等数量的简单例子(中文 Wikipedia 数据),就能正常调出来
  3. 数据量:3000 个 sample 微调后涨了约 3 个百分点
  4. 句子级别上下文太短:一个句子级别的上下文判断有点太短了,动态上下文还需要进一步做

Embedder 的微调效果不明显(将下一句作为正样本,其他作为负样本),因为 embedder 本身不太适合建模"连贯性"这种需要两个句子才能计算的指标。

Qwen3 Reranker 体验​

Qwen3 发布了 0.6B 的 reranker 模型,虽然纯对话输出是一坨,但通过非对话的形式去调用,在某些任务上竟然可以胜任。

一个有趣的实验——用它做地名匹配:

Query: 光体, Best Match: 胡法光体育场, Score: 0.1722
Query: 南体, Best Match: 南区体育馆, Score: 0.2633
Query: 霍体, Best Match: 霍英东体育中心, Score: 0.6565

Reranker/embedder 不属于一般的 chat 产品,它只需要做好排序,不需要输出任何有意义的话。训练时使用对比学习的手法,模型在嵌入空间上将查询和正样本拉近、查询和负样本拉远就行。

Encoder 架构的 reranker 依然坚挺——模型小、QPS 高,例如 BGE 最大的 encoder reranker 单张 H100 在 512 长度输入上能打到 250 QPS。LLM-based 很难做得非常小,而 encoder 架构甚至有 8M 的 CPU-level reranker。

日常踩坑记录​

Python 版本地狱​

3.13 的支持太臭了,几个核心 feature 都没有 3.13 适配,果断退回 3.12。Conda 和 uv 兼容性也很恶心。

Litestar 的依赖注入陷阱​

# 看起来依赖注入了,实际没有
@post("/image/search")
async def image_search(
req: Annotated[ImageSearchRequest, Body(media_type=RequestEncodingType.JSON)],
) -> ImageSearchResponse:

Litestar 的 body 参数注入只认 data 参数名:

# 改成这样就能跑了
@post("/image/search")
async def image_search(
data: Annotated[ImageSearchRequest, Body(media_type=RequestEncodingType.JSON)],
) -> ImageSearchResponse:

subprocess_tee 的 asyncio 坑​

subprocess_tee 库直接在代码里用了 asyncio.run(),导致不能 asyncio 套 asyncio,一直炸出 RuntimeWarning: coroutine was never awaited。

配环境占一半时间​

AI 项目开发的真理:不涉及 CUDA 还好,和模型相关的真配到头秃。xformers 不兼容,降版本编译一次就半天。unsloth 库的上游依赖各更新各的,直接无语。

软件工程实践​

接口抽象的力量​

以 reranker 为例,不同模型的调用方式千差万别,但都可以归纳为一个接口:

class Reranker:
"""Reranker接口,所有reranker实现都应该继承这个类"""
def __init__(self, name: str):
self.name = name

def compute_score(
self, sentence_pairs: List[List[str]], normalize: bool = True
) -> List[float]:
raise NotImplementedError("每个Reranker子类必须实现compute_score方法")

有了这个接口,评估代码就变得非常简洁:

rerankers = [
RerankerWrapper("BGE-Reranker-Original",
FlagReranker("BAAI/bge-reranker-v2-m3", use_fp16=True)),
RerankerWrapper("BGE-Reranker-Finetuned",
FlagReranker("./finetune/.../checkpoint-1143", use_fp16=True)),
RerankerWrapper("Qwen3-Reranker",
Qwen3Reranker(model_name="Qwen/Qwen3-Reranker-0.6B", instruction="...")),
]
results = evaluator.evaluate(rerankers=rerankers, domain_samples=1000, open_samples=1000)

大项目如何不写成屎山?​

三点建议:

一、微服务化:将相对独立的功能解耦出去(文档解析、模型微调、模型评估等),最简单的形式就是用 Docker image 而不是污染环境。

二、抽象接口意识:多用"抽象接口"。AI 相关代码常常只有一个 demo,封装本身就是一种抽象艺术。看看好的传统软件工程代码和设计模式,了解一下高阶函数的思想。

三、写简洁的代码:用现代特性减少工作量——Python 的 @dataclass、@cache、Enum、@override、Pydantic 等。一个简单的限流器用装饰器就能优雅实现:

def rate_limit(rate_limit: int) -> callable:
"""Decorator: 限制每分钟最大调用次数"""
last_called = [0]
def decorator(func):
@wraps(func)
def wrapper(*args, **kwargs):
current_time = time()
elapsed = current_time - last_called[0]
if elapsed < 60 / rate_limit:
sleep(60 / rate_limit - elapsed)
last_called[0] = time()
return func(*args, **kwargs)
return wrapper
return decorator

关键判断标准:手拼 SQL 是丑的(引入 ORM),字符串传参是丑的(用自定义类型),重复代码是丑的(写 wrapper 或注解),不可复用是丑的(统一接口),深度耦合是丑的(引入消息队列解耦)。

面向 AI 编程​

一个格式良好的 log 不仅适合人来 debug,更重要的是适合 AI 快速理解。

项目中的 benchmark 用 pytest 的 fixture 和参数化测试快速进行多组实验,保存所有原始文件和 prompt,便于版本控制和追溯。然后只写了几行描述文件架构的注释代码,让 Claude 续写,它一次就写出了 500 行可用的 Streamlit 前端。

你只需要:1. 知道 Claude 写前端很厉害;2. 知道 Streamlit 是很好的低代码前端;3. 注意维护 log 的结构性。一切就自然而然地发生了——这才是面向 AI 编程。

Git 多租户方案​

由于共用服务器账号,做了一个 .git-author 文件配合 git hook 的强行多租户方案:

# .git-authors
name1:test1@example.com
name2:test2@example.com

# .git/hooks/prepare-commit-msg
AUTHORS_FILE=".git-authors"
author=$(cat $AUTHORS_FILE | gum choose)
author_name=$(echo $author | cut -d: -f1)
author_email=$(echo $author | cut -d: -f2)
export GIT_AUTHOR_NAME="$author_name"
export GIT_AUTHOR_EMAIL="$author_email"

用 gum 实现选择界面,每次 commit 自动设置临时的 git user 环境变量。


这是 ProPilot 开发手记的上篇,聚焦于项目的架构设计、RAG 补全流水线的思路、Reranker 微调实验和软件工程实践。下篇将讲述团队开发阶段遇到的 LLM 吞吐瓶颈、系统性能优化和测试评估框架的构建。

Paper reading-Ask in Any Modality A Comprehensive Survey on Multimodal Retrieval-Augmented Generation

· 16 min read
ayanami

RAG 抽象来说就是,embed - opitional[rerank] - generate管道

有许多的增强方案,例如 Plan X RAG(将问题分解为子问题的DAG,然后设计一些critic LLM判断流的状态正常与否,一个执行LLM按照拓扑序执行DAG),Agentic RAG, feedback-driven iterative refinement

局限是:传统RAG主要针对文本,多模态集成还是挑战

流程概述如下图


Refer to caption


Multimodel RAG

LLM拓展为MLLM带来了多模态RAG的挑战

  • 检索哪些模态
  • 数据类型的有效融合
  • 跨模态相关性

特定模态的编码器将不同的模态映射到共享语义空间,实现跨模态对齐


现有数据集和基准

数据集​

  • 图文任务(字幕、检索):MS-COCO, Flickr30K, LAION-400M

  • 利用外部知识的视觉问答: OK-VQA

  • 多模态推理:MultimodalQA

  • 视频文本任务:ActivityNet,YouCook2

  • 医学:MIMIC-CXR

许多数据集都是单模态的,随后与其他模态的互补数据集集成。


Benchmark​

M2⁢R⁢A⁢GM^2⁢R⁢A⁢G: 我们执行以下步骤来处理图像,以确保它们具有高质量并且与用户查询相关: (1)缓存和转换:使用 URL 下载所有图像,并将其转换为广泛接受的格式,例如 JPG、PNG、GIF 或 WEBP。无法成功下载或转换的图像将被丢弃; (2)过滤:小于某个阈值或与查询文本的基于 CLIP 相似度得分较低的图像将被删除。此类图像通常包含非代表性的视觉内容,例如图标、横幅等。 (3)重复数据删除:使用 PHash Zauner 算法删除重复或高度相似的图像。

指标设计:主要靠prompt gpt-4o做评估

  • 文本模态指标:流畅性,相关性,忠实度,上下文准确率
  • 多模态指标:图像连贯性(图像和周围文本逻辑的连贯性,图像有用性, 图像引用(验证图像和文本引用的适当性),图像召回率(高度相关图像的召回比例)
  • 取所有指标的平均值用于计算总分

两种联合建模策略

  • single-stage:直接生成多模态输出
  • multi-stage: 文本生成 - 图像插入 - 文本重润色 三个阶段


Refer to caption


视觉为中心的评估

MRAG-Bench, VQAv2, VisDoMBench, Dyn-VQA, ScienceQA

img


知识密集型评估

TriviaQA, RAG Check, Natural Questions


image-20250528162131659


image-20250528162212109


创新和方法​

检索策略​

高效和精度​

现代MRAG将不同输入模态编码到统一的embedding空间实现直接跨模态检索

方法上,主要为Maximum inner product search (MIPS) 变体:近似MIPS,分布式MIPS,KNN变体,近似KNN,ScaNN


创新主要在效率提升和精度降低:

  • 混合搜索
  • 自适应量化
  • learned index: 神经网络驱动的索引建立,主要是数据库那边的工作

以模态为中心的检索​

文本中心

  • BM25
  • bge-m3
  • ColBERT
  • RAFT(混合干扰和ground truth文档微调模型增强抗干扰能力)
  • ...

视觉中心

  • 直接用图像表示进行知识提取
  • 基于参考图像的检索,如EchoSight和ImgRet
    • EchoSight 引入了多模态重排
    • Teaser

具体来说,对于一个图文问题query, 先用image视觉相似度找到对应的wiki条目,再将wiki的section与图+文的完整query(经过Q-Former之后)进行文本rerank,最后综合视觉分数和文本rerank分数,选取topk后输入LLM。专注于问题和知识库都是图+文的情况,也只是finding, 感觉确实创新度不够 Overall Structure h:500


  • 组合多张图像特征形成综合查询表示
  • 图文映射:Pic2word 如下图,将视觉映射到文本描述

img


视频中心

  • iRAG,增量检索
  • MV-Adapter
  • Video RAG
  • RTime: 时间因果关系
  • OmAgent:分治处理复杂视频理解
  • DRVideo:基于文档检索处理长视频理解
  • ...

文档检索和布局理解​

ColPali, ColQwen2: 端到端文档图像检索,动态分辨率处理,整体多页推理,绕过OCR技术,1.9k star

它的想法是这样的

  • OCR的多个组件和分块带来误差传播,且预处理流程耗时也长,能不能直接端到端一次使用文档截图解决
  • 但是如果将整页的文档编码成一个向量,肯定精度不够
  • 多向量方案最经典的ColBERT, 并且在这样一个视觉的情况下,视觉patch做多向量比文本token还合理

  • 贡献
    • benchmark ViDoRe
    • 将ColBERT和视觉语言模型结合,利用多向量不仅启发了文搜文,文搜图,还启发了“给一个文档,查找相似的文档”这样的任务
    • 提供了一个良好的视觉文本融合的范式(例如,解决了CLIP这样的模型缺乏文本细粒度的问题),允许最先进的VLM如Qwen-VL-2B,以相同的训练策略微调后作为嵌入器,+5.3 nDCG@5

Refer to caption


可不可以将这个范式沿用到引用溯源?

已经有一些了,ColPali自己就做了每个词条最显著的图像块

Refer to caption h:500

一些布局理解的新框架:ViTLP, DocLLM, CREAM, mPLUG-DocOwl


To our knowledge, no benchmark evaluates document retrieval systems in practical settings; in an end-to-end manner, across several document types and topics, and by evaluating the use of both textual and visual document features.

https://huggingface.co/blog/fsommers/document-similarity-colpali 基于 OCR 的文本提取,以及随后的布局和边界框分析,仍然是重要文档 AI 模型(例如 LayoutLM)的核心。例如, LayoutLMv3 对文档文本进行编码,包括文本标记序列的顺序、标记或线段的 OCR 边界框坐标以及文档本身。这在关键的文档 AI 任务中取得了最佳成果,但前提是第一步——OCR 文本提取——能够顺利完成。

但通常情况并非如此。

根据我最近的经验,OCR 瓶颈导致现实世界生产文档档案中的命名实体识别 (NER) 任务的性能下降近 50%。


Architecture h:600


为下游任务提供了一系列微调版本

  • Image Caption 加字幕
  • VQA
  • Detection (Detect [entity])
  • 图像实体分割
  • 文档理解

重排序和选择​

多用多步骤检索,整合监督和非监督策略

  • probabilistic control keywords to improve credibility
    • 对示例的关键信息进行关键词提取,为关键词赋予概率权重,使用概率进行控制信号,让模型倾向于选择高概率关键词的示例
  • RULE 利用统计方法(Bonferroni校正)校准相关上下文
    • 利用统计方法,将“5%概率存在错误上下文”这样的朴素要求通过统计运算转换成单个上下文相关度的硬阈值
  • 视频检索中基于聚类的关键帧选择来提高多样性

相关性评估​

  • SSIM (Structural Similarity Index Measure) 最早用于图像领域,衡量两幅图像间的结构、亮度、对比度相似度。现在常用于多模态信息检索,例如图片和文本联合时的相似性计算。
    • 比起传统的均方差等简单像素差,更符合人类对视觉感知的一致性判断,综合考虑亮度对比度等
  • NCC (Normalized Cross-Correlation) 标准化互相关,常见于信号处理,也可以衡量不同模态数据间的相关强度。
    • 衡量两个向量或数组的线性相关性
  • BERTScore 利用BERT这样的深度语义模型计算文本间的语义相似度,比传统关键词对齐更关注上下文语义一致性
  • 分层后处理:重排、相似度筛选、上下文窗口、合并、...

  • LDRE

    结合多种特征(如caption描述、上下文语义、实体识别等),通过权重自适应集成,提高不同表示方式下的检索相关性适应能力

  • BM25等传统排名的集成


过滤机制​

  • 硬负样本挖掘:比起文本的硬负样本挖掘需要多处理跨模态的问题,如不同模态的bias等

    • GME
    • MM Embed
  • 共识过滤、多向量过滤

    • MuRAR
    • ColPali
  • 动态模态过滤

    • 训练retriever判断哪部分是噪声
    • RAFT, Img2Loc, MAIN-RAG

融合机制​

分数融合和对齐

  • 训练交叉编码器将多模态转换为文本格式

  • 引入交错文本对,合并垂直多张few shot images(?)

  • CLIP分数融合,BLIP特征融合,嵌入到相同的空间

  • VISA 使用文档截图嵌入(DSE)模型,对齐文本查询和视觉文档表示

  • MA-LMM视频文本嵌入

  • LLM-RA 将文本和视觉嵌入连接成联合查询

  • ...

注意力机制:

注意力方法动态加权跨模态交互,支持特定任务推理

EMERGE, MORE, Alzheimer RAG,RAMM,RAGTrans, MV-Adapter, M2-RAAP


统一的框架和预测

M3DocRAG : 多页文档展平为单个嵌入张量

PDF-MVQA 融合了基于感兴趣区域 (RoI) 和基于块 (CLIP) 的视觉语言模型

DQU-CIR 图像转换为复杂查询的文本标题以及将文本叠加到图像上来统一原始数据,然后通过 MLP 学习的权重融合嵌入

SAM-RAG生成图像的标题来对齐图像-文本模态

UFineBench 利用共享粒度解码器进行超精细文本人物检索

Dense2Sparse 投影,将来自 BLIP/ALBEF Li 等人 ( 2022a ) 等模型的密集嵌入转换为稀疏词汇向量,使用层归一化和概率扩展控制来优化存储和可解释性


增强技术​

Context Enrichment

查询 重构为结构化检索请求, Video-RAG,EMERGE 整合实体关系和语义描述

Img2Loc 提示中包含数据库中最相似的和最不相似的点来让模型排除预测中不可信的位置

虽然说只是prompt工作,但想法似乎挺有趣,只是这样的作法能否比简单的几层MLP强呢?

Refer to caption h:400


动态检索

  • SKURG 查询复杂度决定跳数

  • MR2AG 动态评估和过滤

  • OmniSearch 分解问题


生成技术​

  • In context learning

    • 记忆数据 RAG-Driver(可解释的自动驾驶)

      • 检索引擎 接收到当前驾驶场景(如视频帧和对应的车辆控制信号)后,先在专家示范的记忆库中检索出与当前最相似的历史驾驶样本。
      • 多模态大语言模型处理 将检索到的样本与当前场景一同输入多模态大语言模型(MLLM),利用指令微调(Instruction Tuning),实现三项任务:
        • 动作解释(Driving Action Explanation):输出当前行为的自然语言解释;
        • 行为理由(Action Justification):对决策作出合理性说明;
        • 控制信号预测(Control Signal Prediction):给出下一个动作的具体数值(如速度和转角)

MY ALT TEXT h:600


  • 融合上下文Fusion-in-Context Learning (没太看懂RAVEN这篇论文和融合上下文这一个比较早期的encoder-decoder模型的机制有什么关系)

  • Reasoning

    • CoT RAGAR RAG链和RAG树,迭代方式优化事实核查
    • VisDoM CoT和证据整理
    • SAM-RAG 推理链和多阶段验证

指令调优:如mR2AG 用 mR2AG-IT的数据调优MLLM


来源归属​

VISA 视觉来源归属

  • 看了看他的论文,VLM直接输出边界框(也就是,输入为文档图片,输出为答案 + Box)的,再LoRA微调......

image-20250528205321419 h:400


对齐​

主要是对比学习:文档/图片/字幕...

噪声管理​

RagVL 噪声注入训练,数据级别加负样本,token级别加Gauss噪声

RA-CM3 随机删除查询token做query dropout


MRAG解决的任务​

  • 图像字幕
  • QA
  • 事实验证
  • 视觉叙事连贯性
  • 图文检索
  • .....

未来方向​

泛化​

  • 领域自适应

  • 模态偏差,过度依赖文本

  • 可解释性

  • 引用来源归属,在视觉/语音等模块更严重,难以识别出对应的小区域

  • 多模态的对抗性扰动,误导性信息


推理​

多模态融入KG

如何进行实体感知检索

位置敏感性

冗余检索

具身智能

长上下文,效率,可拓展​

  • 带图像的多页文档
  • 视频这种超长上下文

Paper reading - Fit and Prune Fast and Training-free Visual Token Pruning for Multi-modal Large Language Models

· 10 min read
ayanami

任务​

当前MLLM依赖于大量的视觉token做出高精度的视觉推理,例如LLaVa使用576 image patches as visual tokens,这相较于纯文本带来了6.2倍的计算时长开销。此外,一些其他工作正在使用提高图像分辨率的方法来缓解MLLM的视觉缺陷,但进一步加剧了计算量。

作者想要得到一种方法来在MLLM的图像token输入中,进行压缩,从而进行推理时的加速,且不能太影响下游任务精度。

同时,作者认为先前的方法依赖于大量的实验来确定超参数,他提出的方法需要具有一定的泛化能力,并且超参数确认简单 can be obtained in about 5 minutes for all VL tasks


motivation​

  1. 大规模视觉token在MLLM中的存在明显的冗余,MLLMs 的多头注意力机制是单向的,而非真正“全局”的。简而言之,MLLMs 仅将信息从前一个标记传递到后一个标记,其视觉标记通常置于文本问题之前。在这种情况下,它们主要作用是为文本标记提供视觉语义,但实际上其中大部分并未被激活。

img


如图,大部分蓝色部分(不相关语义)实际上几乎不参加推理,图像到文本注意力非常集中。

image-20250527131819120


  1. 作者将确定压缩比例这一超参数的问题转换成一个统计问题。将压缩问题转换为这样的问题:给定一个采样样本集合DD, 再给定一个计算开销δ\delta ,设压缩策略为PP, 目标是找到一个压缩比够大(满足计算开销到δ\delta以下)的PP,使得在DD上整体的注意力分布变化最小

方法​

作者只对多头注意力层进行修剪

image-20250527155650905


得到修剪策略​

对于采样样本集DD, 计算每一层的视觉token自注意力和视觉-文本交叉注意力。假设视觉token数N,文本token数M,第i层的第j个视觉token的平均注意力为 as,ci,j=∑m=1NAm,jia_{s,c}^{i,j}=\sum_{m=1}^{N}A_{m,j}^{i}, s和c分别代表自注意和交叉注意,A代表是在DD上取的平均

移除策略P可以建模成[t1∗,t2∗,...tk∗][t_1^*, t_2^*,...t_k^*] (假设模型有k层)

ti∗t_i^*表示在第i层新移除的token数量,注意前面层移除的token也不会传递给后面层,也就是说移除的总数是单调增的

采用一个注意力相差阈值α\alpha和计算开销δ\delta两者一起控制裁剪,具体来说,δ\delta是提前给定的,α\alpha是二分查找计算出来的值


height:600 width:500


用通俗的话翻译就是:

  1. 将注意力分布的差别简化为平均每个token的自注意力/交叉注意力之和的差别,即是否删除某个token,注意力和的相对变化需要小于阈值α\alpha
  2. 由于只计算和,所以可以对自注意力、交叉注意力两个集合分别按照大小排序 —— 注意力分布变化最小的保证转化为,总是优先考虑删除注意力最小的token
  3. 给定一个阈值α\alpha, 对于每一层遍历,对于自注意力、交叉注意力分别不断尝试删除token,直到注意力变化达到阈值α\alpha, 而这一层最后的策略P,即token删除数量为自注意力删除集合TsT_s和交叉注意力集合TcT_c的交集的大小
  4. 现在有了一个删除策略PP, 计算它是否满足计算开销约束(文中并没有具体说是怎么计算的,应该是根据模型的删除后token和参数量估算FLOPS,或者是某种直接测量计算量的工具,用的显卡是单张A100)

  1. 如果满足,说明删除策略PP是可行的,但说不定α\alpha太大删除太多了,需要调小α\alpha;如果不满足,说明删除策略PP不可行,说明α\alpha太小了,需要调大α\alpha。因此,二分查找α\alpha直到找到一个满足计算开销约束的α\alpha,且这个α\alpha的左右区间长度小于阈值ϵ\epsilon(后文实验是0.01),则这个α\alpha对应的删除策略PP就是最终的删除策略。

  2. 最后效果是在满足计算开销约束δ\delta的情况下,尽可能保留更多的视觉token


关于这样的算法最后带来的δ−α\delta - \alpha关系,作者附了这么一个曲线

image-20250527162141135


根据策略在推理时修剪​

在实际推理时,作者将得到的删除策略PP应用到模型中。具体来说,对于每一层的视觉token,按照PP中给定的删除数量进行修剪。

具体删除哪些token呢?作者的方法是,

对于第i层

计算第i层剩余视觉token j的自注意力和asi,ja_s^{i,j}和交叉注意力和aci,ja_c^{i,j},然后将这两个和的乘积作为用于排序的参考,排序之后去除最小的kk个token(kk是删除数量)


实验结果​

作者使用 LLaVA-655k 数据集(Liu et al. 2023b)中的 655 个样本(0.1%)来生成剪枝策略

在LLaVA, LLaVA-HR,LLaVA-NEXT三个具有不同大小的视觉token(7B模型,576,1024,2880 tokens)的模型上进行测试,十余个下游任务数据集上进行测试


image-20250527160437182


可以看到,剪枝之后,在保持准确率几乎不下降的情况下, 能够带来计算量的大幅下降

作者还做了其他几组实验

  1. 视觉冗余在不同层级的变化

    采用在不同层级上,随机删除裁剪视觉Token的方法。作者发现,深层次token的冗余度更高,裁剪深层次token几乎不影响准确度,可视化图也表明深层次的注意力几乎集中在最关键的元素中。但具体到每一层的最佳剪枝比例,层间也有比较大的不同


image-20250527161223832


image-20250527161358014


  1. 与baseline的对比

    对比了FastV和ToMe两种裁剪方法,表明了自身的SOTA性质。同时指出,在裁剪程度低的时候大家都差不多,裁剪程度高的时候才显露方法的性能差距

    image-20250527161538762


  1. 样本数量的消融实验

    作者将"LLaVA-655k 数据集(Liu et al. 2023b)中的 655 个样本(0.1%)来生成剪枝策略" 换成1%的数据,发现性能相当。作者进一步推测MLLM层间信息交换的模式可能更多地依赖于模型本身的特性,而在不同的输入样本上有较高的泛化性,FitPrune 方法可以有效地捕捉这种模式。同时下面的表还表明,这个方法有着很强的少样本泛化性,确实是模型的特性而不是样本数据集的特性,在仅有10个样本的时候也能得到非常优秀的策略

image-20250527162201012


结论​

作者介绍了一种FitPrune的无训练方法,用于对 MLLMs 进行视觉标记剪枝。通过将标记剪枝问题表述为一个统计问题,FitPrune 旨在最小化注意力分布的偏差,从而实现冗余视觉token的高效剪枝,进而提高计算效率。FitPrune 能够基于少量数据生成最优的剪枝策略,避免了昂贵的手动试验。

Paper reading-Eagle Exploring The Design Space for Multi- modal LLMs with Mixture of Encoders

· 8 min read
ayanami

nvidia的论文, 主要还是实践训练MLLM上的一堆经验


任务

探究通过使用不同的视觉编码器和分辨率来提高MLLM系统性能的不同设计带来的效果


motivation

  1. 解读高分辨率的精细视觉信息是MLLM重要的课题,常用的CLIP-ViT 预训练时候的分辨率只有如224*224或者336*336,对OCR等细粒度信息不够好
  2. 近期研究发现enhanced visual perception显著减少幻觉和提高性能,许多近期MLLM用了混合视觉编码器
    • 有扩大视觉编码器的预训练量和参数的
    • 有将高分辨率编码器和CLIP融合的
    • 也有更复杂的融合和路由,根据任务选用不同编码器,"视觉MoE"的
  3. 但缺乏对此类方法设计的通用考量, 以及综合性的大benchmark

方法

  1. 对不同的视觉编码器进行基准测试,寻找更高分辨率自适应的方案
  2. 对不同的视觉编码器混合策略做同类比较(论文将近期的混合策略归为了CC,SA,LH等几类)
  3. 寻找多个视觉编码器的最优组合
  4. 改进pre-alignment和数据混合

增加输入分辨率的做法​

  • Tiling 将输入分割为子图,CLIP-ViT单独编码
  • 直接放大输入分辨率,并对位置编码进行进行插值

Eagle做的实验:​

预训练,LLaVA-1.5 + CLIP 基础模型,和LLaVA相同的 595k 图文对,冻结整个模型,只训练projection layer

SFT: 1809k 多模态对话数据

评估:11个任务,包含VQA任务, OCR/文档/图表理解,视觉中心任务,基于知识的任务


结果 - Strong CLIP​

  1. 如果插值,需要unfrozen视觉编码器,否则损害性能。这个结论和以前实验不同。

  2. 输入分辨率和预训练分辨率差越大,插值越掉点

  3. 672分辨率下,插值和子图方法性能差不多,但是考虑效率的话还是插值更好

  4. 进行分辨率adaption,300M的CLIP-ViT性能接近6B的InternVL

按照下表,nvidia着重提了448*448+解锁视觉编码器的方案,300M就达到非常接近SOTA的性能了。


image-20250601233933871


Vision Encoder

选取了以下的encoder

  • 视觉语言对比学习的视觉Encoder,比如CLIP的ViT和OpenCLIP的ConxNeXt;

  • 以目标检测为中心的任务预训练的视觉Encoder,EVA-02

  • OCR上训练的Pix2Struct

  • 分割上预训练的SAM

  • 自监督训练的DINO-V2

对不同预训练的视觉encoder输出的特征图进行resize和插值,使得视觉token数量相同.


结果:​

image-20250601234936395


分析:​

  • 在freeze的情况下他们通常能在和自己预训练任务相近的MLLM benchmark上实现最佳性能。例如来自CLIP的ConvNeXt进行了图文对齐,因此在TextVQA、SQA任务上时所有编码器里表现的最好的。而Text Recognition任务上训练所得的Pix2Struct视觉编码器,在OCR任务上是表现的最好的。
  • 当跟随CLIP-ViT高分辨率拓展策略,unfreeze视觉编码器时,基本都能有性能提升,也有反超对应domain上训练的视觉编码器的可能性,例如CLIP-ConvNeXt微调后在OCR上性能超过了Pix2Struct。

融合策略:

Refer to caption


  • 序列维度拼接:SA sequence append
  • 通道维度拼接:CC concat channel
  • LLAVA-HR式:LH 将高分辨率特征使用adapter注入低分辨率特征中,维持序列长度、通道维度不变
  • Mini-Gemini式:MG 将高分辨率特征使用local windows cross attention注入到低分辨率的queries中。
  • Deformable Attention式:DA 将MG的local windows变成了Deformable Attention

结果:​

image-20250601235208565

  • 融合策略越复杂,性能的提升似乎越差,简单的SA/CC稳定涨点

  • 由于SA需要处理边长的序列长度,所以后面用CC


Pre-Alignment

Refer to caption

考虑对其他的视觉专家进行预先的文本模态对齐,再学会去融合不同视觉专家的特征。因此在目前的两阶段MLLM训练框架之前,添加了一个vision-language pre-alignment training阶段,首先使用next-token prediction监督每个视觉专家的特征+各自单独的projector(与LLaVA原始预训练策略不同)训练,让其与一个冻结的较小语言模型对齐。


  • 进行一个额外的预先对齐,可以比较好提升MLLM性能。
  • 预对齐后,再合并所有的视觉专家,训练projector和encoder
  • 虽然在 SFT 期间解冻视觉专家有助于通过更新视觉专家以适应语言模型来提高性能,但预对齐策略更有效地减轻了每位视觉专家的固有偏差,并稳定了训练过程,从而提高了整体性能 (unfreeze + pre-align效果加性)

Fusion choice

w h:600


采用上述的3阶段训练和最好最简单的Channel concat策略,就可以进一步研究哪种视觉编码器组合最好。组合的策略是依次增加模型视觉编码器的数量,每次的选择基于上一个数量下最好的组合进行进一步添加。四到五个编码器(X4, X5)目前看来就已经比较合适了。

最佳组合是 CLIP 、 ConvNeXt 、 SAM 、 Pix2Struct 和 EVA-02


最终和benchmark的比较

Refer to caption


高分辨率的文档任务的展示: 红色baseline失败,蓝色eagle成功

h:600


结论

  1. MLLM训练期间解锁视觉编码器matters
  2. 设计先进的融合策略并不能较简单的通道级联显露优势
  3. 更多的视觉专家MoE能带来持续增益,是增强MLLM能力的有效途径
  4. 视觉专家如果开始时候设计的任务和文本无关(没有对齐),用冻结的LLM进行预对齐(+解锁)后再整体训练能显著提升性能

RAG的一些思考与细节

· 13 min read
Tags:
ayanami

Langchain needle in haystack 实验​

长上下文之后,越后面的部分的事实性细节越容易找,尤其是多事实的情况下

引发的一个思考是 rerank 时是否需要将最关注的块放在 prompt 的最后面,也就是倒序?

  • 后补: 但其实又有attention sink相关的研究,可能还是需要具体任务具体测试分析

image-20250417222048515

Maybe recency bias in LLMs:只记得最近的了

No retrieval guarantees

image-20250417222613216

query analysis:将 question 联系到正确的文档​

routing (to right DB)

full doc -> summary -> embedding: doc 中噪声非常大, summary 是必要的,语义层次的保留 level 通过 prompt 保证

self-reflection 听起来很美好,但实际常常用不到,太慢了,并且搜不出来更多是前期处理没做好,再换着花样也很难搜出来

HyDE 对于高度 Domain Knowledge 和抽象性理解的任务基本没用:

一些自己的解释

  1. 能否生成正确的假设文档, 难
  2. 即使通过先行的小批量搜索教导 LLM 根据这些 example 生成假设文档,也很难让 LLM 从这些文档中抽取某个泛化的问题,经常会 过度 specific 而导致后续漏掉文档
  3. 目前实验下来垂域脏文档类型最好的解决方案还是 reranker,embedder 如果不微调分布太接近了,例如全部的 chunk 都在 0.5~0.6 之间,意义寥寥

和数据分析的结合:

分析波动->(数据分析)找出波动的阶段-> 对每个波动的阶段做查询

GraphRag 这种 KG-based 的方法经常强调“对整个数据集信息的整合”

但这个要分领域,例如,个人知识库之中,这是好的

但垂域的知识文档常常是相似的格式,固定的路由,同时信息的整合关键不在“多实体”的关系上,而是在于“单个实体随时间的变化”上。

又或者说实体关系 R(e1,e2)R(e_1, e_2) 本身应该建模成一个包含时间的 R(e1,e2,t)R(e_1, e_2, t)

如果仅仅是靠新加入的文档来动态更新 KG 的话,滞后性会很强

在这种半结构化的模板式文档中,LLM 实际上在干一个 Fuzzy DB manager, 提取信息,充当一个搜索引擎

利用 KG 进行某种意义上的多跳推理本质上也只是对文档的多次检索,推理跳数越多,关系越复杂,离线生成 KG 就越难,不是所有领域都像是法律一样有一个明确的 A 判例引用 BCD 法条的连接关系的,这样复杂的 KG 在要想随时间变化也更不可能

从某种意义上来说,KG 是在横向生成,而类似金融这种领域的 RAG 做的是纵向的 Timeline, 这部分对于关键实体是有数据的,并且可能数据都不需要自己做(例如各种行情的图),而离线准备好这些 timeline 之后,如何在 timeline 上进行一个跳跃和查询分析才是关键的。

如果从 DB 的角度上分析的话,金融领域这种关注点快速变化的 RAG 系统(with cache)也就相当于 lazy generated timeseries DB 了,例如问了一个 A 的价格变化,就像是生成了一个 time, delta_price, event(detail) 的 timeseries DB 表,把生成 reason 这样的 LLM 工作 lazy 化了而已

chunk 的前总结和后总结(离线在线)​

离线总结最大的问题在于总结哪些方面,实际上是文档预处理的一个部分

最简单的方法就是整个提示模板每个 chunk 问一次 LLM,有 langchain 的 map reduce 等稍微 high level 一点的工具可以支持这个事情

对长文档总结更有效一些的做法是利用好 embedding,先对 chunk embedding 做聚类,再每个聚类里面抽几个 chunk, 从而保证多样性和 chunk 数量的平衡

后总结,或者说 query-based 总结大体上是用 LLM 做比较多,但对于时延和开销的增加太高了,一个比较新的方法是 paragraph sentence-level mask bert(自己造的词),在段落中根据 q, d 的交叉编码得到句子级别的二进制掩码,从而删除无关部分。有一篇 ICLR2025 基于 bge 训了个,https://huggingface.co/blog/nadiinchi/provence

provence效果非常好,又快又几乎对齐例如GPT4.1这种顶级模型的效果

另一个思路就是绕过这个问题,切小块,依赖 rerank 和重新合并乃至知识图谱检索之类的策略保证相关性,也就是在查询完之后是合并还是切分的思路差距

半结构化数据​

https://docs.superlinked.com/getting-started/installation 聚焦半结构化的异构数据,例如朴素 embedding 方案对数字的理解不足,无法建模 1-99 的相似度分数与 higher/lower 这种文本的关系

https://github.com/microsoft/multifield-adaptive-retrieval 做多字段的权重学习(自适应选择查询应该着重的权重)

embedding 相关的调优​

colbert架构是一个better embedding的方向,其核心在于将文档的token level embedding保存下来,对于每一个query token,计算maxsim算子得到单token的score,再求和

img

对比朴素embedding方案,它在token level进行计算可以很好的带来类似关键词匹配的效果,有效避免长文档下,embedding过于平均化余弦相似太不敏感的问题

对比rerank方案,它的优点又在嵌入矩阵可以离线计算,不需要完全在线的交叉编码器

引入方案: https://python.langchain.com/docs/integrations/providers/ragatouille/

Prompt​

基本没有什么特别通用的工作,但值得一提的是将prompt作为一个优化变量,使用LLM在Trajatory上进行采样和跑各种论文的“prompt优化算法”的解耦框架dsPy https://dspy.ai/ 用户以类似类型/对象系统的简短注释提供给dspy作为“初始意图”,而后续复杂的提示由dspy生成,核心思想是让用户专注于编程

class CheckCitationFaithfulness(dspy.Signature):
"""Verify that the text is based on the provided context."""

context: str = dspy.InputField(desc="facts here are assumed to be true")
text: str = dspy.InputField()
faithfulness: bool = dspy.OutputField()
evidence: dict[str, list[str]] = dspy.OutputField(desc="Supporting evidence for claims")

context = "The 21-year-old made seven appearances for the Hammers and netted his only goal for them in a Europa League qualification round match against Andorran side FC Lustrains last season. Lee had two loan spells in League One last term, with Blackpool and then Colchester United. He scored twice for the U's but was unable to save them from relegation. The length of Lee's contract with the promoted Tykes has not been revealed. Find all the latest football transfers on our dedicated page."

text = "Lee scored 3 goals for Colchester United."

faithfulness = dspy.ChainOfThought(CheckCitationFaithfulness)
faithfulness(context=context, text=text)

DSPy 中的不同优化器将通过为每个模块合成良好的小样本示例 (如 dspy.BootstrapRS 1 ) 来调整程序的质量;为每个提示提出并智能地探索更好的自然语言指令 (如 dspy.MIPROv2 2 ) ,以及为您的模块构建数据集并使用它们来微调系统中的 LM 权重 (如 dspy.BootstrapFinetune 3 )

LLM评估​

测试不可靠:有多少答案是被记忆出来的?

有多篇相关的paper在讨论这个问题,然后采用了一些方法来衡量这个事情,例如,在数学问题题集中,替换无关的描述、修改数字等等,看看模型性能变差多少

类似数学问题集这种在网络上数据中很难过滤干净,还需要考虑多语言影响

另一些评估指标如ARC-AGI通过抽象图像智力问题集来评估模型的推理能力,相对来说泄题风险小一些(并且有隐藏test set)

  • 丢给LLM的时候不是图像,而是矩阵,用数字表示不同颜色

image-20250505134411046

Chatbot Arena: 让全世界的人都来进行判断哪个模型好​

但还是有办法hack: 更fit人的倾向(粗体字、分点、emoji.....)

Elo Score 考虑除了人的直接倾向之外其他因素的影响,在BF模型计算时加上一项β0\beta_0, 11+exp(βi−βj+β0)=Eij\frac{1}{1 + exp(\beta_i - \beta_j + \beta_0)} = E_{ij}, EijE_{ij} 是模型i和j的胜率,βi\beta_i 是模型i的真实评分,β0\beta_0 是一个全局偏差项,表示人类评估者的偏好。通过最大化似然函数来估计参数βi\beta_i和β0\beta_0,从而得到模型的真实评分。

β0=γ1∗长度差+γ2∗emoji个数差+γ3∗...\beta_0 = \gamma_1 * 长度差 + \gamma_2 * emoji个数差 + \gamma_3 * ...

image-20250505135351256

可以看到,考不考虑这个β0\beta_0,模型的排名差别很大

Goodhart's Law​

一旦一项指标被用作目标,它就不再是一个好的指标

http://becomingahacker.org/integrating-agentic-rag-with-mcp-servers-technical-implementation-guide-1aba8fd4e442

However, traditional RAG has limitations: it usually queries a single data source and only performs one retrieval pass, so if the initial results are poor or the query is phrased oddly, the answer will suffer 但是,传统的 RAG 存在局限性:它通常查询单个数据源,并且只执行一次检索传递,因此如果初始结果不佳或查询措辞奇怪,答案将受到影响

There’s no built-in mechanism for the system to reason about how to retrieve better information or to use additional tools if needed. 系统没有内置机制来推理如何检索更好的信息或在需要时使用其他工具。

关于结构化输出的另一篇特别好的文章: https://www.boundaryml.com/blog/schema-aligned-parsing

推理加速:是对的,例如huggingface-text-embedding项目,将各种转trt/onnx 可以让吞吐提升5x

H100 bge-reranker-v2-m3 1024 * 512char sentence, 13s -> 2.3s

关键词抽取​

基于主题LDA,词典等

小模型方法:先用spaCy、hanLP等得到语法树,再从语法树中拿到名词性关键词等

无监督,经典如YAKE!综合考虑词频,词位,共现等。可以考虑https://github.com/JackHCC/Chinese-Keyphrase-Extraction

一篇非常有insight的blog:上下文相关!=上下文充足,定量充足性和它的应用​

https://research.google/blog/deeper-insights-into-retrieval-augmented-generation-the-role-of-sufficient-context/

Paper reading - Interleaved Scene Graph for Interleaved Text-and-Image Generation Assessment

· 5 min read
ayanami

开发了一个交错文本和图像生成综合评估框架ISG

使用scene graph捕获文本和图像的关系,提供四个级别的评估:整体的、结构性的、块级别和特定于图像的,并引入了一个新benchmark,ISG-BENCH

作者实验认为现有模型在端到端生成文本图像交错内容时,效果不好,于是做了一个Agent来完成这个任务


motivation​

image-20250530152606364

如图,现有MLLM不能直接生成交错文本和图像内容,需要将生成图像部分交给SD等外部模型再组合,带来了更大的开销与不一致性


为了专注这一任务,作者的Benchmark优先考虑视觉为中心的任务,例如风格迁移等图像输出的特定要求。

  • 作者的数据集和人工标注比较有较高Pearson相似度,以此说明准确性
  • 作者表示先前没什么benchmark主要以视觉为中心,以此说明新颖度
  • 但有一说一,作者的表还是有点不公平的,例如它自己的sample很少(一千多),同时评估级别是自己提出的这个四级别评估

作者的表​

image-20250530160048840


方法

image-20250530153213139 h:500

注意点: 中间看起来很复杂, 实际上是很多组prompt完成的


评估框架将query拆成scene-graph-like structure,其中图文作为节点,而它们的关系作为边

在整体,结构,块和图四级别的评估中,每个级别都会生成一些用于评估的QA对。作者的意图是,让整体和结构评估连贯性和整体质量,块和图像评估指令完成的细节


结构性:用一个LLM预估图文交替内容的结构,然后与实际生成的内容进行比较

image-20250530163448151


整体:MLLM-as-a-Judge和CoT,用1-10打分配合Yes/No判断

块: 将prompt P用LLM表示成三元组 (subj, obj, rel),再用LLM生成问题,并用VQA评估

image-20250530163519317


图像:从prompt 给的图像中用LLM抽出三元组关系和实体,判断query类别,根据类别不同使用不同的prompt产生判断的VQA,例如如果是"How to",则需要包含特定实体,如果是“Painting”,则需要图像的准确生成

image-20250530163331400 h:600


实验结果​

所有统一模型在按照说明生成交错文本和图像内容方面都存在重大缺陷。许多模型只生成 1 到 3 张图像,而有些模型根本无法生成任何图像。

整体评估结果与三个细粒度级别的评估结果之间的不一致表明,即使同时提供用户指示和正确的黄金答案,MLLM-as-a-Judge 在全面评估回答方面也存在显着局限性。具体来说,Judge MLLM 努力根据细粒度的标准评估响应,例如输出结构(包括图像数量)和提示中规定的详细文本-图像关系。此外,我们对结果的分析揭示了 MLLM-as-a-Judge 中固有的偏见,即“图像质量偏见”,即具有更高质量图像内容的回答始终获得更高的分数,尽管这些回答可能违反用户的指导要求和评判指南。这种偏见表明,即使获得了黄金答案,MLLM-as-a-Judge 仍然无法正确地对符合指定要求的交错回答进行准确评估。


image-20250530160948640


效果展示: 跑一次它这个Benchmark要60美刀

image-20250530163815015 h:600


结论

  1. MLLM-as-a-judge存在图像质量bias
  2. 现有端到端MLLM生成图文内容效果不佳, 可能需要在工程性上的agent做补救

ColBERT-后期交互方法

· 10 min read
ayanami

如果简单引入语义搜索,那么第一时间想到的肯定是向量搜索的方法

先不论小的优化,向量方法现在大体上就是两种架构,单塔和双塔,对应Cross-Encoder和普通的Encoder模型。

双塔模型如下,查询qq和文档dd分别通过两个独立的编码器,得到向量表示qvq_v和dvd_v,然后计算相似度(内积,余弦,等等)。

overview traditional text embedding models

而单塔模型则是将查询和文档拼接在一起,输入到一个交叉编码器中,这个交叉编码器很多时候就直接输出相关性得分score了,即为我们所说的reranker

单塔虽然精度远高于双塔,但有无法离线计算的缺点

而双塔的一大精度困境在于,当编码的文档变长时,文档的大部分内容可能都和查询没什么关系,这会导致查询向量和文档向量的相似度计算不准确。实际上,在楼主之前的一些实验之中,一整个很大的文档集合内,和某个查询最无关和最相关的文档的余弦相似度相差也就0.2左右,这就是长文档带来的问题。

但客观地讲,长文档是无法避免的,如果把文档切成更细粒度的句子,在上下文补齐语义,后续合并等麻烦可能更多,并且会出现"长文档实际上是在让相似度检索考虑上下文"这样的情况,一个例子是,问题是"上海交大的用户论坛中,....",而文档可能是"...水源社区是上海交大的用户论坛。水源社区....." 如果仅在句子等短文本上面匹配,那缺少了上下文的情况下,"水源社区"当然和"上海交大"没什么关系。

那么,如何保证精度的同时又能离线计算呢?

ColBERT的思路是,使用双塔模型来计算相似度,但在编码文档时,使用了一个更细粒度的向量表示。

ColBERT给每个token一个向量表示,而不是给每个文档一个向量表示。这样,查询和文档的相似度计算就可以在token级别进行。

如下图,ColBERT在拿到最后一层的输出之后(这一层有非常多的语义信息!),将每一个token对应的vector都存下来,这一部分是离线的。

而在计算相似度的时候,将query的tensor和文档的tensor进行一个MaxSimMaxSim算子

MaxSimMaxSim是一个最大池化操作,取出每个token的向量中与查询向量最相似的那个向量,然后计算相似度。

overview colbert

ColBERT的性能是逼近reranker的,这个也很好理解,毕竟交叉编码器的优势就是可以考虑q,dq,d之间的交互,而ColBERT除了保留语义嵌入之外,比起更暴力的加大embedding维度,更重要的是它保存了上下文次序的信息

而ColBERT的最后一层MaxSim,而没有采用神经网络的方案,让他带来了良好的可解释性

colbert snippet

那看了上面立刻就会想到,这每一个token保存一个768/1024/...维的向量,存储开销不会很大吗?

ColBERT也考虑到了这个问题,因此在ColBERTv2中,采用了这样质心编码的方法来降低存储开销,能降低8倍

  1. 对每个token的向量进行聚类,得到kk个质心(k是一个预定义的数字)

  2. 对每个token的向量,找到距离最近的质心,并将其索引存储下来,也就是从 (vd,)−>(1,)(v_d, ) ->(1,)

  3. 将质心向量库构建ANN索引,例如FAISS, ScaNN

  4. 在计算相似度时,查询向量也进行同样的处理,找到距离查询最近的质心索引,然后从质心向量库中取出对应的质心向量进行相似度计算

在实际使用的时候,商业rag公司甚至对大规模检索做更狠的二值化向量压缩(说实话这也能检索出来真的有点现代模型神力了),让ColBERT的开销可以和单独的embedding媲美

colbert token

二值化的说法是这样的:

压缩方法通过将正维度表示为 1、负维度表示为 0 来简化文档标记向量。这种二进制表示有效地指示了文档标记向量中重要语义特征的存在与否。 正维度有助于增加点积,表明相关的语义相似性,而负维度则被忽略。

ColBERT的使用上,很多公司都有了支持,例如vespa, jina等等,开源方案则有早期的ragatouile和后来的上下游如milvus,llamaindex的支持

但是,文档ColBERT还不是它发挥全部潜能的时候,据说SPLADE算法就比他效果好不少(这个我没有实测过),它在图像又活出了第二世,即所谓的ColPali架构

ColPali是MRAG、MLLM那边的新论文和解决方案,几个月的时间砍了1.9k star,ColPali的想法是这样的

  • OCR的多个组件和分块带来误差传播,且预处理流程耗时也长,能不能直接端到端一次使用文档截图解决
  • 但是如果将整页的文档编码成一个向量,肯定精度不够
  • 我的ViT等视觉编码器会将整页文档变成一系列的patch(可以理解为子图),进而变成一系列视觉token,那我重用ColBERT,不就又有了多向量吗?并且这个存储和交互上比每个token存一个向量更合理! 子图本身就有很多的空间位置信息

image-20250529232012895

并且,你会发现ColBERT的强可解释性在图像上有更关键的作用!模型在文本中关注了什么可能是某个词,还需要人进行一点逻辑推理来判断关系是否合理,而图像中关注了什么,直接看图就知道了!

image-20250529232211333

作为一种新的RAG范式,ColPali从源头上解决了复杂的OCR和切块的问题

虽然其在重文字领域上的泛化性还留待验证,精度的提升也依赖于未来VLM的发展,但无疑社区已经认同了这个想法的价值

基于 OCR 的文本提取,以及随后的布局和边界框分析,仍然是重要文档 AI 模型(例如 LayoutLM)的核心。例如, LayoutLMv3 对文档文本进行编码,包括文本标记序列的顺序、标记或线段的 OCR 边界框坐标以及文档本身。这在关键的文档 AI 任务中取得了最佳成果,但前提是第一步——OCR 文本提取——能够顺利完成。

但通常情况并非如此。

根据我最近的经验,OCR 瓶颈导致现实世界生产文档档案中的命名实体识别 (NER) 任务的性能下降近 50%。

目前例如ColQwen2这种ColBERT + Qwen2.5-VL-3B-Instruct的方案也很火,很多榜上都刷到了SOTA,感兴趣的同学也可以自己试试

美团技术博客阅读

· 19 min read
ayanami

美团外卖基于GPU的向量检索系统实践​

美团外卖的向量检索系统使用了GPU来加速向量检索过程。该系统主要包括以下几个方面: 美团外卖业务特点具有较强的Location Based Service(LBS)依赖,即商家的配送范围,决定了用户所能点餐的商家列表。以商品向量检索场景为例:向量检索结果集需要经过“可配送商家列表”过滤。

美团外卖向量检索基于Elasticsearch+FAISS进行搭建,实现了10亿级别+高维向量集的标量+向量混合检索的能力。为了在保证业务高召回率的同时进一步减少检索时间,我们探索基于GPU的向量检索,并实现了一套通用的检索系统。

相继使用了HNSW(Hierarchical Navigable Small World),IVF(Inverted File),IVF-PQ(Inverted File with Product Quantization)以及IVF-PQ+Refine等算法,基于CPU实现了向量检索能力

在HNSW算法中,这种导航小世界图的层次结构使得搜索过程可以从图的高层开始,快速定位到目标点的大致位置,然后逐层向下精细化搜索,最终在底层找到最近邻,在通用检索场景上有显著的优势。然而该算法在高过滤比下性能会有折损,从而导致在到家搜推这种强LBS过滤场景下会暴露其性能的劣势。业界有较多相关的benchmark可以参考,以Yahoo的向量检索系统Vespa相关博客为例

图片

索引吞吐

Observations: 观察结果:

  • Indexing throughput depends on corpus size for Annoy and HNSW, where throughput is halved when corpus size is increased by 10x. 对于 Annoy 和 HNSW,索引吞吐量取决于语料库大小,当语料库大小增加 10 倍时,吞吐量就会减半。
  • Indexing throughput for RPLSH is independent of corpus size. RPLSH 的索引吞吐量与语料库大小无关。
  • Annoy is 4.5 to 5 times faster than HNSW. Annoy 比 HNSW 快 4.5 到 5 倍 。
  • RPLSH is 23 to 24 times faster than HNSW at 1M documents. 对于 1M 文档,RPLSH 的速度比 HNSW 快 23 到 24 倍 。

img

查询吞吐

Observations: 观察结果:

  • HNSW outperforms Annoy and RPLSH. At corpus size 1M the QPS is 9 times as high as Annoy, and 16 times as high as RPLSH at comparable quality. Similar observations between hnswlib and Annoy are found in ANN Benchmarks, where the QPS of hnswlib is 5-10 times higher at the same quality on all tested datasets. HNSW 的表现优于 Annoy 和 RPLSH。在 1M 语料库规模下,其每秒查询速度 (QPS) 是 Annoy 的 9 倍 ,在同等质量下是 RPLSH 的 16 倍 。在 ANN 基准测试中也发现了 hnswlib 与 Annoy 之间的类似现象:在所有测试数据集上,相同质量下 hnswlib 的每秒查询速度 (QPS) 比 Annoy 高 5-10 倍。
  • HNSW 搜索算法很大程度上取决于节点之间的链接数量,而链接数量又取决于语料库的大小。当语料库规模增加 10 倍时,QPS 会减半。在索引过程中,我们也看到了同样的情况,因为它使用搜索算法来查找要连接的候选节点。

img

内存占用

Observations: 观察结果:

  • The Annoy index is almost 3 times larger than the HNSW index, which results in ~40% more total memory usage in the 1M SIFT dataset. Annoy 索引几乎比 HNSW 索引大 3 倍,这导致 1M SIFT 数据集的总内存使用量增加约 40%。
  • Both indexes are independent of dimension size, but max points in a leaf node (Annoy) and max links per level (HNSW) might need adjustments with higher dimensionality to get decent quality. 这两个索引都与维度大小无关,但叶节点中的最大点数(Annoy)和每级的最大链接数(HNSW)可能需要使用更高的维度进行调整才能获得不错的质量。

博客给出了一个很重要的观察是:当超过 90% 到 95% 的文档被过滤掉时,过滤后计算精确最近邻比搜索 HNSW 索引(过滤器会丢弃候选匹配项)的成本更低

2.2 IVF (Inverted File)​

IVF是一种基于倒排索引的方法,它将高维向量空间分为多个簇(Cluster),每个簇对应一个倒排列表,存储了属于该簇的向量索引。这种方法大大减少了搜索时需要比较的向量数量,从而提高了检索速度。它的缺点是需要存储原始的向量数据,同时为了保证检索性能需要将其全量加载到内存中,从而占用了大量的内存空间,容易造成内存资源瓶颈。

2.3 IVF-PQ(Inverted File with Product Quantization)​

在候选集数量巨大的场景下,比如商品向量检索场景下,IVF带来的内存空间大的问题很快就显现出来,为了解决内存空间的问题,开始尝试使用了IVF-PQ方法。该方法在IVF的基础上,使用了乘积量化(Product Quantization,PQ)的方法来压缩向量数据。PQ将高维向量分为多个子向量,然后对每个子向量进行量化,从而大大减少了对内存空间的需求。

然而,由于量化过程会引入误差,因此IVF-PQ的检索精度会低于IVF,从而导致召回率无法满足线上要求,对召回率要求相对较低的场景可以使用IVF-PQ,对召回率有一定要求的场景需要其他解决方案。

2.4 IVF-PQ+Refine​

为了提高IVF-PQ的检索精度,进一步采用了IVF-PQ+Refine的方案,在IVF-PQ的基础上,在SSD磁盘上保存了未经压缩的原始向量数据。检索时,通过IVF-PQ召回数量更大的候选向量集合,然后获取对应的原始向量数据进行精确计算,从而提高检索精度。这种方法既保留了IVF-PQ的存储优势,解决了内存资源瓶颈,又保证了召回率,因此在实际应用中得到了广泛的使用。

2.5 基于地理位置的向量检索​

通过将经纬度编码为向量,优化具体做法是将用户或商家的经纬度以加权的方式加入查询Query和候选向量中,在计算Query和候选向量的相似度时,距离因素就可以在不同程度上影响最终的检索结果,从而达到让向量索引具备LBS属性的目标。

这里没有细讲,但怎么具体怎么融入的LBS属性还是比较有意思的,最直接的方法是将经纬度信息直接拼接到现有的文本embedding向量上,也可以将经纬度用geohash,或者以用户为中心的极坐标系统表示?

我觉得最复杂的在于:

  • 如何确定经纬度特征的维度,这也算是一种权值
  • 如何让经纬度特征和其他向量特征上对齐?美团是否有一个专用的embedding模型来嵌入地理信息特征,这个模型又是根据什么进行微调的?是类似推荐系统那种基于用户反馈的,还是内部有一个地理加权的人工设计公式,这个模型提供的地理特征使得整体效果向这个公式靠齐的?

https://docs.google.com/document/d/1R5nOiwFUn9ZJtuWywmos2yfB4aCWCGy1TUN5VAnMRaY/edit?usp=sharing

考虑到美团外卖的业务场景,目标方案应该满足以下要求:

  • 支持向量+标量混合检索:在向量检索的基础上,支持复杂的标量过滤条件。
  • 高过滤比:标量作为过滤条件,有较高的过滤比(大于99%),过滤后候选集大(以外卖商品为例,符合LBS过滤的商品向量候选集仍然超过百万)。
  • 高召回率:召回率需要在95%+水平。
  • 高性能:在满足高召回率的前提下,检索耗时Tp99控制在20ms以内。
  • 数据量:需要支持上亿级别的候选集规模。

实现向量+标量混合检索,一般有两种方式:前置过滤(pre-filter)和后置过滤(post-filter)。前置过滤指先对全体数据进行标量过滤,得到候选结果集,然后在候选结果集中进行向量检索,得到TopK结果。后置过滤指先进行向量检索,得到TopK*N个检索结果,再对这些结果进行标量过滤,得到最终的TopK结果。其中N为扩召回倍数,主要是为了缓解向量检索结果被标量检索条件过滤,导致最终结果数不足K个的问题。

业界已有较多的成熟的全库检索的方案,后置过滤方案可以尽量复用现有框架,开发量小、风险低,因此我们优先考虑后置过滤方案。我们基于GPU的后置过滤方案快速实现了一版向量检索引擎,并验证其召回率与检索性能。GPU中成熟的检索算法有Flat、IVFFlat和IVFPQ等,在不做扩召回的情况下,召回率偏低,因此我们在benchmark上选择了较大的扩召回倍数以提高召回率。

图片

测试结果表明,以上三种算法均无法同时满足我们对检索性能和召回率的需求。其中IVF与IVFPQ召回率较低,Flat算法虽然召回率较高,但是与全体候选集计算向量相似度导致其性能较差。

根据用户的地理位置信息计算其GeoHash值,并扩展至附近9个或25个GeoHash块,在这些GeoHash块内采用Flat算法进行向量检索,可以有效减少计算量。这种向量子空间划分方式有效地提高了检索性能,但是存在某些距离稍远的商家无法被召回的情况,最终测得的召回率只有80%左右,无法满足要求。

综上,后置过滤方案无法同时满足检索性能和召回率的需求,而GPU版本的Faiss无法实现前置过滤功能,考虑到美团外卖的业务场景,向量+标量混合检索能力是最基本的要求,因此我们决定自研GPU向量检索引擎。

基于GPU的向量检索,要想实现前置过滤,一般有三种实现方案:

  1. 所有原始数据都保存在GPU显存中,由GPU完成前置过滤,再进行向量计算。
  2. 所有原始数据都保存在CPU内存中,在CPU内存中完成前置过滤,将过滤后的原始向量数据传给GPU进行向量计算。(能存更大的数据集)
  3. 原始向量数据保存在GPU显存中,其他标量数据保存在CPU内存中,在CPU内存完成标量过滤后,将过滤结果的下标传给GPU,GPU根据下标从显存中获取向量数据进行计算。(省显存带宽)

由于GPU与CPU结构与功能上的差异性,使用GPU完成前置过滤,显存资源占用量更大,过滤性能较差,且无法充分利用过滤比大的业务特点,因此不考虑方案1。

图片

实验结果表明,方案2在数据拷贝阶段耗时严重,时延无法达到要求。因为在美团外卖的场景下,过滤后的数据集仍然很大,这对CPU到GPU之间的数据传输带宽(A30显卡带宽数据如下 CPU-GPU:PCIe Gen4: 64GB/s;GPU-GPU:933GB/s)提出了很高的要求,因此我们最终选择了方案3。

考虑到显存的价格远高于内存,因此我们在设计方案的过程中,尽可能将数据存储在内存当中,仅将需要GPU计算的数据存储在显存当中。

内存中保存了所有的标量数据,数据按列存储,通过位置索引可以快速找到某条数据的所有字段信息,数据按列存储具备较高的灵活性和可扩展性,同时也更容易进行数据压缩和计算加速。针对需要用于过滤的标量字段,在内存中构造了倒排索引,倒排链中保存了对应的原始数据位置索引信息,内存数据结构如下图所示

图片

显存中保存了所有的向量数据,数据位置索引与内存中的数据一一对应,可以通过位置索引快速获取某条数据的向量信息,如下图所示:

图片

最后的流程图(Flat)

图片

最后的流程图(IVF),放宽召回率,提升性能

图片

图片

可见,无论是Flat还是IVF,在相同的召回率下,使用前置过滤的性能都要明显好于后置过滤。

性能优化

  • 高并发支持,通过Cuda Stream,GPU可以并行处理多个查询请求,高并发压测下,GPU利用率可以达到100%。

  • 通过GPU实现部分标量过滤功能,支持在GPU上实现部分标量过滤功能,向量计算与标量过滤同处一个Kernel,充分利用GPU并行计算能力

  • 资源管理优化,支持句柄机制,资源预先分配,重复利用。每个句柄持有一部分私有资源,包含保存向量检索中间计算结果的可读写内存、显存,以及单独的Cuda Stream执行流;共享一份全局只读公有资源。在初始化阶段,创建句柄对象池,可以通过控制句柄数量,来调整服务端并发能力,避免服务被打爆。在检索阶段,每次向量检索需从句柄对象池中申请一个空闲的句柄,然后进行后续的计算流程,并在执行完后释放响应的句柄,达到资源回收和重复利用的目的

图片

我们最终选择了单机多卡的数据分片方案,单台服务器部署多张GPU,检索时并行从本地多张GPU中检索数据,在CPU内存中进行数据合并。

为了支持更大规模的向量数据检索,我们还在GPU检索引擎上支持了半精度计算,使用FP16替换原来的FP32进行计算,可以节省一半的GPU显存占用,经验证Flat召回率由100%下降到99.4%,依然满足需求。使用半精度之后,单机可以加载近10亿数据,足够支撑较长时间的业务数据增长。

GPU 检索系统上线后实际性能数据如下(数据量1亿+):

图片


22年还有一篇早期的搜索基于elasticsearch的优化实践

https://mp.weixin.qq.com/s?__biz=MjM5NjQ5MTI5OA==&mid=2651772026&idx=1&sn=6ff4cb024bb416c46d5d2850a6ae77d1&chksm=bd120d378a6584217f1838c0f951204023e5c32b0ad413a731078e2f11f8f0009b39c3dec4ea&scene=21#wechat_redirect

但这个就很工程很机架了

稀疏神经嵌入

· 6 min read
ayanami

下午在看milvus文档的时候看到着重提了稀疏检索,注意到bge-m3是有神经稀疏检索的支持的,于是学习了一下,下面属于纯入门笔记。

https://bge-model.com/bge/bge_m3.html

image-20250525152523623

和传统的BM25等稀疏嵌入不同,bge-m3的稀疏嵌入是基于模型的,复用密集嵌入的前面层

BGE-M3 实现的是一种**“learned sparse embedding”(神经稀疏语义嵌入**)。与 SPLADE、uniCOIL 这类模型类似,这些都是让模型自适应学习每个 token 某种“匹配权重”,在大规模预训练和下游 fine-tune 时引入了专门的稀疏激活目标,使输出稀疏且有用

From tokens to BERT dense embeddings

From tokens to sparse embeddings.png

SPLADE 模型的全称为"Sparse Lexical and Expansion Model"(稀疏词法和扩展模型),结合了传统稀疏向量检索的优点和神经网络的语义理解能力。

wj=maxi∈tokenslog(1+ReLU(wij))w_j = max_{i\in tokens} log(1 + ReLU(w_{ij}))

image-20250525155231480

BERT 的 MLM 头部会为每个输入位置计算对词汇表中每个词元的贡献分数。这些分数反映了当前上下文下,特定词元与其他词元的关联强度。

Term expansion in the query can lead to much greater overlap between queries and relevant documents, helping us minimize the vocabulary mismatch problem.

也就是说,这个方法实际处理了三个问题:

  1. 词表不够大(或者分词精度不够)的问题,采用预训练BERT的词表和分词器,可以随着预训练模型的拓展而拓展;
  2. 针对传统稀疏编码需要精确词匹配、编码值实际上都是离散变化的问题,采用遍历整个词表,利用BERT的mask-预测概率,计算将原始句子的每一个词与词汇表中其他词的关联强度,对应logits即为wijw_{ij},从而实现了词汇的拓展,允许相关词、近义词匹配等
  3. 针对传统BM25中没有上下文位置关系的问题,利用BERT的位置编码和捕获双向信息的预测,将传统手工设计特征的部分取代

还有一些其他的操作比如稀疏化,用于提供较密集嵌入更强的筛选能力

SPLADE 使用 ReLU 激活和 MAX 池化操作来确保生成稀疏向量。ReLU 将负值置为零,增加稀疏性;MAX 池化则为每个词元选择所有位置中的最大贡献值,进一步增强了稀疏性 1。

此外,SPLADE 还使用正则化(如 FLOPS 正则化)来控制稀疏性程度:

L_FLOPS = λ * ||q_splade||_1 * ||d_splade||_1

这个正则化项通过惩罚向量的 L1 范数(非零元素的绝对值和)来鼓励模型生成更稀疏的向量

还有一个问题是:这个“关联强度"是什么?

从模型的角度说,这个关联强度向量就是BERT的嵌入再过一个MLP得到(vocab_size, )的向量

但实际上,这里并没有直接使用BERT的mask预测权重,而是针对信息检索进行了微调(使用MS MARCO数据集,100万条搜索引擎搜索数据)

image-20250525160740142

最后的损失函数是三者的加权组合

目前SPLADE稀疏向量的召回率已经显著由于BM25传统搜索引擎的召回率

img

但是BM25等传统方法就完全不行了吗?也未必,有文章指出SPLADE这样的基于模型的方法始终会受到预训练语料的领域限制,并且在垂域少量数据上训练/微调的成本开销都比较大,此时未必有简单的BM25 + 领域定制词典权重好

而作为召回的一道路径来说,还有许多额外的召回规则,例如通配符和前缀,编辑距离和短语......


很fashion的reranker https://www.mixedbread.com/blog/mxbai-rerank-v2

双模搜索:https://www.mixedbread.com/blog/the-hidden-ceiling

做了一系列实验证明了OCR质量在RAG系统中的重要性和目前的OCR方法质量的局限性,多模态生成用于检索的编码,OCR生成嵌入:检索时用能理解文本布局、复杂图表的多模态嵌入,而进入LLM的时候用OCR生成的文本

  • 他们也实验了使用图片/嵌入直接进视觉LLM,但效果不佳。提出的观点是LLM能够容忍文本的噪声和解析错误(文字质量下降),但不太能容忍精致且无关的文本(搜索质量下降),在传统rag流程中,OCR质量下降会直接导致搜索质量下降

RocketMQ学习

· 19 min read
ayanami

mq: 异步,解耦,削峰填谷

传统项目架构下,对网络波动没有耐受性

mq多用于分布式系统间进行通信

请求方/响应方 -> 生产者/消费者

优劣​

优势:异步,解耦,削峰填谷

  • 解耦: 消费方存活与否不影响生产方
  • 异步: 提速
  • 削峰填谷(作为一个buffer/cache), 提升系统稳定性,应对突发性高并发冲击

例子-电子商务下单:

生产者: 订单系统 -> MQ -> 库存系统、支付系统、物流系统、大数据系统(用户数据收集)(复制与多分发)

生产者发完消息,可以继续下一步业务逻辑

订单系统不需要新增业务代码,达成解耦

同时,订单系统可以发MQ消息之后就返回。准确地说,MQ消息 + 订单入库(校验等)

劣势:

  • 可用性降低: MQ宕机就寄,需要保证MQ的高可用
  • 系统复杂度提高:消息丢失? 消息保序?重复消费?
  • 一致性问题:多消费,部分成功,部分失败?下游失败怎么办?

市面主流MQ产品:

  • ActiveMQ: 万级吞吐,主从架构,ms延迟,现在不怎么用
  • RabbitMQ: erlang,us处理,万级吞吐,主从架构,较难维护
  • RocketMQ: java,十万级吞吐,ms级,分布式
  • kafka: scala, 十万级,ms级,分布式,功能比较少

rocketmq: 17年双十一,TPS 5600w

架构​

生产者集群 Producer

消息服务器集群 Broker 接受消息,提供消息,消息持久化,过滤消息,高可用

消费者 Consumer

命名服务器集群 NameServer Cluster 存储元数据**(Broker IPs)**

producer,broker,consumer向nameserver注册,nameserver用心跳确认其他组件的存活

image-20250524133745882

支持拉推两种模式,Consumer可以主动拉取,也可以用监听器模式

能推肯定是推省资源,免去轮询等

消息

  • Message
  • Topic 一级标题
  • Tag 二级标题

基础流程:​

Producer:​

生产者创建 - 设置nameserver - 生产者启动 - 创建消息(指定topic,tag,内容)- 发送(获取结果)- 关闭生产者

发送结果是什么?主要是记录消息元数据例如消息ID的一个结构体,和Future那种设计不一样

Consumer​

两类: DefaultLitePullConsumer 和 DefaultMQPushConsumer

对应拉取(额外线程轮询)和推送(长连接)模式

消费者创建 - 设置nameserver - 设置监听(订阅)主题 - 注册监听器(消息处理函数类,返回消息处理结果) - 消费者启动

设置监听的api rocketmq是这样设计的

subscribe(<topic>, <subExpression>)

这个subExpression通过通配符等支持,让api 表达力变强不少

  • 支持tag过滤
  • 支持sql过滤,在给消息追加属性的时候很有用
    • ><= BETWEEN IN IS NULL AND OR NOT

OneToMany 多消费​

多个消费者监听一个topic的默认行为:

  • 一条消息只会被消费一次
  • 多个消费者之间有默认的负载均衡

如果想要多个消费者都消费这条消息呢?例如上面的电商情况

  • 消费者组 consumer group概念

相同组的消费者,有负载均衡,单消费

  • 也可以修改消息模式,将默认的消费模式改掉
    • CLUSTERING -> BROADCASTING

单条消息会被复制数份,发送到每一个消费者组

  • “复制”是指HTTP传数次,不是存储文件复制

消息类型​

同步:即时性强、必须有回执,例如短信通知

异步:即时性弱,也需要有回执,如订单信息

单向:不需要有回执,如写日志

  • eg 分布式日志系统,所有Producer只管发

直接send(msg) 是发同步消息

send(msg, callback)是异步,等有结果再做处理

sendOneway是单向

延时消息

早期: v4.x

只支持不同的delayLevel,固定的1s 1m这样的时间

  • 固定级别的延时消息实现简单,为每个延时类别创建单独的队列来管理, 采用内部特定主题(SCHEDULE_TOPIC_XXXX)和队列来实现延时功能
  • 可能是简单的分队列定时扫描算法

后来:v5+

任意毫秒级时间戳延时,需要高效时间轮算法, 每条消息单独计时器跟踪

  • 时间轮算法:小时轮,分钟轮,秒钟轮。将消息“填入时间轮槽”(即每个槽是一个TaskList)

    • 层级时间轮,如果一个任务是1分30s, 会先被放入1分的分钟轮,处理到时,减去1分,降级放入秒钟轮
  • 将时间线分割成多个区间,不同区间采用不同精度的扫描策略, 近期消息采用高精度扫描,远期消息采用低频率扫描

  • 高效索引,分布式时钟对齐.....

批量消息

底层支持直接传 Collection<Message>

注意:

  • 相同的topic
  • 不能是延时消息
  • 总长度不超过4M (IBM默认最大消息长度设置,可以通过改环境变量修改,但4M算是一个实验值)
  • 相同的waitStoreMsgOK

Spring IoC集成​

直接在配置文件中指定name-server, producer group之类

类似Kafka/Redis, RocketMQTemplate 链接管理

convertAndSend 方法

  • convert? Spring的Template send发送的是抽象的message,只有一个byte[]的payload,convert就是在处理上层java类与下层不同的template需要的通信格式的转换

消费者也是和Kafka类似的

@Service的类 implements RocketMQListener<MessageType> 就行, @RocketMQListener(topic=, tag=,consumerGroup=, selctorExpression=, selectorType=, messageModal=)

然后这个类就作为监听类了,调用的方法就是重载方法onMessage(T t)

(这里Spring顺带还做了个返回值处理,只要没抛异常都是消费成功,抛异常消费失败回传)

其他的机制也整合了,例如同步异步单向延时批量之类对应syncSend, asyncSend, ...

消息保序​

消息错乱的原因,队列内有序,队列外无序

要做多队列的负载均衡,就不能无开销严格保证顺序

一连串的消息需要作为一个不能被拆分到多个负载均衡队列的整体

  • 一个实现messagequeueSelector的实体类,例如id hash + 取模

事务消息(无丢)​

image-20250524165007633

本地事务:如入本地数据库

事务状态:

  • 提交状态,允许进入队列
  • 回滚状态,不允许进入队列,当作没发生过
  • 中间状态,未对half做二次确认

代码实现

TransactionMQProducer

setTransactionListener: 正常事务过程, 补偿过程

  • executeLocalTransaction: 正常事务,入库等,根据本地事务状态返回消息状态
  • checkLocalTransaction:在正常事务超时等情况(实际上是正常事务函数返回了UNKNOW状态)时被调用,本地再次查询事务状态的函数

事务补偿还是UNKNOW?写个log或者其他人工介入方式

集群搭建​

多broker:

多master多slave架构

master slave同步消息的方式可以是同步(生产者阻塞请求)也可以是异步(不阻塞)

常见:一主三从

  • 只有brokerId为0的是主节点
  • brokerName是集群名

每一个broker会向所有的nameserver注册

image-20250525132947941

高级特性​

消息存储

一次完整的消费需要两个ACK

即Producer向Broker发消息,Broker返回ACK

Broker向Consumer发消息,Consumer返回ACK

但如果中间Broker宕机,就会出现重复消费

例如,在Broker返回ACK之前宕机,Producer就可能再发一次消息;在Consumer返回ACK之前宕机,Broker就可能再发一次消息。

解决方案是,在Broker返回Producer ACK之前,先将消息存储到磁盘上持久化(数据库中),在接收到Consumer ACK之后,Broker删除这一条消息

  • 如果在返回Producer ACK之前宕机,能从磁盘读消息避免重发
  • 如果在Consumer返回ACK之前宕机,也是同理

消息的存储介质

使用数据库:

  • ActiveMQ:缺点是数据库瓶颈成为MQ瓶颈

文件系统:

  • RocketMQ/Kafka/RabbitMQ:采用消息刷盘机制,进行数据存储

zero copy:mmap,java MappedByteBuffer

预留了一块空间进行顺序读写,默认1G commitlog

本质上,利用mmap,sendfile等系统api减少了内核空间与用户空间的数据交换次数。mmap处理文件-内存在内核态直通,sendfile处理内存-网络在内核态直通。省去的是内核态内存页到用户态内存页的拷贝,zero copy的用户程序都是没有持有数据copy的buffer的。

image-20250525135808051

刷盘机制

同步刷盘:先入盘再返回ACK

  • 可靠性高,性能低

异步刷盘:不挂起Producer线程,也先不写硬盘,将消息保留到内存之后就向Producer返回ACK,而是积累到一定batch的消息,再批量刷盘

高可用:

  • nameserver:
    • 无状态+全服务器注册
  • 消息服务器
    • 主从架构,2主2从
  • 消息生产
    • 生产者将相同的topic绑定到多个group组,保障master挂掉之后,其他master仍然可以正常接受消息
  • 消息消费:RocketMQ会根据master压力确认是否由master承担数据读取功能,master繁忙的时候,自动切换slave做承担数据读取的工作(读写分离)

负载均衡

Producer负载均衡

  • RocketMQ内部实现了不同broker集群中对同一topic对应消费队列的负载均衡

Consumer负载均衡

  • 平均分配(AABBCC)不好,循环平均分配(ABCABC)好
    • 原因,broker部分挂掉时,生产者的流量会被均分到剩下的broker上,如果平均分配,则有些对应挂掉的broker的consumer就不干活了,其他consumer压力会变大;循环平均分配则是将所有的consumer都分到剩下的broker上,避免了单个consumer压力过大

消息重试:

顺序消息:

  • 当消费消息失败后,RocketMQ会以1s为间隔进行自动重试。
  • 应用会出现消息消费被阻塞的情况,因此需要对顺序消息的消费情况进行监控(监控offset等),避免阻塞

无序消息:

  • 仅适用于负载均衡(集群)模型下的消息消费,不适用于广播模式

  • MQ设定了合理的消息重试间隔时长,有一个指数的backoff

  • 当重试到达指定次数(默认16次)后,MQ将无法被正常消费的消息称为死信消息。死信消息不会被直接抛弃,而是会被发送到一个死信队列中,供后续处理

死信消息不会再被重复消费,有效期为3天,过时后会被删除

死信处理,业务逻辑处理,或者人工介入

RocketMQ不可能完全避免重复消费,还是存在可能出现重复消费的情况:

  • 生产者发送重复消息,例如,网络闪断没收到ACK,生产者宕机
  • Broker和消费者之间网络闪断,消费者/broker重启
  • 客户端扩缩容
  • ......

所以不能完全依赖RocketMQ的幂等性,还是要在业务逻辑上做幂等性处理

  • 使用业务id作为消息key
  • 在消费消息时,客户端对key做判定,未使用放行,使用过抛弃
  • 注意:messageId由RocketMQ生成,不具有唯一性,不能做幂等判定条件

Kafka VS RocketMQ​

Kafka:

  • 专注简单与吞吐量: "Do one thing and do it well"的Unix哲学,专注于高吞吐的消息传递
  • 不可变数据流: 将消息视为不可变的数据流,适合事件溯源和流处理
  • 客户端复杂性: 将复杂性推向客户端,保持服务端简单高效

RocketMQ:

  • 丰富的消息功能: 目标是作为全功能的企业级消息系统
  • 服务端智能: 在服务端实现更多功能,减轻客户端负担
  • 电商场景驱动: 由阿里巴巴电商业务需求驱动设计,面向复杂业务场景

那么古尔丹,高吞吐量的代价是什么呢?

  • 偏移量指针的设计只能顺序前进,无法原生支持延迟时间,通过时间戳索引查找偏移量、专用延时主题、定时扫描来达到延时队列
  • 必须顺序处理消息,无法灵活跳过(异常消息)和回退(重放)
  • 消息路由和分布式一致性绑定,路由灵活性受限
  • 不支持消息优先级队列,因为都得按照offset指针顺序处理.....
  • 无法设置可见性超时等,都需要上层应用做
  • 消费失败的幂等性保证处理复杂,偏移量需要分布式维护增加网络开销.....
特性KafkaRocketMQ
定时/延时消息需外部实现原生支持 1
消息回溯支持(通过偏移量)支持(更灵活) 1
消息过滤有限支持服务器端支持SQL92表达式过滤 1
事务消息有限支持完整支持 1
死信队列不支持支持
消息优先级不支持不直接支持,但可通过设计实现
多租户隔离有限支持更好支持
消息轨迹追踪需外部工具原生支持 1

核心设计的哪些不同带来了这样的差异?

存储模型

Kafka:

  • 分散的文件存储: 每个主题的每个分区对应一个物理文件,消息按照写入顺序存储 1
  • 顺序追加写入: 使用顺序追加的方式写入文件,不允许修改已写入的数据
  • 偏移量指针: 消费者通过偏移量指针确定读取位置,不复制消息

RocketMQ:

  • 统一的文件存储: 所有主题的消息存储在同一组物理文件中 3
  • 逻辑分区: 主题和队列仅是逻辑概念,不与物理文件一一对应
  • 消息索引: 维护更复杂的索引结构,支持按多种方式查询消息

消息投递模型

Kafka:

  • 基于分区的消费模型: 消费者组内的消费者分配分区,消费者只能按顺序消费分区中的消息 1
  • 仅支持拉模式: 消费者主动从Broker拉取消息

RocketMQ:

  • 更灵活的消费模型: 支持更多的消费模式,包括集群消费和广播消费 1
  • 推拉结合: 同时支持推模式和拉模式,提供更灵活的消息投递方式
  • 消息过滤: 支持在服务器端进行消息过滤,减少不必要的网络传输

消息处理机制

Kafka: 消息就是字节数组

**RocketMQ: ** 消息包含更多元数据和属性

ucb cs186 课程笔记(更新中)

· 8 min read
ayanami

lec2​

join: inner join, natural join, outer join

sql 实际执行模型 写起来是 SELECT - FROM - GROUP BY - HAVING - WHERE - DISTINCT - ORDER BY

实际是 FROM(table过滤) - GRUOP BY(行分组) - HAVING(组过滤) - WHERE(行过滤) - DISTINCT(行去重) - SELECT(行内列过滤)

inner join:叉积,对AB所有行组合

SELECT * FROM TABLE1 t1, TABLE2 t2 
WHERE t1.id = t2.id
AND ...
-- 等效于
SELECT * FROM
TABLE1 t1 INNER JOIN TABLE2 t2
ON t1.id = t2.id
WHERE ...
-- 下面这种更加清晰一点
-- 等效于
SELECT * FROM
TABLE1 t1 NATURAL JOIN TABLE2 t2
WHERE ...
-- natural join就是在组合的基础上自动用了一个过滤,要求table所有相同名字的列的值都相同

outer join:

Left Outer join:

A LEFT OUTER JOIN B ON cond 如果cond满足的话,得到的是AB的组合(一行有A的列+B的列);如果不满足,得到A的列+空

Right Outer Join 同理

Full Outer Join 同理 例如ON A.id = B.id

如果有A没有对应的B, 那就是是 A + 空

如果有B没有对应的A, 那就是 空 + B

非常好的图

db-join

alias

简化 + 看起来更清楚(尤其是self-join)

FROM TABLE1 AS x, TABLE1 AS y

String Comp

LIKE或者正则S.name ~ '^B.*' (等效于S.name LIKE 'B_%')

AND OR 做条件交并

EXCEPT UNION (ALL) INTERSECT做子查询结果集合的交并差

IN EXISTS用于子查询 (NOT IN, NOT EXIST) EXISTS是判空

SELECT S.sname FROM Sailors S WHERE S.sid IN 
(SELECT R.sid FROM Reserves R WHERE R.bid=102)

还有ANY ALL

ARGMAX?

SELECT * FROM Sailors S WHERE
S.rating >= ALL
(SELECT S2.rating FROM Sailors S2)

View: Named Queries

CREATE VIEW xxx
AS ...

SELECT * FROM xxx;

cache and reuse

或者

WITH [viewname] AS [statement]创建一个临时view

NULL 参与的运算大多是NULL, 除了IS NULL,False AND NULL这种

lec3​

Disk & Buffer

整体架构

SQL client-> Query Parsing & Optimization->Relational Operators-> Files and Index Management->Buffer Management->Disk Space Management

Concurrency Control & Recovery

磁盘太慢,需要尽量减少读写,且寻道和旋转时间是大头

"block" && "page": 一个意思,磁盘上的块状读写最小单元 一般64KB-128KB

为了重用硬件驱动,经常会将磁盘空间管理器建立在文件系统API上,但带来了一些大数据库多文件系统的问题,也有直接建立在设备上的,更快但是移植性问题

给上层的抽象是一个巨大的文件

DB file: page的集合,每个page又包含了许多records

给上层提供:CRUD on records

record解构成一个"指针" {pageID, location on page}

structures

  • Unordered Heap Files(和数据结构heap没啥关系,无序records)
  • Clustered Heap Files
  • Sorted Files
  • Index Files

如何组织page呢?

链表? 想想就知道效率很差

类似目录的形式? 部分page只存到其他page的指针,并且始终放在缓存之中

page解构

Page Header:

  • Number of records
  • Free space
  • Mayba a last/next pointer
  • Bitmaps, slot table

record 中间留不留空?

不留空:Fixed Length Records, Packed

header后面跟紧密定长records, 因此可以有 record id = {pageId, record number in page}, 简单运算得到location

加很简单,直接append

删,全移一遍?->O(N),自然想到能不能lazy delete或者soft delete

方法是在header里面放一个delete bit的bitmap

变长?

slotted page

将信息存在footer(称为slot directory), record从头部开始存

由record id得到dir中位置,位置里面是pointer + length,

删,将slot dir中的项置空

插入,插在空位上,更新slot dir

fragmentation?

什么时候reorganize?->设计取舍,大部分时候没有那么多删除(乐)

slot不够->从page尾部向前增长

lec4​

cost model for ayalysis

B, D, R

  • the number of data blocks
  • the number of records per clock
  • avg time to r/w disk block
  • opt: index

indexes:

大幅度降低range操作耗时

An index is data structure that enables fast lookup and modification of data entries by search key

区间查找 & 子集搜索, 可以复合, 不需要唯一

2-d box 2-d circle n-d indexes都有

kd树啊R树啊

postgres 的 GiST index

left key opt: 最小的key是不需要的,直接拿-inf当下界就行

处理相等:>= 向右走就行

B+树

  • 叶子不一定是连续的-动态分配,指针连接以支持range scan

  • 阶数d, fan-out 2d+1 典型的fan-out 为2144()

  • 删除, 理论上来说, 可能涉及到重新平衡等操作 但实际的操作之中, 只需要删除即可, 原因是平衡太慢了,并且删了也能再插

叶子放什么?

  1. 数据

pros:

  • 快

cons:

  • 想要在另一列构建索引只能重新复制文件(文件只能按照一种方式实际排序存储)
  • 即使真复制了,同步问题也很寄
  1. 指向数据的指针 (key, page id+list of record id)

在b+树里面有重复项

  1. 指向同一个键的所有records (key, list of (page id + list of record id))

减少冗余,增加复杂性

clustered: index指向的数据块在磁盘上是按照这个index排序或者近似排序的

非常大影响性能 顺序比随机快100倍

对于一个有变化的数据,例如插入或者删除,需要一些成本进行磁盘数据的重新排序来维持clustered

B+树的平衡性:

使用字节数半满(占页面容量)就行, 甚至实际上更低, 按照实际性能来决定,不严格

变长key: 前缀压缩 trie

性能的常数:

由于顺序读写比随机读写快100倍

B+树比全表扫描差不多也是涉及到1%以下的表才有显著优势

所以例如对一个非聚簇索引进行一个跨越半个表的range的扫描, 那还不如直接把全表取出来

优化

由于B+树效率真的很低,所以有很多优化策略

  • bulk loading 批量装载
  1. Sort the data by a key.
  2. Fill leaf pages up to size f (the fill factor).
  3. If the leaf page overflows, then use the insertion split algorithm from a normal B+ tree.
  4. Adjust pointers to reflect new nodes if needed.

NJU操作系统(jyy OS)课程笔记-虚拟化部分

· 18 min read
ayanami

lec14 操作系统上的进程​

cpu有初始pc地址->放置固件上的初始程序(固件状态机)->启动OS(os状态机)->load init程序(程序状态机), 之后OS完全把行为转交给init(进程树的root)

llm 知道存在与知道的界限正在模糊: 知道存在且合理 逐渐趋同于 能做

例如 qemu 相关的一些东西

问llm发散出的概念->知识体系的快速建立

fork? 以状态机的视角理解

经典的for fork + printf

写了个示例

#include <cstddef>
#include <cstdio>
#include <cstdlib>
#include <stdio.h>
#include <unistd.h>
#include <vector>
#include <mutex>
#include <sys/wait.h>
#include <map>
#include <string>
using namespace std;
const size_t buf_size = 1024;
const std::map<int, std::string> mode_map = {
{_IONBF, "no buffer"},
{_IOLBF, "line buffer"},
{_IOFBF, "full buffer"},
};
void test(int __modes) {
printf("test in mode %s\n", mode_map.at(__modes).c_str());
fflush(stdout);
vector<int> childs;
std::mutex mtx;
setvbuf(stdout, nullptr, __modes, 0);
for (int i = 0; i < 2; ++i) {
int pid = fork();
printf("hello from pid %d\n", pid);
if (pid > 0) {
std::lock_guard<mutex> lock(mtx);
childs.push_back(pid);
}
}
}

int main() {
// _IOLBF, _IOFBF, _IONBF
test(_IOFBF);
printf("\n");
fflush(stdout);
return 0;
}

在_IOLBF和_IONBF的情况下会出来6个hello

每次printf都直接刷新/检测到换行符刷新缓冲, fork的时候没有IO状态 而_IOFBF会有8个hello, 在fork第二次的时候会带着缓冲区(就是一段内存空间)进行fork,所以最后的4个进程每个都带着2个hello

系统里面没有魔法

fork: 把所有的知道的不知道的都复制了

“是不是这样?” -> 不知道的底层状态被复制了

execve: 重置状态机 argc, argv, envp -> main()

execve是唯一一个可以新建一个状态机的系统调用

exit?

  • main return
  • exit libc提供的
  • _exit 系统调用退出(== asm volatile("mov ..., %rax; syscall"))
  • 直接SYSCALL

前两个在c语言的空间, 是“normal exit”

后两个不是normal的, _exit exit_group , __exit exit self

行为区别? strace

lec15 进程的地址空间​

pmap

/proc/[pid]/maps

vvar(r), vdso(rx), vsyscall

os内只读的syscall -> 可以以内存的形式共享

其实只需要进程能和OS交互一些数据就行 —— why not进程写page, OS轮询?

  • 在极端的时候能提高一些高优先级的进程的性能, 某篇OSDI

地址空间应该是在运行时可变的

所以我们需要一个不存在于c世界的操作(syscall)去操作地址空间 -> mmap, munmap

入侵进程的地址空间: gdb, perf

Game Genie 物理入侵地址空间

  • 外接电路: 当cpu读地址a的时候读到x, 则替换为y

jyy现场演示mini CE(雾)

gdb attach到虚拟机,查找满足某个模式的内存值, 修改之

/proc/[pid]/mem 修改器 = 调试器

xdotool: cmd X11 automation tool

ydotool: better xdotool -> 按键精灵

evdev 按键显示脚本

xdotool测试vsc插件, crazy

或许不需要那么多的“魔法工具”

OS: 解放编程能力, 什么事情在OS上可以做

变速齿轮: syscall是感知时间的唯一方法

gdb 脚本之中, 在gettimeofday打断点, 然后修改寄存器, amazing!!!

hook

patching: 整活, kpatch, 不停机更新(软件动态链接)

old func, rx -> 修改为rwx -> 修改old func为, jmp到new func

在chcore里面看看? 或许有必要研究一下gdb(attach with qemu)

lec16 syscall & unix shell​

everything is a file

thing: 操作系统里面的对象

gpt时代的“编程”——自然语言?

//OS: API:
// get_object_by_name(
// "the address space file of pid=1234"
// )

文件描述符: 指向OS对象的“指针”

windows: handle(句柄)

IPC endpoints: 例子, 管道

管道是同步的

fork + pipe? 本质是"指针"的拷贝

现在两个进程都有读口和写口啦

shell, kernel 的外壳

cli: 高效简洁的编程语言

算力的提升: cli -> gui -> 自然语言

shell as pl: 基于文本替换的快速工作流搭建

job control: 类比窗口管理器的"x", 最小化

或许不需要tmux, shell就是最简单的tmux

手册: complete ref

AI是“被动的”, 读一读shell manual

复刻unix shell

“抛开系统库”

-ffreestanding -nostdlib -static

gdb init已经很常见了, 但gdb init到python再在python里面转回/proc/[pid]/fd打印, 最后结合gdb的内置hook,在stop时候打印, fancy!

这打印的不是我们go的channel语法吗, 更有趣了

sh manual

lec 17 syscall的封装: libc​

pipe write如果小于PIPE_BUF, 是原子的

pipe 7

读者关闭: Broken pipe

libc 标准化, 稳定可靠, 移植性极好

C runtime library: -Wl, --verbose看到链接列表

调试glibc? 历史包袱重, 大量内联汇编, musl

只要实现了C ABI指定的堆栈排布的系统调用, 就可以轻松移植musl等到自己的OS上, 底层的计算由硬件指令集给出

System V ABI

脱开workload 做优化就是耍流氓

  • 在开始考虑性能之前, 理解需要考虑什么样的性能

workload哪里找? 当然是paper了(顺便白得方案)

  • 看wkld调性能

mm alloctor: 根基

  • 大对象应该有长生存期, 否则是performance bug
  • 越小的对象创建/分配越频繁
  • 小对象, 中对象, 大对象

瓶颈几乎是小对象

链表/区间树不是一个好想法: 上锁, 不能很好的并行化

设置两套系统:

  • Fast path 性能极好,并行度极高,覆盖大部分情况
  • Slow path 不在乎速度,但把困难的事情做好
  • 例如cache

init ram fs

ISA -> OS 对象/syscall -> libc -> 系统工具 coreutils, busybox -> 应用程序

initramfs

  • 加载剩余必要的驱动程序, 例如磁盘/网卡

  • 挂载必要的fs

  • 将根文件系统和控制权移交给另一个程序, 例如systemd

initramfs作为一个非常小的启动fs, 再把磁盘这个OS Object mount进来, 最后switch root把控制权给到磁盘的的根系统

启动的第二级阶段 /sbin/init

疯狂的事情不断有人在做, 但疯狂的事情的起点其实经常很小

lec 19 可执行文件​

elf不是一个人类友好的“状态机数据结构描述”

为了性能, 彻底违背了可读(“信息局部性”)原则

可执行文件=OS的数据结构(core.dump), 描述了程序应该的初始状态

支持的特性越多, 人类越不能理解

人类友好: 平坦的

回归连接和加载的核心概念: 代码、符号、重定位

my_execve

elf file -> parse as struct

-> 将各个section load到指定的地址(mmap)->asm volatile布置好ABI调用栈(根据手册)->jmp!

如何释放旧进程的内存资源?proc里面需要有记录

lec 21 syscall & ctx switch​

dynamic linker

se给的os基础还是很扎实的 很难想象ics2里面讲了GOT和PLT

SEE ALSO是一个宝藏 man ld.so

hacking: LD_PRELOAD不需要修改libc, 动态加载的全局符号, 先到先得

劫持大法!

kernel memory mapping

低配版Linux 1.X 分段, 内核在低位, 只是分个段

低配版Linux 2.X 内核还是在物理低位, 但程序看到虚拟地址已经是高位了

today: complete memory map

qemu is a state machine simulator: 调试syscall(gdb并不能si从用户态进kernel)

另一种理解中断的方式:"被"插入一条syscall

中断, 把状态机的整个寄存器状态存到内存里面

在汇编之中小心排布内存和搬运寄存器, 返回到c之中就是结构体的context

schedule的核心: 调用一个“不会返回的函数”

这个(汇编)函数以context为参数, 并且根据context, 返回到另一处控制流...

-> coroutine 也是如此! OS作为一个“状态机管理器”就在做一个"coroutine event handler"的作用

lec 22 process​

进程: “戴上VR”的thread

有自己的地址转换, 对一切的load/store会应用一个f,作用在addr上

硬件提供了“戴上VR”的指令

这个f从ds的视角来说就是int->int的映射

查页表(int->int的映射)这件事, 如何加速? --自然想到radix tree

普通实现是radix tree(x86, riscv, ...收敛到的最终方案)

每一次访存都要查这么几次的话不可接受

因此有了TLB, 但立刻带来的一个设计问题是, 谁来管TLB(以及对应的miss处理?)

x86选择放到硬件, 但丧失灵活性的后果是即使有些进程只想要f(x)=x, 也必须要老实查表, TLB在和cpu cache抢带宽

MIPS选择放到软件, miss了直接丢出来异常, 让软件来决定怎么处理TLB

疯狂的想法: inverted page table

把key从VPN换成 (VPN, pid), 然后从一一映射改成hashtable, 支持每个进程有自己的页表

缺点在例如hashtable带来的冲突时(TLB miss, etc)时间不可控(O(1) ~ O(n))

每个进程都有自己的“VR眼镜”这件事情还带来了更多的优化空间, 例如多个进程, 不同的虚拟地址块映射到同一个物理地址, 以及cow

KSM(kernel samepage merging/mermory deduplication), demand paging

fork: 进程快照, redis

cow fork的缺点: 让系统实现变复杂

改革: 砍掉所有的内核部分, 剩下的全部交给xv6

lec 23 处理器调度​

trampoline code

跳板代码, 例子

  • call printf -> call *GOT(printf)
  • JIT编译器
  • 软件热更新(patch 函数头)

资源调度(分配)是一个非常复杂的问题

建模, 预测, 决策 -> 调度策略的设计空间

调度策略

再加一层机制 "niceness", 管理员控制nice, 越nice越能得到cpu

10 nice ~ 10倍性能差异

taskset 绑定一个process到一个cpu上

round-robin时代: MLFQ, 动态优先级

  • 让出CPU(I/O) -> “好”

  • 用完时间片 -> “坏”!

1960s: breakthrough!

2020s: 对很多负载都欠考虑

今天的调度: CFS(complete fair scheduling)

但有vruntime, "好人"的钟快一些

真实的处理器调度: 不要高兴得太早...

  • 低优先级的在持有mutex的时候被中间优先级的赶下处理器, 可以导致高优先级的任务等待mutex退化到低优先级 -> 火星车

Linux: 没法解决, CFS凑合用

实时系统: 火星车在CPU Reset, 不能摆烂

  • 优先级继承, 条件变量唤醒?

  • lockdep预警

  • ...

然而不止有锁, 还有多处理器...

今天的计算机系统: SMP

多处理器的矛盾困境

  • 绑定一个线程:"一核有难, 八方围观"
  • 谁空丢给谁: cache, TLB白干

更多的实际情况: NUMA, 异构, 多用户

  • numa: 远近cpu性能差达到数倍

  • 多用户的cpu共享? namespaces, cgroups, 例如一个程序开并行, 另一个程序是串行的, 是否需要给串行的保留一个核, 而不是开得越多抢得越多

  • 异构, 大小核超小核, GPUNPU, 每个核的独有缓存和共享缓存...

  • 更少的处理器可能更快...(反直觉, 同步cacheline带来的开销)

复杂的系统无人掌控

ghOSt: Fast & Flexible User-Space Delegation of Linux

开始下放给应用程序做调度

Others​

早期优雅的设计可能会成为后续发展的包袱: fork+exec带来的膨胀, 所有涉及到OS内部状态的api都需要考虑fork行为, 例如文件偏移量...

总线, 中断控制器, DMA

总线: 提供设备的“虚拟化”, 注册和转发, 把收到的地址(总线地址)和数据转发到对应的设备上

这样cpu只需要直连一根总线就行了!

PCI总线

  • 总线可以桥接其他总线, 例如pci -> usb

lspci -tv可视化

"即插即用"的实现——非常复杂!

cpu: 只有一根中断线

启动多个cpu: cpu给其他cpu发中断!

中断仲裁: 收集各个设备中断, 选一个发给cpu

APIC(Advanced PIC):

  • local APIC: 中断向量表, IPI, 时钟, ...
  • IO APIC: IO设备

DMA: 很早期就有了, 解放cpu, 设计专用的电路只做memcpy

今天: PCI总线直接支持

文件 = 实现了文件操作的“Anything”

设备驱动程序: 一个 struct file_operations的实现, 就是一段普通的内核, “翻译”read/write等系统调用

/dev/null的驱动: read永远什么都不做返回0, write永远什么都不做返回count

一种"duck type"

设备不仅仅是数据, 还有配置

配置设备:

  • 控制作为数据流的一部分(自定义一套write的指令编码)
  • 提供一个新的接口

ioctl: 非数据的设备功能几乎完全依赖ioctl, 完全由驱动决定

数量最庞大,质量最低的shit

unix的负担: 复杂的hidden spec

/dev/kvm 硬件虚拟化, 支撑了几乎所有的云产商虚拟化方案

unix的设计: 目录树的拼接

将一棵目录树拼到另一棵上

回想最小linux系统, 只有/dev/console和几个文件

/proc, /sys, /tmp都是mount系统调用创建的

"看到的fs!=磁盘的fs", is just a view

像是procfs这种并非实际的fs更是, 可以挂载到任意的地方, 以任意的数量(因为他只是fake了read/write的“file Object”)

根本设计哲学: 灵活

灵活性带来的

  • /, /home, /var都可以是独立的设备, 把有些快的放在一个目录存可执行文件, 另一些存数据...

mount一个文件? loopback device

设备驱动把设备的read/write翻译成文件的rw

FHS: Filesystem Hierarchy Standard

ln -s 图结构 as 状态机

fs: 一个”数据结构题“, 但读写的单元是一个block

FAT: 集中保存所有"next"指针, 可靠性? 存n份!

fat manual

fat 小文件ok, 大文件不行

来本地部署大模型!

· 4 min read
ayanami

前言​

这件事情的起因是这样的, 在开卷上机考想要部署一个本机大模型参考一下, 同时有同学和我讲qwen2.5-coder-7B非常的nice, 于是就有了下面这篇文章, 用ollama + docker部署的local LLM...

本地环境: Ubuntu24.04

以下是步骤

下载nvidia docker runtime​

参考 https://docs.nvidia.com/datacenter/cloud-native/container-toolkit/latest/install-guide.html#installing-with-apt

apt

curl -fsSL https://nvidia.github.io/libnvidia-container/gpgkey | sudo gpg --dearmor -o /usr/share/keyrings/nvidia-container-toolkit-keyring.gpg \
&& curl -s -L https://nvidia.github.io/libnvidia-container/stable/deb/nvidia-container-toolkit.list | \
sed 's#deb https://#deb [signed-by=/usr/share/keyrings/nvidia-container-toolkit-keyring.gpg] https://#g' | \
sudo tee /etc/apt/sources.list.d/nvidia-container-toolkit.list
sudo apt-get update
sudo apt-get install -y nvidia-container-toolkit

设置 /etc/docker/daemon.json

{
"default-runtime": "nvidia",
"registry-mirrors": [
"https://1nj0zren.mirror.aliyuncs.com",
"https://docker.mirrors.ustc.edu.cn",
"http://f1361db2.m.daocloud.io",
"https://registry.docker-cn.com"
],
"runtimes": {
"nvidia": {
"args": [],
"path": "nvidia-container-runtime"
}
},
}

如果你需要代理, 参考配置加上

   "proxies": {
"http-proxy": "http://127.0.0.1:7890",
"https-proxy": "http://127.0.0.1:7890",
"no-proxy": ""
}

然后重启docker服务

sudo systemctl daemon-reload    
sudo systemctl restart docker

出现找不到"nvidia" runtime错误的, 检查有没有下载过docker desktop

下载过docker desktop的:

docker context ls
docker context use default

切换回default, 然后重启docker服务

下载ollama镜像​

mkdir -p /data/containers/ollama/data
vi /data/containers/ollama/docker-compose.yml

docker-compose.yml

name: 'ollama'
services:
ollama:
restart: always
image: ollama/ollama
container_name: ollama
runtime: nvidia
environment:
- TZ=Asia/Shanghai
- NVIDIA_VISIBLE_DEVICES=all
networks:
- ai-tier
ports:
- "11434:11434"
volumes:
- ./data:/root/.ollama
networks:
ai-tier:
name: ai-tier
driver: bridge
ipam:
config:
- subnet: 172.22.1.0/24

启动

cd /data/containers/ollama
docker compose up -d

之后会拉ollama (2G)

验证成功

docker compose ps
# 得到结果应该如下
NAME IMAGE COMMAND SERVICE CREATED STATUS PORTS
ollama ollama/ollama "/bin/ollama serve" ollama About a minute ago Up About a minute 0.0.0.0:11434->11434/tcp, :::11434->11434/tcp

下载模型​

qwen2.5:7b建议换成其他的代码专用模型, 根据自己的电脑显卡配置决定参数量

空间占用 7b:5G, 3b: 2G, 1B:1G

docker exec -it ollama ollama pull qwen2.5:7b

成功结果这样

pulling manifest
pulling 00e1317cbf74... 100% ▕████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████ 4.7 GB
pulling 4fa551d4f938... 100% ▕████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████ 12 KB
pulling 8ab4849b038c... 100% ▕████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████ 254 B
pulling 577073ffcc6c... 100% ▕████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████ 110 B
pulling ad1518640c43... 100% ▕████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████ 483 B
verifying sha256 digest
writing manifest
removing any unused layers
success

验证

❯ docker exec -it ollama ollama list
NAME ID SIZE MODIFIED
qwen2.5:7b 845dbda0ea48 4.7 GB 2 hours ago

What's next:
Try Docker Debug for seamless, persistent debugging tools in any container or image → docker debug ollama
Learn more at https://docs.docker.com/go/debug-cli/

开始服务​

docker compose up -d

会在localhost:11434起一个服务, 浏览器输入后正常会有Ollama is running

前端套壳​

ChatBox​

直接去官网下载

https://chatboxai.app/zh/install

设置里面指定一下模型

image-20241121211509468

aider版本​

参考https://aider.chat/docs/config/dotenv.html设置一下OLLAMA_BASE_API的环境变量

之后aider --model ollama/qwen2.5:7b 即可

下载自己看官网(pip install aider-chat)

ok, 大功告成!

[可选] IDE插件​

一个例子是Continue插件https://www.continue.dev/

参考官网, 据说vsc支持还行, jet bug不少

ostep阅读笔记:单机fs的崩溃一致性(chapter42-44)

· 10 min read
ayanami

chapter 42 崩溃一致性​

以一个传统的结构(linux ext2)为例子

一个磁盘group

inode bitmap | data bitmap | inode block | data block

磁盘映像

super | group0 | group1 | …

想要给一个文件追加一个block,需要改inode block, data bitmap 和 data block 3处

设想中途断电,硬件原子性在磁盘上是不好做的,所以可能在三个写入之中发生任意个写入落盘的情况

断电时已经修改的数据和后果的对应:

  • inode block, 元数据不一致,指向垃圾数据
  • data bitmap,元数据不一致,空间泄露
  • data block, 没关系
  • inode block + data bitmap, 文件是乱码,问题不大
  • inode block + data block,元数据不一致
  • data bitmap + data block, 元数据不一致,空间泄露

早期文件系统:fsck,让不一致发生,重启时修复,只确保元数据一致

  • 检查super block(发现系统大小小于分配块数等不健全的情况,可以考虑启用super block的备用副本来防止super block自身损坏)
  • 空闲块:inode, 间接块,以inode为参考, 修改inode bitmap达到一致, 所有看起来在用的inode都会有bitmap标记
  • inode状态:如果inode的字段不合法,认为不易修复,删掉这个inode
  • inode链接:扫描整个目录树,重新计算引用计数,如果找到已经分配的inode但没有目录引用,放到lost+found
  • 重复和坏块,清除不正确的指针
  • 目录检查:确保无环,目录中每个inode已分配等

磁盘清理工具:重排inode的data block来减少碎片

fsck 存在的一个问题:很复杂

fsck 最关键的问题:太慢了!

另外的方法:WAL

Linux ext34, Windows NTFS 采用的方法: 加上journal block

super | **journal** | group0 | group1 | …

journal中条目的形式:

TxB | inode | bitmap | data | TxE (物理日志,也有逻辑日志的做法,可能提高性能,节省空间)

checkpoint: 成功写入journal之后,就是一个checkpoint

先写WAL, 再写文件系统元数据,最后落盘data

问题:写日志的时候崩溃?

问题发生在,一条日志(以物理为例)可能太大,以至于不能被原子写入(常态)

  • 日志内的数据可以被磁盘调度为小块乱序写入
  • 写入的部分错误难以检查,例如在写入data段的时候出错,但其他部分正确(但也可以checksum? 这就是ext4的一项重要更新,通过在TxB和TxE之中包含checksum来加快写入速度)
  • 磁盘的写缓冲,早期OS强制写入顺序就是通过关中断实现的: 写A,关中断,写B;有缓冲的状态下,写入缓冲就会返回。还要保证顺序的话,一种是禁用写缓冲,更现代的方法是写屏障(有趣的是一些磁盘产商忽略了写屏障,即使存在错误的风险,“快速几乎总是打败慢速,即使快速是错的”)
  • 所以早期的方案是这样的,先写除了TxE之外的所有块,这部分出错这个事务就是未提交的,会被重置;然后第二步再写TxE, 磁盘保证写512字节的block的原子性,因而TxE是原子的。流程称为日志写入,日志提交,加检查点

此时,恢复仅仅是重放(replay)

批处理:

和TLB缓存很像,fs可以为了性能将磁盘写入合并批处理,在内存之中标记dirty

日志长度有限:循环,checkpoint之后前面的日志可以释放掉再重新写入

物理日志严重的写放大:元数据日志(linux ext3的另一个mode, windows NTFS),WAL之中不保存data段,只保存inode, inode bitmap,block bitmap等元数据修改。此时需要先写data, 来避免指向垃圾数据

  • 这样的“强制先写入被指向的对象,再写入指针”是崩溃一致性的核心

棘手的问题:块复用,感觉有点绕,总之是删除+文件夹这种递归结构+只记录元数据+重用得到了一些不好的结果,linux ext3的解决方法是删除也有revoke日志

其他崩溃一致性的解法:

  • COW
  • 反向指针,在被引用块里面添加引用块的引用(惰性崩溃一致性)
  • 软更新,排序所有写入,复杂
  • 乐观崩溃一致,例如校验和的方案

ZFS使用COW和日志

chapter43 LFS 日志文件系统​

很像LSM,同样是为了利用磁盘的顺序写,同时只做顺序写,读时读最新版本,GC回收旧版本数据

LFS将每次文件系统的更新都顺序写入(data, inode),并以写缓冲实现批量写的性能提高,带来一个问题是不知道inode在哪里了

因而引入了一个中间层imap,记录inode, addr的对,imap需要保证持久,每次写入inode时,imap进行更新

imap放在哪里?如果在固定段,由于它更新的频繁性,所以需要非常多的磁盘寻道,不可接受

所以把imap和inode一起,写到更新后面

那去哪里找imap呢?(有点像 一级一级的索引,现在要找索引入口)

在磁盘的固定处维护检查点区域CR, CR指向最新imap,而CR的性能可以通过降低更新频率,例如每30s定时更新来解决,inode的更新全放到imap了

imap还解决了递归更新的问题

读取的时候有内存缓存,直接读里面的imap就行

怎么做GC? 在data block的开头有对inode块的反向引用+自身在inode中偏移量T,称为segment summary block

所以data → segment → 查最新的imap得到inode addr → inode[T] == data ? alive : dead

更简单的空间换时间的方法,在imap里面记录版本号,在segment里面也记录版本号

清理哪些段?一种粗略的方法是冷热分离

经常覆盖内容的段是热段,尽可能保留;反之冷段可以早清

崩溃恢复

  • 写CR崩溃:1. 给cr做一个副本 2.更新cr时,通过 时间戳 + CR + 时间戳的方式,检测更新的一致性,时间戳是原子的
  • 其他崩溃:CR后的数据丢了,假设CR是30s, 那不超过30s, 当然可以在CR里面包含更多信息,从而在最后一个检查点之后,尽量找到日志的结尾,并尽可能恢复有效的段,称为前滚 roll forward

LFS的思想在ZFS, Linux btrfs等有所体现,通过快照来得到fs的版本化

chapter 44 检测错误​

磁盘错误:“有声的” 和“无声的”

  • 前者例如意外的不可读,数据位反转,可以被ECC修复或检错的,总之会被磁盘发现
  • 后者如写歪了

前者的解决方法是各种方式的RAID

后者的解决方法是校验和,xor, add, fletcher, crc

像“写歪了”(addr x写到y, 磁盘A写到B)这种如何检测?在校验和之中加入块的磁盘和扇区号这样的物理标识符

还有一个特殊的情况是写入丢失,解决方法有写入后检验,或者在inode上加校验和(这样inode + data block全写丢了才会发现不了)

何时检测:定时,磁盘的位是会衰退的

system-design-interview笔记

· 27 min read
ayanami

限流器​

  • 放在哪里?

    • 客户端, 容易被伪造绕过
    • 服务端应用代码, 灵活性高, 但占据工程资源
    • 云上微服务, api网关等, 灵活性低
  • 经典算法:

    • 令牌桶: 固定速率产生令牌, 每个请求消耗令牌

      • pros: 容易实现, 内存占用少, 允许突发流量
      • cons: 调参困难, 可能需要不断填充桶
    • 漏桶: 请求进入一个定长FIFO队列, server给定速度从队列取数据处理

      • pros: 容易实现, 内存占用少, 请求以固定速率处理
      • cons: 突发请求占据队列使得新请求得不到处理, 调参困难,可能需要不断填充桶
    • 固定窗口计数器: 每一个给定时间窗口进行计数,例如每分钟100个请求

      • pros: 容易实现, 内存占用少
      • cons: 突发请求可以达到两倍限制的QPS(在窗口边缘有突刺)
    • 滑动窗口日志: 记录请求时间戳, 数据保存在redis等缓存,每当新请求进来的时候把过时时间戳删除, 如果请求时间戳比时间窗口的最低值还低, 拒绝请求

      • pros: 速率限制准确
      • cons: 内存开销大, 需要存储多个时间戳
    • 滑动窗口计数器: 某时刻限制请求数 = 窗口上限 - 上一个窗口请求数 * 这一个窗口的和上一个窗口的重叠百分比。例如, 窗口为每分钟1000, 上一分钟800, 在这一分钟的30秒时, 限制这一分钟窗口的请求数最多为 1000 - 30 / 60 * 800 = 600

      • 相当于假设上一个窗口的平均速率

      • pros: 平滑了流量峰值, 内存高效(只需要计数)

      • cons: 不太严格, 然而其实可以

        然而,这个问题可能并不像它看起来那么糟糕。 根据Cloudflare[10]所做的实验,在4亿个请求中,只有0.003%的请求被错误地允许或限制速率

超过速率限制

如果一个请求被限制了速率,API会向客户端返回一个HTTP响应代码429(请求太多)。根据不同的使用情况,我们可能会将速率受限的请求排队等候以后处理。 例如,如果一些订单由于系统过载而受到速率限制,我们可以保留这些订单以便以后处理。

限流器请求头

一个客户如何知道它是否被节流?客户端如何知道在被节流之前允许的剩余请求的数量?答案就在HTTP响应头中。限流器向客户端返回以下 HTTP 标头:

  • X-Ratelimit-Remaining:窗口内允许请求的剩余数量
  • X-Ratelimit-limit:它表示客户端在每个时间窗口可以进行多少次调用
  • X-Ratelimit-Retry-After:等待的秒数,直到你可以再次提出请求而不被节流。

当用户发送过多请求时,将向客户端返回 429 too many requests 错误和 X-Ratelimit-Retry-After 标头。

  • 规则被存储在磁盘上。工作者经常从磁盘中提取规则,并将其存储在高速缓存中。
  • 当客户端向服务器发送请求时,该请求首先被发送到限流中间件。
  • 限流中间件从缓存中加载规则。它从Redis缓存中获取计数器和最后一次请求的时间戳。根据响应,限流器决定:
    • 如果请求没有速率限制,它将被转发到API服务器。
    • 如果请求受到速率限制,限流器会向客户端返回 429 too many requests 错误。 同时,请求被丢弃或转发到队列。

分布式限流

redis:

  • lua脚本
  • sorted set每个用户有一个自己的set,试图执行动作时,使用MULTI原子地执行下列操作: ZREMRANGEBYSCORE 删除给定时间间隔前的元素, ZADD 添加当前时间戳, ttl设置为rate limit,计算sorted set的数量,如果超过限额,就失败 (滑动窗口日志)(有一说一我觉得这个如果没有精确的需求不如滑动窗口计数器, 开销感觉有点大)

多限流器同步: 用户hash redis集群分配之类, 尽量别做这种事情

其他层级的限流:

  • iptables
  • ...

一致性hash​

基本步骤如下:

  1. 使用均匀分布的哈希函数将服务器和键映射到环上。
  2. 要想知道一个键被映射到哪个服务器,从键的位置顺时针查找,直到找到环上的第一个服务器。

步骤是很简单的, 麻烦的是问题

环上服务器分区大小难以保证相同(添加删除服务器)

解决方法: 虚拟节点(分成更小的块)

每个服务器动态地分配小块(虚拟节点), 这样还可以考虑服务器容量自动缩放问题

一致性模型​

N = 副本数

W = 大小为 W 的规定写入。要将写入操作视为成功,必须从 W 个副本确认写入操作。

R = 大小为 R 的读取规定人数。为了使读取操作被认为是成功的,读取操作必须等待至少R个副本的响应。

如何配置N、W和R以适应我们的使用情况?

下面是一些可能的设置:

  • 如果R=1,W=N,系统被优化为快速读取
  • 如果W=1,R=N,系统被优化为快速写入
  • 如果W+R>N,就可以保证强一致性(通常N=3,W=R=2)。
  • 如果W+R<=N,则不能保证强一致性

复制->高可用->不一致

发现并解决冲突: 常用是向量时钟 vector clock, 但有几个问题

  • 处理冲突逻辑复杂
  • 动态增加删除服务器逻辑复杂

参考:

实际业界的用例参考Dynamo

算法简介:在每个服务器内部维护一个所有服务器的vector

  • 当自己发生事件时,增加vector[self], 并告诉需要告诉的服务器(核心就在于不广播, 没有全局时间!当然也因此不保证解决冲突)
  • 当自己收到A server的事件时, vector[A] += d

最后想要觉得一个事件的全局顺序的时候, 查看所有的server的vec

如果有一个server的vec是最大的,那么严格有因果关系,取它的值就行

但如果没有最大的vec, 就需要解决冲突的策略

策略

  1. 交给客户端, 如dynamo
  2. 加上时间戳, vec' = [...servers, timestamp]冲突取ts最大的
  3. 随机取一个

所以向量时钟算法的实质是:

(1)将逻辑上可以合并的冲突成功合并;

(2)逻辑上无法合并的冲突依旧冲突;

拓展: 向量时钟的剪枝, riak, 牺牲绝对的正确性(false merge)来换取对太长的vec clock的剪枝

gossip 协议 quorom

唯一ID生成器​

  • 多主复制: 下一个id += k, k是服务器数量,拓展性差

  • uuid

    • 引自维基百科,"在每秒产生10亿个UUIDs,大约100年后,创造一个重复的概率会达到50%"。

    • 优点:

      • 生成 UUID 很简单。服务器之间不需要协调,因此不会有任何同步问题。

      • 该系统易于扩展,因为每个 Web 服务器负责生成它们使用的 ID。 ID 生成器可以轻松地与 Web 服务器一起扩展。

    • 缺点:

      • ID 是 128 位长, 空间开销。
      • ID 不会随时间上升
      • ID 可以是非数字的
  • ticket服务器, 在分布式系统之中维持一个唯一的ticket server用于签发id

    • **优点:**数字 ID,易于实施,适用于中小型应用程序

    • **缺点:**单点故障

  • twitter雪花算法

    • 符号位:1 位,它将始终为 0。这是为将来使用保留的。它可以潜在地用于区分有符号数和无符号数。
    • 时间戳:41 位。自纪元或自定义纪元以来的毫秒数。我们使用 Twitter 雪花默认纪元 1288834974657,相当于 2010 年 11 月 4 日 01:42:54 UTC。
    • 数据中心 ID:5 位,这给了我们 25=3225=32 个数据中心。
    • 机器 ID:5 位,每个数据中心有 25=3225=32 台机器
    • 序列号:12 位。对于在该机器/进程上生成的每个 ID,序列号都会递增 1。该数字每毫秒重置为 0。

也就是说雪花在一台机器上1毫秒可以支持4096个新id

额外要点:

  • 时钟同步。在我们的设计中,我们假设 ID 生成服务器具有相同的时钟。当服务器在多个内核上运行时,此假设可能不成立。同样的挑战存在于多机场景中。时钟同步的解决方案超出了本书的范围;但是,了解问题的存在很重要。网络时间协议是这个问题最流行的解决方案。
  • 节段长度调整。例如,较少的序列号但较多的时间戳位对低并发性和长期应用是有效的。
  • 高可用性。由于 ID 生成器是关键任务系统,因此它必须具有高可用性

拓展阅读: 网络时间协议

短URL​

点击较短的别名重定向到原始url

  • URL缩短:给定一个长的URL => 返回一个短得多的URL

  • URL重定向:给定一个短的URL => 重定向到原来的URL

  • 高可用性、可扩展性和容错考虑

值得在这里讨论的一件事是 301 重定向与 302 重定向。

  • 301重定向。301重定向表明,请求的URL被 "永久 "地移到了长URL上。由于是永久重定向,浏览器会缓存响应,对同一URL的后续请求将不会被发送到URL缩短服务上。相反,请求将直接被重定向到长网址服务器。

  • 302重定向。302重定向意味着URL被 "暂时 "移到长URL上,这意味着对同一URL的后续请求将首先被发送到URL缩短服务上。然后,它们会被重定向到长网址服务器。

每种重定向方法都有其优点和缺点。如果优先考虑减少服务器负载,使用301重定向是有意义的,因为只有同一URL的第一个请求被发送到URL缩短服务器。然而,如果分析是重要的,302重定向是一个更好的选择,因为它可以更容易地跟踪点击率和点击的来源。

一个简单的解决方案 <shortURL, LongURL>的rdbms

假设系统支持3650亿个url=10年 * 每天1亿

可以使用0-9a-zA-Z62个字符, 62^n > 3650 亿 n = 7

方法1: hash+碰撞解决

longURL -> hash -> short -> exist on db?(opt bloomfilter + query) -> save/return/collision

collision 的一种解决方法是 longURL -> longURL + predefined string

方法2: base62转换

给每一个请求的长url分配一个数字类型的唯一id, 再对唯一id做base62转换

坏处是可能出现安全问题

longURL -> in DB ? -> yes,return short
|
-> no, generate new ID -> id to base62 -> save id, longurl, shorturl in db

读多于写, 加缓存

爬虫系统​

算法侧: 从url seed开始, 将link视为边, 用BFS去爬取不同的网页

架构侧:

seed url -> url frontier -> html downloader(DNS resolver) -> content parser -> content seen(重复检测器, 例如 hash, BF) + 存储-> link extractor -> url filter -> url seen -> url storage

优先级: 简单的做法是根据Url内容变化的速度(可以基于历史抓取记录)和本身的价值(例如是个人博客还是官方网站)设计一个优先级估价函数, 根据url区分k个工作队列, 保证一个队列内只有一个url(的多个请求), 这样就可以实现优先级

爬虫需要考虑礼貌性, DDoS

做法是每个url作为一个后端队列, 在优先级的selector出来之后, 维护一张(url,back queue)的表, 将url放到back queue里面去

对每一个url(backqueue), 维护一个时间t, 是下一次抓取的最早时间(例如当前时间+10倍前一次获取时间)

而爬虫线程每次从时间的最小堆之中取出元素, (如需要, 等待到t), 然后爬取

html下载器: Robots 排除协议, 分布式抓取, 超时

其他问题: 冗余内容, 蜘蛛陷阱, 垃圾数据, js-需要动态渲染得到链接和其他数据

通知系统​

删重, 跟踪, 限速, 用户设置(接受哪些通知), 失败时的重试机制, 安全性(客户验证)

推送流:

核心在fan out系统, 读扇出(拉模式)还是写扇出(推模式), 热键问题和速率问题

混合: 对大多数用户使用推送模式。对于名人或有很多朋友/粉丝的用户,我们让粉丝按需提取信息内容以避免系统过载

get friend IDs: graph DB

fanout service先从graph DB拿到friend ids, 再从用户缓存(用户db)得到朋友相关信息:

例如,如果你把某人调成静音,她的帖子将不会显示在你的信息流中,尽管你们仍然是朋友。帖子可能不显示的另一个原因是,用户可以有选择地与特定的朋友分享信息或对其他人隐藏信息。

把更新的需求包成任务(例如<post_id, user_id>)丢到mq

mq入库, 写缓存

缓存层级:

  • News Feed:它存储了信息的ID。

  • Content:它存储每个帖子的数据。受欢迎的内容被存储在热缓存中。

  • Social Graph:它存储用户关系数据。

  • Action:它存储有关用户是否喜欢帖子、回复帖子或对帖子执行其他操作的信息。

  • Counters:它存储点赞、回复、关注者、关注等的计数器。

聊天系统​

无状态有状态分离

  • 无状态的服务 http

    无状态服务是传统的面向公众的请求/响应服务,用于管理登录、注册、用户资料等。这些是许多网站和应用程序中的常见功能。

    无状态服务位于负载均衡器后面,其工作是根据请求路径将请求路由到正确的服务。这些服务可以是单体的,也可以是单独的微服务。我们不需要自己建立许多这样的无状态服务,因为市场上有一些服务可以很容易地被集成。

    我们将深入讨论的一个服务是服务发现。它的主要工作是给客户提供一个客户可以连接到的聊天服务器的DNS主机名列表。

  • 有状态的服务 websocket

    唯一有状态的服务是聊天服务。该服务是有状态的,因为每个客户都与一个聊天服务器保持持久的网络连接。在这个服务中,只要服务器仍然可用,客户通常不会切换到另一个聊天服务器。服务发现与聊天服务密切协调,以避免服务器过载。我们将在深入研究中详细介绍。

服务器的切分:

  • chat server 管理信息的收发
  • presence server 管理在线/离线状态
  • api server 处理无状态服务
  • notification server 推送通知

DB选择: KV数据库

为什么?聊天数据的读写模式

  • 数据量巨大 需要水平拓展
  • 只有最近的聊天记录才会被频繁访问
  • 但“最近”里面也不完全是顺序的, 引用, 跳转, 提及等
  • 读写比约为1:1, 读并不远远高于写

这样的wkld下kv比关系型的优势:

  • 水平拓展轻松
  • 分层架构对热数据容易优化
  • 关系型数据库的index在数据量变大时昂贵

消息ID设计:

一对一聊天: 主键message id

群聊: 复合主键 {channel_id, message_id}

问题: id用什么?

要求: 唯一性 + 可以按照时间排序

  • 自增: 分布式实现困难
  • 全局序列号发生器: 将时间项提前就可以按照时间排序
  • 本地序列号生成器: 只保证消息在一个组内(channel内)唯一, 实现比较简单

发送信息的流程

  1. 用户A向聊天服务器1发送了一条聊天信息。
  2. 聊天服务器1从ID生成器获得一个信息ID。
  3. 聊天服务器1将消息发送至消息同步队列。
  4. 消息被储存在一个键值存储中。
  5. a. 如果用户B在线,信息被转发到用户B所连接的聊天服务器2。
  6. b. 如果用户B处于离线状态,则从推送通知(PN)服务器发送推送通知。
  7. 聊天服务器2将消息转发给用户B,用户B和聊天服务器2之间有一个持久的WebSocket连接。

群组聊天:

第一种方法: A发消息, 在每一个成员的收件箱里面复制一个副本, 适用于群组人数较少的时候(例如微信的500人约束); 每个收件人有自己的收件箱(消息同步队列), 所以并不保证一致性

在线状态指示器:

  • naive的做法: 建立连接就在线, 断开就离线。问题在网络波动时候, 变化太快
  • 更优雅的做法, 心跳
  • 推送, 类似微信这种小群(500人限制)可以直接查询实时的ws连接。大群需要懒加载

扩展聊天应用程序以支持媒体文件,如照片和视频。媒体文件的大小明显大于文本。压缩、云存储和缩略图是值得讨论的话题。

  • 端到端加密。Whatsapp支持信息的端到端加密。只有发件人和收件人可以阅读信息。有兴趣的读者请参考参考资料中的文章[9]。
  • 在客户端缓存信息,可以有效地减少客户端和服务器之间的数据传输。
  • 提高加载时间。Slack建立了一个地理分布的网络来缓存用户的数据、频道等,以获得更好的加载时间[10]。
  • 故障处理。
    • 聊天服务器错误。可能有数十万,甚至更多的,坚持不懈的连接到一个聊天服务器。如果一个聊天服务器离线,服务发现(Zookeeper)会提供一个新的聊天服务器,让客户建立新的连接。
    • 消息重发机制。重试和排队是重发消息的常用技术。

多媒体支持的大体流程

  • client 通过 rest 将多媒体资源发送到服务器
  • 服务器转换媒体文件(例如图片生成缩略图, 压缩)
  • 服务器存到s3
  • 服务器通过s3链接响应client
  • 客户端再将s3链接通过ws发送(广播)给聊天的其他用户
  • 其他client 收到s3连接, 根据定义的消息类型进行渲染

简单的搜索支持: trie​

topK: 先找到前缀, 再遍历子树

问题: 太慢

解决方法:

  • 在每个节点缓存常用的前k个查询
  • 控制前缀的最大长度

更新trie: 数据搜集, 对于实时应用服务, 短时间间隔; 对于非实时的, 可以例如一周定时更新一次

合法性: 自动完成可以根据hash等过一个filter, 避免补出禁止的网站等

多语言:unicode trie

分片: 可以基于字母, 但是要考虑到频率问题

实时(趋势)搜索: 流式, 领域特定, AI

视频流

核心是分成几个部分, 一部分类似传统的server, 提供视频metadata

另一部分依托云服务和CDN, 做好视频传输和解码编码

其中特定部分的逻辑复杂, 例如解编码的模块化和引擎化, CDN贵所以视频基于历史数据做冷热分离, 冷视频走自建而不是CDN

还有比如错误处理, 数字版权之类

具体好多细节

临近服务​

由于是读远多于写的情况, 所以常见用关系型db

关系型的问题是, 如果是经纬度, 二维数据index利用率低

解决方法是二维转一维再index搜索, 例如geohash, R tree, 四叉树, google s2

geohash: 经纬度网格编码再转base32, 共享前缀越长, 越接近

边界问题: 反过来不成立, 接近的两个地块可能共享前缀并不长(在子午线/赤道等大格子边界), 所以geohash LIKE 'sth%'检索出来结果不全

方法是不仅检索自己格子的geohash, 也把邻居格子的一起检索

业务问题:范围内部商家不够, 解决方法是放大格子继续检索

google s2: 基于希尔伯特曲线的球面->1d算法, 保证2d上接近在1d上也接近

代码熟练度、过度设计与工程哲学

· 7 min read
ayanami

今天和朋友们聊了很多关于编程风格、熟练度和工程实践的话题,记录一些思考。

熟练度也是能力的重要一环​

逐渐感觉"熟练度"本身也是能力的重要一环,一个需求查半天API和拿来就写差别还是挺大的,前者会懒癌发作直接开摆(,并且时间成本也是很大的成本。

但除非只关注一个小领域,熟练某个东西还蛮难的,感觉必须得代码量喂出来,上下文切换多了每次都忘得干净,对于Web类还好,反正试错和纠错成本极低,对于其他的就经常因为一些小错误浪费很多时间。

比如我是真记不住算法()

这多少也是我机考翻车王的原因。LC刷了hot100,但很快忘光了。

过度设计的倾向​

说实话我感觉自己是有过度设计的倾向的,快速糊一些代码会非常别扭难受,然后改来改去改来改去,经常为了"这个字段该放在这个类里面吗"、"这个函数是不是应该再做一次抽象"、"API的参数怎么设计"这种事情整半天。

一个例子:QBasic作业​

今天看同学的文章讲到QBasic写了15个小时感觉实在太久了,有同学写了10个小时就写完了。

但我作为一个"老登"写的C++比他们多不少的情况下,却写了40个小时()。先是想要多类型支持,后面想要完整BNF,再是尝试一切Modern C++化,再是做Qt Signal的中间层,再是测试(测试还想玩玩新框架),再玩模板和编译期检查,再引入其他的……

确实写Java写的了这下。虽然感觉写得可维护性很高,但实际上并没有人会来维护(跑)。就像我的QLink也写了40h,战线拉太长导致机考翻车了都不知道这个API哪发癫了,上次用这个API还是两三个月前.jpg。

设计哲学的影响​

曾经刷的公开课的某个逻辑对我影响还是蛮深的:通过API设计、类设计、测试等,来用各种类型检查、名字确认等来避免自己写错的代码,而不是用人脑来避免自己写错。

这其实也是诸如DDD(领域驱动设计)之类的精髓。

好处是能轻松完成小项目到中大型项目的过渡,但坏处是让人在熟练度不够的时候写得更慢了。但我感觉有点太依赖这个了,导致我其实没有"糊出一个东西"的能力——例如没有类型就非常难受,API写的中途之中一补不全,这个逻辑就并不是很直观,就感觉API可以继续重构,然后继续折腾。

这辈子就是被Clean Code和设计模式害了(bushi)。我感觉我性能上的优化也不是很认真做,天天折腾这个代码优不优雅,这辈子有了。

过程导向 vs 结果导向​

感觉我这样的整法就是很不利于考场的,因为你把重心放到过程而非结果的时候,自然就会淡化非过程的记忆。

之前有人讲他在学OS的时候在记一个"概念"是怎么被"推导"出来的,但不知道自己这样整到底重要还是不重要。anyway,我在学的时候也是:算法/机制的具体细节和代码是记不清的,就记得个思想/推导作为索引,到时候真用到了就依赖AI现查。

所以没有AI、补全和网络就大废功力()

Go语言的慰藉​

所以有些时候我真挺喜欢Go的:语法突出一个简洁,又有GC和goroutine解放大脑,引入外接库简单,编译还快,net、log之类的标准库在API设计上比C++ std不知道高哪里去了,defer之类的关键字也令人心情愉悦。

C++ API这么多细节这么杂真记不住啦。

SE同学的码量分布​

有人觉得SE的同学码量应该很大所以算法没问题,但我觉得并非如此——SE的同学的码量是集中在系统上的。架构、文件、并发、加速这些可以给你很快的看,但算法属实是"数据集不够,欠拟合了"。

工程和算法完全是两个东西。OI里面你只需要靠cout和瞪眼检查就行了,因为dev的debug和CLion等相比差远了。

该规范规范,该潦草潦草——真正的工程智慧可能就在于知道什么时候该追求完美,什么时候该快速迭代。感觉糊业务代码还是可以的,这下上班圣体了。

李沐dl笔记

· 30 min read
ayanami

vgg​

内存占用大,推理慢(深),但效果好

卷积层参数小,全连接层最大问题是参数太大过拟合

所以最后一层全连接是很大的问题

大参数还有内存 bound 的问题

NiN​

用卷积层替代全连接

两个 1*1 卷积无 padding, stride1 起全连接的作用(只做通道混合)

每个卷积后面跟两个全连接作为 NiN block

交替使用 NiN 块和 stride = 2 的 maxpooling 逐步减小高宽和增大通道数

最后使用全局平均池化得到输出(通道数 = 分类个数)

打印结构:

for layer in net:
X = layer(X)
print(layer.__class__.__name__, "output shape:\t", X.shape)

超级宽的 hidden layer: 非常容易过拟合

泛化性提高-> 收敛变慢

全连接的方案: 非常强, 收敛很快

GoogLeNet​

inception 块: 不做选择, 全都要

output = output1 + o2 + o3 + o4

o1 = conv1x1

o2 = conv1x1 + conv3x3, padding 1

o3 = conv1x1 + conv3x3, padding 1 + conv5x5, padding 2

o4 = 3x3 maxpool, padding 1

四条路径从不同层面抽取信息, 在输出通道合并 concatenation

四条路径分配不同的通道数(你认为那种模式哪个通道的信息更重要)

降低通道数来控制模型复杂度

googlenet 5 段, 9 个 inception 块

不降低维数的 1x1 卷积就是通道融合

第一个 stage 总是把通道数拉上去, 高宽减下去, 先筛选出足够多的特征

v2: batch normalization

v3: 5x5-> 3x3, 5x5-> 1x7+7x1(单长和单宽)

v4: 残差连接

优点是模型参数少, 计算复杂度低

批量归一化​

损失出现在最后, 后面的层训练快

反向传播: loss 在顶层, 数据在最底部, 底部的层(前面的层)训练慢, 底部层一变, 所有都得跟着变

导致离 loss 近的后面层需要重新学习多次, 导致收敛变慢

有没有方法让学习前面层的时候避免变化后面层?

批量归一化: 将分布固定, 来让输出模式稳定一些, 固定小批量的均值和方差

正则化, 将数据分布固定为 N(0,1)N(0,1) 正态分布, 数据的修改只是在变化正态分布的超参数, 限制变化不要太剧烈

对于全连接, 作用 在激活函数前面, 作用在特征维度

对卷积, 作用在通道维

效果太好了, 原始论文觉得是减少内部协变量转移, 后续发现 可能就是等效于在每个小批量里面加入噪音来控制模型, 均值近似于随机偏移, 方差近似于随机缩放

因此没必要和丢弃混合使用

加速收敛(模式更稳定之后可以把 lr 调得更大), 但一般不改变模型精度

根据内存挑 batch size, 不能太大也不能太小, 然后调学习率和 epoch

ResNet​

残差的重要性不必多言

深网络必有残差思想

新硬件​

DSP 主要做数字计算处理长指令, FPGA 可编程阵列

工具链质量良莠不齐, 一次 "编译" 需要很久

AI ASIC: Google TPU eg

核心 systolic array, 专门做大矩阵乘法 2d 计算单元(PE)阵列, 卷积换成矩阵乘法

一般的矩阵乘: 切开和填充匹配 SA 大小

批量输入来降低延时, 其他硬件单元来处理别的 NN 操作子, 例如激活层

多卡并行​

数据并行(切割小批量), 模型并行(切割模型, 适用于模型太大的时候),

all reduce: 将所有 gpu 的结果放到一个 gpu 上, 然后相加, 加完再复制回其他 gpu

nn.parallel.scatter

nn.DataParallel

多卡时也要相应的加大 batchsize 和 lr

大 batch size 在小模型上会采出重复样本导致浪费和一定程度上的过拟合

分布式

GPU 和 GPU 通信快, 和 CPU 通信慢, 和交换机网卡更慢

  • 类似存储器山

解法是把 parameter server 尽量从 cpu 搬到 gpu 上

这样简单的 parameter 迁移分配就能在 gpu 本地完成, 不涉及到 cpu 的 copy(感觉像 DMA)

每个 worker 拿参数, 复制到 GPU 上, 每个 GPU 算自己的梯度, GPU 梯度求和, 传回服务器, 再更新, 回发

类似 mr, server mapper, 本地 gpu 完成计算和 combine, 在 server reduce

同步 SGD, 每个 worker 同步计算一个批量

所以需要调 batch size, 来针对并行省下的时间与通信开销做 trade off

实践:

  • 大数据集
  • 好的 GPU-GPU 和机器-机器带宽
  • 高效的数据读取和预处理
  • 好的计算(FLOP)和通信(model size)比 Inception > ResNet > AlexNet
  • 足够大的 batch size
  • 高效优化算法(因为 batch size 变大了, 如何适配)
  • 更复杂的分布式有异步, 模型并行

一般 N 个类, batch size 差不多到 10N 再往上就不太能 fit 了

数据增广​

已有数据集让他有更多多样性

  • 在语言里面加背景噪音
  • 改变图片的亮度, 颜色, 形状

一般的做法: 原始数据在线生成, 随机增强

测试不做增强

翻转:

  • 左右翻转, 上下翻转
  • 切割, 随即高宽比, 随机大小, 随机位置

其他:

  • 高斯模糊
  • 锐化
  • 变形
  • 滤镜
  • 马赛克(相当于遮挡, 逼着去看全局)
  • ...

从实际部署的场景反推需要什么样的增强

异常检测, 偏斜数据, 重采样, 增广

mixup 增广: 有效但不知道为什么

torchvision.transforms

微调(迁移学习)​

标注一个数据集很贵

希望在大数据集上做好的东西, 能以小代价迁移到小数据集上

神经网络分层两块: 特征提取+线性分类

dl: 让特征提取变得可以学习, 而不是人来提取特征

训练:

  • 更强正则化
  • 更小学习率
  • 更少的数据迭代

源数据集远复杂于目标, 微调效果更好

固定一些层, 固定底部一些层的参数, 不参与更新

低层次的特征更加通用

小 trick, 微调的时候最后一层用大学习率, 前面用小的

迁移的也不能差太大, 否则效果很可能不够好

目标检测​

bounding box

锚框: 提出多个被称为锚框的区域, 预测每个框里面是否有关注的物体, 如果是, 预测锚框到真实框的偏移

交并比 IoU

每个锚框是一个训练样本, 要么标注成背景, 要么关联一个真实边缘框

可能生成大量锚框, 导致大量的负类样本

选择合适的锚框(赋予锚框标号):

先生成一堆框, 之后算锚框 i 和真实框 j 的 IoU, 在 i, j 之中找最大的, 就得到了一组锚框和真实框的对应

然后从集合中剔除这个锚框 i 和边缘框 j(删除矩阵行列), 再找下一组

重复直到真实框为空, 这就是正类样本, 剩下的锚框挑一些作为负类样本

锚框生成: 一种固定切分画格子

NMS 非极大抑制: 合并相似的预测框

  • 选中非背景类的最大预测值
  • 去掉所有和它 IoU 大于阈值的预测
  • 重复直到所有预测要么被选中, 要么被去掉

生成锚框的另一种示例方法

宽度 wsrws\sqrt r, 高度 hs/rhs/\sqrt{r}

对给定几组 (s,r)(s,r) 对每(n)个像素生成

算法的核心之一: 如何生成高质量锚框

锚框到偏移的算法: 多种多样

autogluon

工业界很少用模型融合和测试增强, 计算代价过高

通常固定模型超参数, 简单模型, 精力花在提升数据质量和加入的新数据

RCNN:

启发式搜索算法选择锚框

预训练模型对每个锚框抽取特征

训练一个 SVM 对类别分类

训练一个线性回归来预测偏移

RoI pooling

锚框均匀分割 mxn, 输出每块里面的最大值

不管锚框多大, 总是输出 mn

Fast RCNN

不再对每一个锚框抽取特征

而是将所有的锚框丢进 cnn(输入里面对应的映射区域), 一次 CNN 对整个图片抽取

Faster RCNN: 使用区域提议网络代替启发式搜索来获得更好的锚框

2-stage

Mask RCNN 如果有像素级别的编号, 给每个像素做预测, 用 FCN 利用信息

Faster RCNN: 速度非常慢, 精度高

SSD: single stage

基础网络抽特征, 多个 conv 减半高宽

每段都生成锚框

  • 底部段拟合小物体, 顶部段拟合大物体

对每个锚框预测类别和边缘框

yolo: 追求快

ssd 锚框大量重叠, 浪费计算

均匀切分 SxS 个锚框, 每个锚框预测 B 个边缘框

后续有许多微调和改进

工业常用

非锚框: 例如 central net

语义分割​

像素级分类

应用: 背景虚化, 路面分割

另一个相近的概念: 实例分割

数据集: 输入是图片, label 也是图片(每个像素的值就是 label)

crop: 怎么做, 对输入进行裁剪, 在 label 上也要相对应的裁剪

拉伸也是需要特殊处理的

旋转? 一种是可以加一个 label 是旋转角度, 另一个是可以在转完的斜框上涨再画一个大框框住斜框

人像: 难点在光照, 阴影和背景

人像语义分割: pretrain model 已经很成熟

转置卷积​

卷积的问题:不能很有效的增加高宽

类似语义分割这种-> 卷积不断减小高宽, 会影响像素级别的输出

Y[i:i+h,j:j+w]+=X[i,j]×KY[i:i+h, j:j+w] += X[i,j] \times K

增大输入高宽

为什么是转置卷积:

卷积等价于矩阵乘法 Y=VXY = VX, 转置卷积就是 Y=VTXY = V^{T}X

nn.ConvTranspose2d

卷积是下采样, 卷积是上采样

转置卷积与线性插值: 可以用线性插值作为转置卷积核的初始值

FCN​

全连接卷积神经网络

用 dl 做语义分割的最早工作

用转置卷积替换 CNN 最后的全连接层+全局池化

  • 先过 1x1 conv 压缩通道
  • 再过转置卷积拉大图片, 得到像素级别的切分
    • 思想是每个像素的的 label 信息这个 feature 应该存在 channels 里面

net = nn.Sequential(*list(pretrained_cnn.children()))[:-2]

可以用双线性插值的矩阵初始化转置卷积层的 kernel

loss: 由于每一个像素都有了 label

所以在矩阵上做均值再 cross_entropy

样式迁移​

基于 CNN 的样式迁移

核心思想: 训练一个 CNN, 将他作用在内容图片上得到输出, 在样式图片上得到输出

而输出图片在内容层上的输出和内容图片在内容层上的输出相近(content loss)

输出图片在样式层上的输出和样式图片在样式层上的输出相近(style loss)

训练的不是 CNN, 而是输入网络的的“输出图片”

哪些层是“style layer”, 哪些是 "content layer"?

样式: 最小, 中间和上层, 较均匀

  • 样式有全局的特征和局部的特征, 各个尺度均有

内容: 偏末尾的层, 靠近 loss

  • 允许内容上更多的变形

内容损失可以是简单的 MSE

  • 元素值, 通道里面的值, 认为是内容

样式损失? 通道内部和之间的统计分布, 认为是样式

  • 分布匹配, 一阶平均值, 二阶协方差, 用二阶就还不错

最后: tv_loss, 不要有噪点, 每个像素和周围像素不要差太多, 计算每个与周围的 MSE 再求平均

这几个损失如何加起来? 加权平均, 权值是超参数

style 一般更重要, 例如 content:style:tv=1:1000:10

这几个超参数的调整是训练几次之后, 观察三种 loss, 调到差不多大小得出的

不更新: y.detach()

卷积只作为抽特征

麻烦: 后续技术, GAN, 使用 CNN 接收随机输入生成图片等

序列模型​

标号和样本是一个东西: 自回归模型 t-k ~ t-1 -> t

方法 A: 马尔可夫假设: 假设当前数据只和 k 个过去数据点相关

方法 B: 潜变量模型: 引入潜变量 hth_t 来表示过去信息 xt=p(xt∣ht)x_t = p(x_t|h_t), ht=f(x1,...xt−1)h_t = f(x_1,...x_{t-1})

那我们就可以将预测拆成两步:

  1. ht=Model1(ht−1,xt−1)h_t = Model1(h_{t-1}, x_{t-1})
  2. xt=Model2(ht,xt−1)x_t = Model2(h_t, x_{t-1})

文本预处理​

预处理的核心是分词

GPU 上存算的是 token 索引而非字符串

语言模型:

给定文本序列, 估计联合概率

  • 做预训练模型
  • 生成文本
  • 判断多个序列之中哪个更常见

简单方法: 基于计数建模

序列很长的时候, 由于文本量不够大, 可能 n(x1,...xt)≤1n(x_1,...x_t)\le 1

使用马尔可夫假设缓解, n 元语法假设, 假设只和前 n 个词相关

以二元为例, 则有 p(x1,x2,x3,x4)=n(x1)x1n(x1,x2)n(x1)n(x2,x3)n(x2)n(x3,x4)n(x3)p(x_1,x_2,x_3,x_4) = \frac{n(x_1)}{x1} \frac{n(x_1,x_2)}{n(x1)} \frac{n(x_2,x_3)}{n(x2)} \frac{n(x_3,x_4)}{n(x3)}

RNN​

更新隐藏状态: ht=ϕ(Whhht−1+Whxxt−1+bh)h_t = \phi (W_{hh}h_{t-1} + W_{hx}x_{t-1} + b_h)

输出: ot=ϕ(Whoht+bo)o_t = \phi (W_{ho}h_t + b_o)

训练的模型: Whh,Whx,Who,bh,boW_{hh}, W_{hx}, W_{ho}, b_h, b_o

如果没有 Whhht−1W_{hh}h_{t-1} 就是 MLP

loss 设计: 困惑度 perplexity

把输出看成是词典大小为 label 数量的话, 可以用交叉熵, 然后对整个句子取平均

但实际不是用这个, 而是用 exp(平均交叉熵)

梯度裁剪: 在 T 个时间步上的梯度, 反向传播 O(T)矩阵乘法, 梯度爆炸

如果梯度长度超过 θ\theta, 变回 θ\theta

g×min(1,θ∣∣g∣∣)→gg \times min(1, \frac{\theta}{||g||}) \to g

更多的 RNN:

  • 1 对多: 文本生成
  • 多对 1: 文本分类
  • 多对多: 问答, 机器翻译
  • 多对多: tag 生成

GRU&LSTM​

对于一个序列, 记住相关观察需要 更新门(能关注的机制) + 重置门(能遗忘的机制)

Rt=σ(XtWxr+Ht−1Whr+br)R_t = \sigma (X_tW_{xr} + H_{t-1}W_{hr} + b_r) reset gate

Zt=σ(XtWxz+Ht−1Whz+bz)Z_t = \sigma (X_tW_{xz} + H_{t-1}W_{hz} + b_z) update gate

候选隐状态

Hcand(t)=tanh(XtWxh+(Rt⊙Ht−1)Whh+bh)H_{cand(t)} = tanh(X_tW_{xh} + (R_t \odot H_{t-1})W_{hh}+b_h)

RtR_t : [0,1][0,1] 软控制

Ht=Zt⊙Ht−1+(1−Zt)⊙Hcand(t)H_t = Z_t \odot H_{t-1} + (1 - Z_t) \odot H_{cand(t)}

隐藏层多大? 例如 128,256, 长序列就 1024

实际不考虑 RNN, 一般 GRU/LSTM

超过 100,1000 这样的长度量级, 考虑 Attention

LSTM

忘记门: 将值朝 0 减少

输入门: 决定是不是忽略输入

输出门: 决定是不是使用隐状态

image-20250121223000822

更深(多个隐藏层)的 RNN, 更多的非线性性

双向 RNN

一个前向 RNN 隐层

一个反向 RNN 隐层

合并两个得到输出

image-20250121230923026

output 是前向和反向的共同贡献

推理怎么推? 非常不适合做推理, 几乎不能推

主要作用: 对句子做特征提取, 填空, 而不是预测未来

输入需要定长(为了以 batch 的形式读入)

如何做不定长的? 填充或者截断, 例如翻译

encoder-decoder 架构​

encoder: 将输入编程成中间表达形式(特征)

decoder: 将中间表示解码成输出

encoder 将 state 传给解码器做输入

seq2seq​

encoder 是一个 RNN, 可以双向

decoder 是另一个 RNN

编码器是没有输出的 RNN

encoder 最后时间步的 hidden state 作为 decoder 的初始 hidden state

训练, 训练时 decoder 用目标句子作为输入

衡量生成序列的好坏: BLEU

image-20250122095953273

exp 项: 防止 pred 句子长度过短偷懒提高精度

BLEU 越大越好

seq2seq: 从一个句子生成另一个句子

sequence_mask:在序列中屏蔽不相关的项(padding)

拓展 softmax 来屏蔽不相关的预测(padding 对应的 output)

预测

最开始输入 <bos>, 然后 RNN 每次输出作为下一个的输入

seq2seq 可以纯 transformer

束搜索​

beam search

seq2seq:用当前时刻预测概率最大词输出(贪心)

但贪心很可能不是最优的

暴搜指数级增长肯定不行

bin search: 对每个时刻, 保存最好的 K 个序列

每一次新预测会对 k 的 kn 个可能的下一个序列之中再调最好的 k 个

如何选择 "最好"?

单纯的概率乘总是倾向于选择短句子, 需要给长句子加权

每个候选的最终分数 1Lαlogp(y1,...yL)\frac{1}{L^{\alpha}}logp(y_1,...y_L), 取 α=0.75<1\alpha=0.75 < 1 给长句子加权

Attention​

卷积, 全连接, 池化只考虑“不随意”的线索

  • "最大值", 明显的特征

注意力机制显式地考虑随意线索

  • 随意线索被称为查询 query
  • 每个输入是一个值 value 和不随意线索 key 的对
  • 通过注意力池化层来对有偏向性的选择某些输入

非参(不需要任何先验参数)注意力池化层

给定数据(环境, 先验, context) (xi,yi)(x_i,y_i)

查询: 给定一个 x, 求对应的 y=f(x)y=f(x)

注意力: f(x)=∑iα(x,xi)yif(x)=\sum_i \alpha(x,x_i)y_i, α(x,xi)\alpha(x,x_i) 就是注意力权重

最简单的方法: 平均池化, f(x)=1n∑iyif(x)=\frac{1}{n}\sum_i y_i

更好的方案是 60 年代的 Nadaraya-Watson 核回归

f(x)=∑iK(x−xi)∑jK(x−xj)yif(x)=\sum_{i} \frac{K(x-x_i)}{\sum_j K(x-x_j)}y_i

高斯核 K(u)=12πexp(−u22)K(u)=\frac{1}{\sqrt{2\pi}}exp(-\frac{u^2}{2})

f(x)=∑isoftmax(−12(x−xi)2)yif(x)= \sum_{i} softmax(-\frac{1}{2}(x-x_i)^2)y_i

参数化:

再引入可以学习的 w

f(x)=∑isoftmax(−12((x−xi)w)2)yif(x)= \sum_{i} softmax(-\frac{1}{2}((x-x_i)w)^2)y_i

相较非参的注意力, 变得更不平滑

拓展到高维度 α(q,ki)\alpha(q, k_i)

  1. Additive Attention: 可学参数 Wk∈Rh×kW_k \in R^{h\times k}, Wq∈Rh×qW_q \in R^{h\times q}, v∈Rhv \in R^{h}

a(k,q)=vTtanh(Wkk+Wqq)a(k,q) = v^{T}tanh(W_kk + W_qq)

等价于将 kv 合并之后放入一个隐藏大小为 h, 输出大小为 1 的单隐藏层 MLP

也是当 q, k 不一样长的时候最常用的做法

如果 q, k 都是同样长度的

2.Scaled Dot-Product Attention

a(q,ki)=<q,ki>/dka(q,k_i)=<q,k_i>/\sqrt{d_k}, 相当于 q 在 k 基上的分量+归一化

a(Q,K)=QKT/da(Q,K)=QK^{T}/\sqrt{d}

f=softmax(a(Q,K))Vf=softmax(a(Q,K))V

Q, K, V 是一个矩阵?self-attention 自注意力 f=softmax(XXT/d))Xf=softmax(XX^{T}/\sqrt d))X

但实际运用会给 X 做不同线性线性变换后再输入

f=softmax(XWQXTWK/d))XWVf=softmax(XW_QX^{T}W_K/\sqrt d))XW_V

Attention 机制的 seq2seq​

翻译的词可能相关于原始句子之中不同的值

原始 seq2seq 只能看到单一词的输入, 虽然有隐藏层, 但长距离丢失信息

  • encoder 的对每个词的输出作为 key 和 value(key = value)

  • decoder RNN 对上一个词的输出是 query

  • attention 的输出和下一个词的 embedding 合并进入 decoder

原始的 seq2seq 相当于是只将上一个词的 state+t-1 时刻的 encoder 输出丢到了 decoder 里面

decoder(statet,eoutputt,outputt−1)decoder(state_{t}, eoutput_{t}, output_{t-1})

现在拓展其表达力, 认为 decoder 应该获取的不是单单最后一个词的输出, 而是和之前的词输出(更长的上下文)都有点关系, 具体关系用 attention 学习, 以编码器的 output 作为 query key, 获取这个 output 最相关的上下文, 并认为翻译的文本之中也应该有类似的上下文关系

decoder(statet,attention(outputt−1,eoutputs,eoutputs))decoder(state_t, attention(output_{t-1}, eoutputs, eoutputs))

tokenizer: sentencepiece

embedding: 专业词, 需要调整 tokenizer, 需要添加词 pair, 需要训练新添加的 embedding, 正常领域 frozen 不动, 加 LoRA/Adapter

自注意力​

self-attention

序列长度是 n, 卷积核大小 k

CNNRNNself-attention
计算复杂度O(knd2)O(knd^2)O(nd2)O(nd^2)O(n2d)O(n^2d)
并行度O(n)O(n)O(1)O(1)O(n)O(n)
最长路径O(n/k)O(n/k)O(n)O(n)O(1)O(1)

自注意力适合处理长文本

代价: 计算代价 n2n^2 增长

位置编码:

和 CNN, RNN 不同, 自注意力没有记录位置的信息, 位置编码将位置信息注入到输入里

  • 输入 X∈Rn×dX\in R^{n\times d}, 叠加位置编码 P, X+P 作为自编码输入

pi,2j=sin(i100002j/d),pi,2j+1=cos(i100002j/d)p_{i,2j}=sin(\frac{i}{10000^{2j/d}}),p_{i,2j+1}=cos(\frac{i}{10000^{2j/d}})

为什么这么设计

记 ωj=1/100002j/d\omega_j = 1/10000^{2j/d}, pi+δ=RotateMatrix(δωj)×pi,δp_{i+\delta} = RotateMatrix(\delta \omega_j) \times p_{i,\delta}

所以实际上是相对位置的编码

也就是对于同一个序列 j, 位置 i 有 <i, i+k> 的关系的 pair 始终是一个相同的关系

Transformer​

纯基于(self-)attention

encoder-decoder 架构

multi-head attention

对同一的 QKV, 希望抽取不同的信息

使用 h 个独特的注意力池化

image-20250122150747190

attention 没有时序信息, encoder 无所谓

decoder 不应该看到不该看到的信息, 需要加入掩码

计算 xix_i 输出时, 假装当前序列长度为 i

基于位置的前馈网络 Positionwise FFN

将输入形状 (b,n,d)(b, n, d) 变换成 (bn,d)(bn, d), 输出再换回来

两层全连接, 添加非线性, 做更多的特征融合

FFN(x)=f(xW1T)W2FFN(x)=f(xW^{T}_{1})W_2

Add&Norm: 残差+归一化

image-20250122152949678

编码器的输出 y_1, ... y_n

作为解码器之中第 i 个 transformer 块之中多头注意力的 key 和 value

预测, t+1 输出

decoder 输入前 t 个预测值作为 key, value, 第 t 个预测还作为 query

Bert​

nlp 的迁移学习

使用 pretrain 的模型抽取词句的特征

不更新 pretrain 模型

问题: 1. 做 embedding 的话忽略了时序信息 2.后续模型还要自己设计, 只有 embedding 似乎没有很大用处

Bert: 能不能也通过改最后一层复用?

只有编码器的 transformer

对输入的修改:

  • 每个样本都是一个句子对

  • 加入额外的片段嵌入

  • 位置编码可学习

三种 embedding: position, segment, token

image-20250122155938538

通用的任务?

任务 1: 带掩码的语言模型

带掩码的语言模型每次随机(15%概率)将一些词元换成 <mask>

微调任务之中不出现 <mask>

微调任务是没有 <mask> 标记的,如果设计方案是:只要 token 被选中 mask 处理,并且处理方法只要一种就是 token 别替换为 <mask>,这样的话,预训练任务和微调任务的数据太不一样了。BERT 的 3 种 mask 方法,可以使得,有 20%情况,句子对没有 <mask> 标记。

我理解的说白了就是不仅仅是因为看到了 <mask> 才去找上下文的信息,而是一直保持联系上下文的“习惯”

  • 80%下, 变成 <mask>
  • 10%, 随机(错误的结果)
  • 10%, 原有(正确的结果)

10%的词会被替换成随机词元的原因: 作者在论文中谈到了采取上面的 mask 策略的好处。大致是说采用上面的策略后,Transformer encoder 就不知道会让其预测哪个单词,或者说不知道哪个单词会被随机单词给替换掉,那么它就不得不保持每个输入 token 的一个上下文的表征分布(a distributional contextual representation)。也就是说如果模型学习到了要预测的单词是什么,那么就会丢失对上下文信息的学习,而如果模型训练过程中无法学习到哪个单词会被预测,那么就必须通过学习上下文的信息来判断出需要预测的单词,这样的模型才具有对句子的特征表示能力。另外,由于随机替换相对句子中所有 tokens 的发生概率只有 1.5%(即 15%的 10%),所以并不会影响到模型的语言理解能力。(网上复制的,这是我找到的可以说服我自己的一个解释)

任务 2: 下一句子预测:

训练样本之中, 50%选择相邻句子对, 50%选择随机句子对

微调 Bert​

bert 对每一个次元返回抽取了上下文信息的特征向量

不同的任务取不同的特征

  • 句子分类, 将 <cls> 对应的向量输入到 MLP 分类
  • 命名实体识别, 识别一个词元是不是命名实体, 例如人名机构位置
    • 把每一个非特殊词元(不是 <cls><sep>...)放进 MLP 分类
  • 问题回答: 给定一个问题和描述文字, 找一个片段作为回答
    • 对片段的每一个词元预测是不是回答的开头或者结束

实用机器学习

不讲模型, 讲数据

知识积累, 学会读论文, 经典论文需要读懂每一句话

结合代码了解细节

对读过的论文做整理

形式化验证与自动化测试探索

· 4 min read
ayanami

最近在学形式化验证相关的内容,顺便探索了一下自动化测试的工具链。

形式化验证入门​

读了一篇很好的文章:SAT/SMT, z3, Model Checking, Translation Validator - 有关形式化验证我所知道的一切

好文,有点像一个综述,涵盖了SAT/SMT求解器、z3、Model Checking、Translation Validator等。

伟大的CDM(计算离散数学),这学期上的最好的两门课CDM & CSE(计算机系统工程),让我对这些概念有了更深的理解。

从Model Checker到自动化测试​

在看Model Checker的时候,想到了自动化(生成)(单元)测试。

首先先把AI-based的方法ban了——无法保证正确性,还需要人review的话,感觉不如让测试工程师自己用AI。

已有的工具​

好像只有Java有一个EvoSuite,能在AST层面自动生成单元测试。逛知乎又看到一篇文章,是在AST的level上给C++生成单测的,但可惜不开源:C/C++ 单元自动化测试解决方案实践

Hypothesis:Python的属性测试库​

wow,伟大的AI帮我找到了一个有趣的Python库:Hypothesis

给出的例子就很吸引人了。Hypothesis是一个**属性测试(Property-based Testing)**库,你只需要描述代码应该满足的属性(不变量),它会自动生成大量测试用例来尝试找到反例。

from hypothesis import given, strategies as st

@given(st.lists(st.integers()))
def test_sort_is_sorted(xs):
result = sorted(xs)
assert result == sorted(result)
assert set(result) == set(xs)

完全符合我对一个自动化测试/验证的库的想象!感觉如果用Python写一些算法的话会很好用。

Schemathesis:API测试的利器​

实际上是因为看到了这个库:Schemathesis

感觉能自动化超级多的垃圾时间。如果能做CI/CD集成的话再好不过了。

感想​

感觉以后写Web项目真得最开始就和OpenAPI一套架子搭好。有了规范,就能自动生成文档、自动测试、自动验证——这才是工程化该有的样子。

想给jcourse生成一个OpenAPI文档,感觉两种方案:

  1. Annotation based:加注释,工作量好大
  2. 架构重构:彻底重构handler层,通过约定和配置覆写默认的处理方法,降低灵活性带来更好的集成

参考了这篇文章:Autogenerated API Documentation in Go with OpenAPI/Swagger

Java味道太足了,但确实是经过验证的好实践。

赛博乱逛:TypeSpec、GraphQL与eBPF

· 3 min read
ayanami

今天是赛博乱逛的一天啊嗯,刷到了不少好东西。

eBPF:无处不在的内核技术​

偶然看了一个eBPF的纪录片:https://youtu.be/Wb_vD3XZYOA

才知道这么多东西都是eBPF-based的,例如 Prometheus。赞美。

eBPF(Extended Berkeley Packet Filter)是Linux内核中的一项革命性技术,它允许在内核空间中安全地运行用户定义的程序,而无需修改内核源码或加载内核模块。

你可能已经在用eBPF了却不自知——Prometheus的底层监控数据采集、Cilium的容器网络方案、Falco的安全监控、各种网络性能分析和可观测性工具,底层都是eBPF。

GraphQL的反思​

搬两篇知乎,选修课划水实在是没事干()

TypeSpec:API设计的新选择​

就说刷知乎能刷到好东西。微软还有这个:https://github.com/microsoft/typespec/

我们TypeScript玩家真是吃得太好了:

  • RPC和REST无缝切换
  • 原生的validator集成
  • 一键导出OpenAPI,再由OpenAPI导入各种API的GUI,例如 Apifox,真正的类型安全带示例高亮一眼就懂的多端通用API doc

OpenAPI那种沟槽的类YAML的缩进配置文件就是要被DSL狠狠羞辱啊!

最喜欢的类型安全! 定要把GraphQL的字符串拼接打倒在地啊!

对DSL的思考​

不诋毁编译原理了(3天限定版)。这感觉真是DSL在提升优雅性,但编译后端依然是很"屠龙技"的感觉。

TypeSpec这类DSL的核心价值在于:用类型系统来约束API的设计,让错误在编译期就被发现,而不是在运行时。这和TypeScript的设计哲学一脉相承——让写正确的代码容易,让写错误的代码难。

后端学习路线​

有人问学习路线,整理了一下:

后端方向:

前端方向:

JUC

· 11 min read
ayanami

自旋锁->自旋N次(N自适应, 取决于先前历史,当前负载等)->升级为重量级锁

重量级, mutex 本质上的syscall, 轻量级, CAS去尝试拿到对象头中的锁标识字节MarkWord

更新成功说明没人抢

偏向锁: 当某个线程第一次获取锁时, 接下来都没有其他线程拿, 那这个线程后续拿锁就连CAS也不需要

无锁->偏向锁->自旋锁->重量级锁

JMM

所有可能出现竞争的变量(成员, 静态等)均在主内存

局部变量线程私有, 工作内存相互隔离, 只能通过主内存同步

volatile

需要立即看到修改的值, 每一次读取都从主线程读, 每一次写都把工作内存的值刷新到主线程

cs144 labs(Winter 2024)

· 31 min read
Tags:
ayanami

Lab0​

这个lab纯纯的热身lab, part1是用webget简单进行个请求, 类似csapp的网络lab part1

part2字符串操作, 恶心一点的就是string_view的peek和一个ring buffer不太能兼容, 总之我的代码效率也挺低的就不拿出来献丑了()

Lab1​

这个lab要求实现tcp字节流抽象的重组部分Reassembler

调的时候还是很恶心的, 非常多的edge case, 建议好好看测试是怎么构造的

写的时间最久的一个lab, 但这里笔记没有多少, 因为Lab1结束到Lab2开始的两个星期干别的去记不清当时的感受了()

还是放个源代码

#include "reassembler.hh"

NJU操作系统(jyy OS)课程笔记-并发部分

· 17 min read
ayanami

lec5 多处理器编程:​

理解程序:状态机模型,我们把一个程序看成一个状态机,程序的状态是{寄存器,内存},而每次取出一条指令、再执行的过程的就是状态迁移到过程。

由这个状态机模型,我们可以有非常多的 trick,例如 debug 单步执行,例如模拟器,例如如果某些指令是“可逆”的,就可以在 debug 的时候反向执行,“时间倒流”(gdb 也提供了这一模式)……

对于并发程序,多处理器模型,我们的直觉告诉我们,可以把这个程序看成是多个状态机,并发的过程就是每次取出一个状态机,执行一步,而所有的状态机有共享的内存(线程模型)…… 这样的模型已经足够复杂,状态数是指数增长的,解决需要考虑所有状态的问题是 NP 完全的。

danger

但更重量级的是,这样的模型是错的!

并发编程的问题:

  1. load/store 的非原子性
  2. 编译器的优化

nginx基础

· 6 min read
ayanami

配置文件

server 虚拟主机, 根据 {listen, server_name}的IP-port或者domain-port对来进行唯一性标识, 可以单项相同, 会匹配另一项转发

location + root, index指定主页等

配置静态页面结束

反向代理: server端请求转发

server {
listen 8001;
server_name any_name;
location / {

CS144 Lecture Notes

· 69 min read
ayanami

Unit 1: Internet and IP​

网络四层模型:application, transport, network, link

7层OSI, 拆app,trans,link为更细的两个

网络的基础和底层是IP, 只有IP model是不可替代的“细腰”,上层的application、transport和下层的link都是可以替换的

application 应用层,smtp, ftp, http, ssh

transport 传输层,tcp, udp, rdp

link 连接层,4G, WiFi, ...

网络连接的几种常见例子:

client-server, BitTorren 一服务器多client的集群, ......

网络 application上 :read/write

Go语言的'大道至简':从Session源码说起

· 11 min read
ayanami

看了一下Go的Session源码——这就是我们的"大道至简"啊(笑)。

Go框架源码的可读性​

觉得Go有一点是好的:由于框架很简陋,所以源码可读性非常高,能够让人对框架在做什么有稍微深一点的印象(因为不做的要自己手做了)。

对比一下:

  • 比Go核心语法更简单的C,底层全是编译器特化的东西和直接对应汇编的hack
  • 比Go核心语法复杂得多的其他语言(C++、Java、Python等),源码里面都大量使用黑魔法,又或者就是套了N层抽象

怪不得Go Web的文档写这么少——鉴定为"具体请看源码"是吧。Go是这样的,只有库没有真正意义的框架。框架只需要轮椅就好了,调库要想的可就多了。

Session的实现原理​

以gorilla/sessions为例,看看Session在Go中是怎么实现的。

基本使用​

package main

import (
"fmt"
"net/http"

"github.com/gorilla/sessions"
)

var sessionStore *sessions.CookieStore

func initSession() {
sessionStore = sessions.NewCookieStore([]byte("secret-key"))
}

func validation(username string, password string) bool {
fmt.Printf("username: %s, password: %s\n", username, password)
return true
}

func login(w http.ResponseWriter, r *http.Request) {
session, err := sessionStore.Get(r, "cookie-name")
if err != nil {
fmt.Println(err)
}
// validation
if validation(r.FormValue("username"), r.FormValue("password")) {
session.Values["authenticated"] = true
session.Save(r, w) // write back to store, == store.Save(r, w, session)
fmt.Fprintf(w, "Login successfully\n")
return
}
http.Error(w, "Authentication failed", http.StatusUnauthorized)
}

func secret(w http.ResponseWriter, r *http.Request) {
authSession, _ := sessionStore.Get(r, "cookie-name")
// 可能是nil, nil时转换会err
auth, err := authSession.Values["authenticated"].(bool)
if !auth || !err {
http.Error(w, "Unauthorized", http.StatusUnauthorized)
return
}
fmt.Fprintln(w, "Secret Area")
}

func logout(w http.ResponseWriter, r *http.Request) {
authSession, _ := sessionStore.Get(r, "cookie-name")
authSession.Values["authenticated"] = false
authSession.Save(r, w)
}

func main() {
initSession()
http.HandleFunc("/login", login)
http.HandleFunc("/secret", secret)
http.HandleFunc("/logout", logout)
http.ListenAndServe(":8080", nil)
}

CookieStore的结构​

一个CookieStore就是一个Option+一堆密钥:

// CookieStore stores sessions using secure cookies.
type CookieStore struct {
Codecs []securecookie.Codec
Options *Options // default configuration
}

type Codec interface {
Encode(name string, value interface{}) (string, error)
Decode(name, value string, dst interface{}) error
}

关键设计:Session与CookieStore的反转​

有意思的是,Cookie/Session本身不存放在CookieStore里面,而是反过来——Session里面存了CookieStore的引用。有了这个指针,Session就可以用CookieStore里面的密钥组进行encode/decode:

// EncodeMulti encodes a cookie value using a group of codecs.
//
// The codecs are tried in order. Multiple codecs are accepted to allow
// key rotation.
//
// On error, may return a MultiError.
func EncodeMulti(name string, value interface{}, codecs ...Codec) (string, error) {
if len(codecs) == 0 {
return "", errNoCodecs
}
var errors MultiError
for _, codec := range codecs {
encoded, err := codec.Encode(name, value)
if err == nil {
return encoded, nil
}
errors = append(errors, err)
}
return "", errors
}

多个Codec的设计是为了支持密钥轮换(key rotation)——新旧密钥并存,编码用新密钥,解码时依次尝试。

Session与Cookie的定义​

type Session struct {
// The ID of the session, generated by stores. It should not be used for
// user data.
ID string
// Values contains the user-data for the session.
Values map[interface{}]interface{}
Options *Options
IsNew bool
store Store
name string
}

// A Cookie represents an HTTP cookie as sent in the Set-Cookie header of an
// HTTP response or the Cookie header of an HTTP request.
//
// See https://tools.ietf.org/html/rfc6265 for details.
type Cookie struct {
Name string
Value string

Path string // optional
Domain string // optional
Expires time.Time // optional
RawExpires string // for reading cookies only

// MaxAge=0 means no 'Max-Age' attribute specified.
// MaxAge<0 means delete cookie now, equivalently 'Max-Age: 0'
// MaxAge>0 means Max-Age attribute present and given in seconds
MaxAge int
Secure bool
HttpOnly bool
SameSite SameSite
Raw string
Unparsed []string // Raw text of unparsed attribute-value pairs
}

可以看到,Session的核心是一个KV存储,有自己的名字,根据名字定位。同时Session有Store的信息。Cookie则是一个单独的KV加上其他的HTTP信息。

读取Session的过程​

func (s *CookieStore) Get(r *http.Request, name string) (*Session, error) {
return GetRegistry(r).Get(s, name)
}

func GetRegistry(r *http.Request) *Registry {
var ctx = r.Context()
registry := ctx.Value(registryKey)
if registry != nil {
return registry.(*Registry)
}
newRegistry := &Registry{
request: r,
sessions: make(map[string]sessionInfo),
}
*r = *r.WithContext(context.WithValue(ctx, registryKey, newRegistry))
return newRegistry
}

这个registryKey就是一个常数0——约定http.Context的Value[0]是session信息(实际上传入的request初始不会带ctx,是框架在处理的时候给这个request加上了context信息)。

如果这个registry已经有东西了(说明被框架处理过,已经有了约定的session信息),就读取;否则新建一个空的registry(可以带多个session),绑定到request的context里面。

然后GetRegistry(r).Get(s, name)里面的Get也就是简单的map[name]有没有东西,没有东西就用store新建一个空的,有就返回。

多个Request如何共享Session​

同个host发出的多个request如何共享一个session呢?我们得先看Save:

// Save adds a single session to the response.
func (s *CookieStore) Save(r *http.Request, w http.ResponseWriter,
session *Session) error {
encoded, err := securecookie.EncodeMulti(session.Name(), session.Values,
s.Codecs...)
if err != nil {
return err
}
http.SetCookie(w, NewCookie(session.Name(), encoded, session.Options))
return nil
}

可以看到,Save将创建的session作为Set-Cookie返回给了浏览器,新建的cookie name和session的name相同,值为session encode的结果。

也就是说,原始的session信息不需要继续保留,只需要根据store里面的密钥decode cookie就行。Registry的Get也体现了这一点:

func (s *Registry) Get(store Store, name string) (session *Session, err error) {
if !isCookieNameValid(name) {
return nil, fmt.Errorf("sessions: invalid character in cookie name: %s", name)
}
if info, ok := s.sessions[name]; ok {
session, err = info.s, info.e
} else {
session, err = store.New(s.request, name)
session.name = name
s.sessions[name] = sessionInfo{s: session, e: err}
}
session.store = store
return
}

新建session时,如果请求中带了对应的cookie,就decode出来;否则新建一个空的session:

func (s *CookieStore) New(r *http.Request, name string) (*Session, error) {
session := NewSession(s, name)
opts := *s.Options
session.Options = &opts
session.IsNew = true
var err error
if c, errCookie := r.Cookie(name); errCookie == nil {
err = securecookie.DecodeMulti(name, c.Value, &session.Values,
s.Codecs...)
if err == nil {
session.IsNew = false
}
}
return session, err
}

CookieStore全流程​

我在各种struct里面转了半天,一直在找它session存哪了,最后才意识到是类似JWT的方法。整理一下CookieStore全流程:

  1. 建立一个密钥组的CookieStore cs
  2. 第一个request,创建一个{request: []session}的map(Registry),包回request的context之中,Get(r, name)根据name创建session,其中值为使用cs encode后的结果
  3. 之后,如果在原始request上继续Get,会直接从request上面拿
  4. 第一个request response的时候,从request的context里面提取出registry,然后返回Set-Cookie让浏览器设置cookie为{name: session.name(), value: encode后的session}
  5. 后续request会带上cookie,然后使用cs即可进行解码,得到相关信息

对外暴露的API为:

func sessions.NewCookieStore(keyPairs ...[]byte) *sessions.CookieStore
func (s *sessions.CookieStore) Get(r *http.Request, name string) (*sessions.Session, error)
func (s *sessions.Session) Save(r *http.Request, w http.ResponseWriter) error

对比Java Spring:因为Go的net/http作为基础库,势必要将req/res的API暴露出来,作为外部库引入的session不能有强侵入性,故而必须在session相关的API之中保留req、res和name,实际上要求用户对session/cookie的流程有一定认知。而Spring因为已经接管了从Java Object到HTTP req/res的转换处理过程,故而可以进一步接管Session的创立,使用IoC和注入的方法输入session,用户不需要对session底层实现有任何认知,只需要把它当成一个KV存储就行:

@GetMapping("/")
public String function(HttpSession session) // 会自动注入session

实际上达到了更加解耦的效果,也更加"轮椅"。

如果想要在服务器端持久化会话数据,或者在分布式系统中共享会话数据,gorilla/sessions提供了FilesystemStore来使用文件系统存储session,对外暴露的API是相同的。

不过确实有助于了解底层实现——有种原始的美感。

架构基础知识​

今天了解了一些架构的基础知识,还挺有意思的。翻来覆去讲的高可用、高并发、高拓展,各种中间件似乎都是把某个领域特定的东西(比如搜索的倒排索引)相关的功能做好,再加上切片和分配、主从机制、分布式节点管理,就变成"三高"了。Elasticsearch、Kafka、Redis似乎都是这样。

关于语言选择​

感觉个人全栈的话,TypeScript可能会是一个好选择?tRPC、Prisma、Next.js、Socket.IO,各种基础库好全,同一套配置也非常简单,API设计简直就是怎么让程序员舒服怎么来。

但国内后端的话估计还得滚回去看Java。

性能迷思与软件工程哲学

· 5 min read
ayanami

越来越感觉"性能"这两个字在学校的语境下很扯淡。

没有场景的性能讨论毫无意义​

没有业务场景和具体的工作负载,乃至对比的代码进行的优化程度,单说一个"性能好"最无聊了——等效于没有任何信息。

当然是抽象层越少的性能上限越高,但上限高不等于我能写得高,更不等于我能在给定的时间和可能的拓展性要求下写得高——更不提大部分时候我们完全就是缺乏对性能的先验知识,你说A语言比B语言快,快多少,A的相关业务库又比B的快多少——说不定B语言慢但B框架/类库给力,反倒在这个领域完全干死了A语言,这个快的意义是什么?瓶颈在IO还是计算还是网络还是其他?

协程的启示​

写一些学校作业的时候总有一些奇奇怪怪的优化要求(或者自己给自己加的某种约束),但就像协程的诞生一样,我总得先知道哪里才是bottleneck,才能做出有效的抽象。

举个例子:你说这部分的优化加速能让他支持某个场景,例如给单机MySQL加Redis能突破1w QPS的瓶颈,我虽然没有自己实践过,但大概知道了为什么要这么做,以及什么场景下需要这么做;但你就说例如C++写Socket比Node.js快100倍,那我除了"嗯嗯"之外也不知道说什么——感觉你说了一句废话。

代码美学才是第一生产力​

诚然架构的迁移需要的精力是巨大的,但这不是过早优化的理由,我认为软件工程的意义上而言,代码的美学才是第一生产力。

我们有那么多"优雅"的成功案例:TypeScript、PyTorch、Spring……却从来只讲如何 Build A Toy From Scratch,不讲 How to Design a Real Project。

关于教学的思考​

因为我们只学了/教过/传统是XXX语言,所以就是指定使用相关的东西进行教学和作业也是非常令人不爽的一个逻辑。就像system教学之中的某些东西一样,重要的不是结果,是过程——而在web课之类application性质课的上却完全忽略了这一点。

课程的课时数也完全不能成为某种借口或理由,将精力放在讲解"茴香豆的四种写法"上是极其无聊的——那么多的文档和视频呢,在入门阶段的学生更需要的是一项技术发展的脉络和思考。退一步说,为什么不能给点课外阅读材料?

对着每一个API讲是不屑于讲的"培训班"模式,那扣各种奇怪的地方的API就不是"培训班"模式了?为什么会有这种越是low level越是高贵的感觉?

个人认为,low level是本事,能够把low level的东西包装成high level的东西——更进一步,make doing the right thing easy,写正确的东西容易,写错误的东西难——似乎更是重要。在这方面上,学校的培养似乎是完全缺失的。

ORM的启示​

看Prisma文档花了超级大的篇幅在讲清楚ORM设计的脉络有感:上了一学期Web课,对ORM除了名词之外还是啥都不知道,也蛮搞笑的。

推荐阅读:

Django_mosh

· 15 min read
ayanami

Django mosh

shell django-admin

django-admin startproject <proj name> .

run server

python manage.py runserver

app 可以通过 proj 初始 settings.py 集成

xv6book Notes(C1-4)

· 91 min read
ayanami

一些细节和思考:

Q: wait for reading the source code and thinking

A: after reading the source code and thinking

Go,Gin学习

· 20 min read
Tags:
ayanami

Go & Gin & Gorm 学习​

Go​

Learn go by test

基本语法​

package:类似namespace或者module

循环

func Repeat(character string) string {
var repeat string

godis源码阅读

· 33 min read
ayanami

tcp​

echo​

一个优雅超时关闭的方法

// WaitWithTimeout blocks until the WaitGroup counter is zero or timeout
// returns true if timeout
func (w *Wait) WaitWithTimeout(timeout time.Duration) bool {
c := make(chan struct{}, 1)
go func() {
defer close(c)
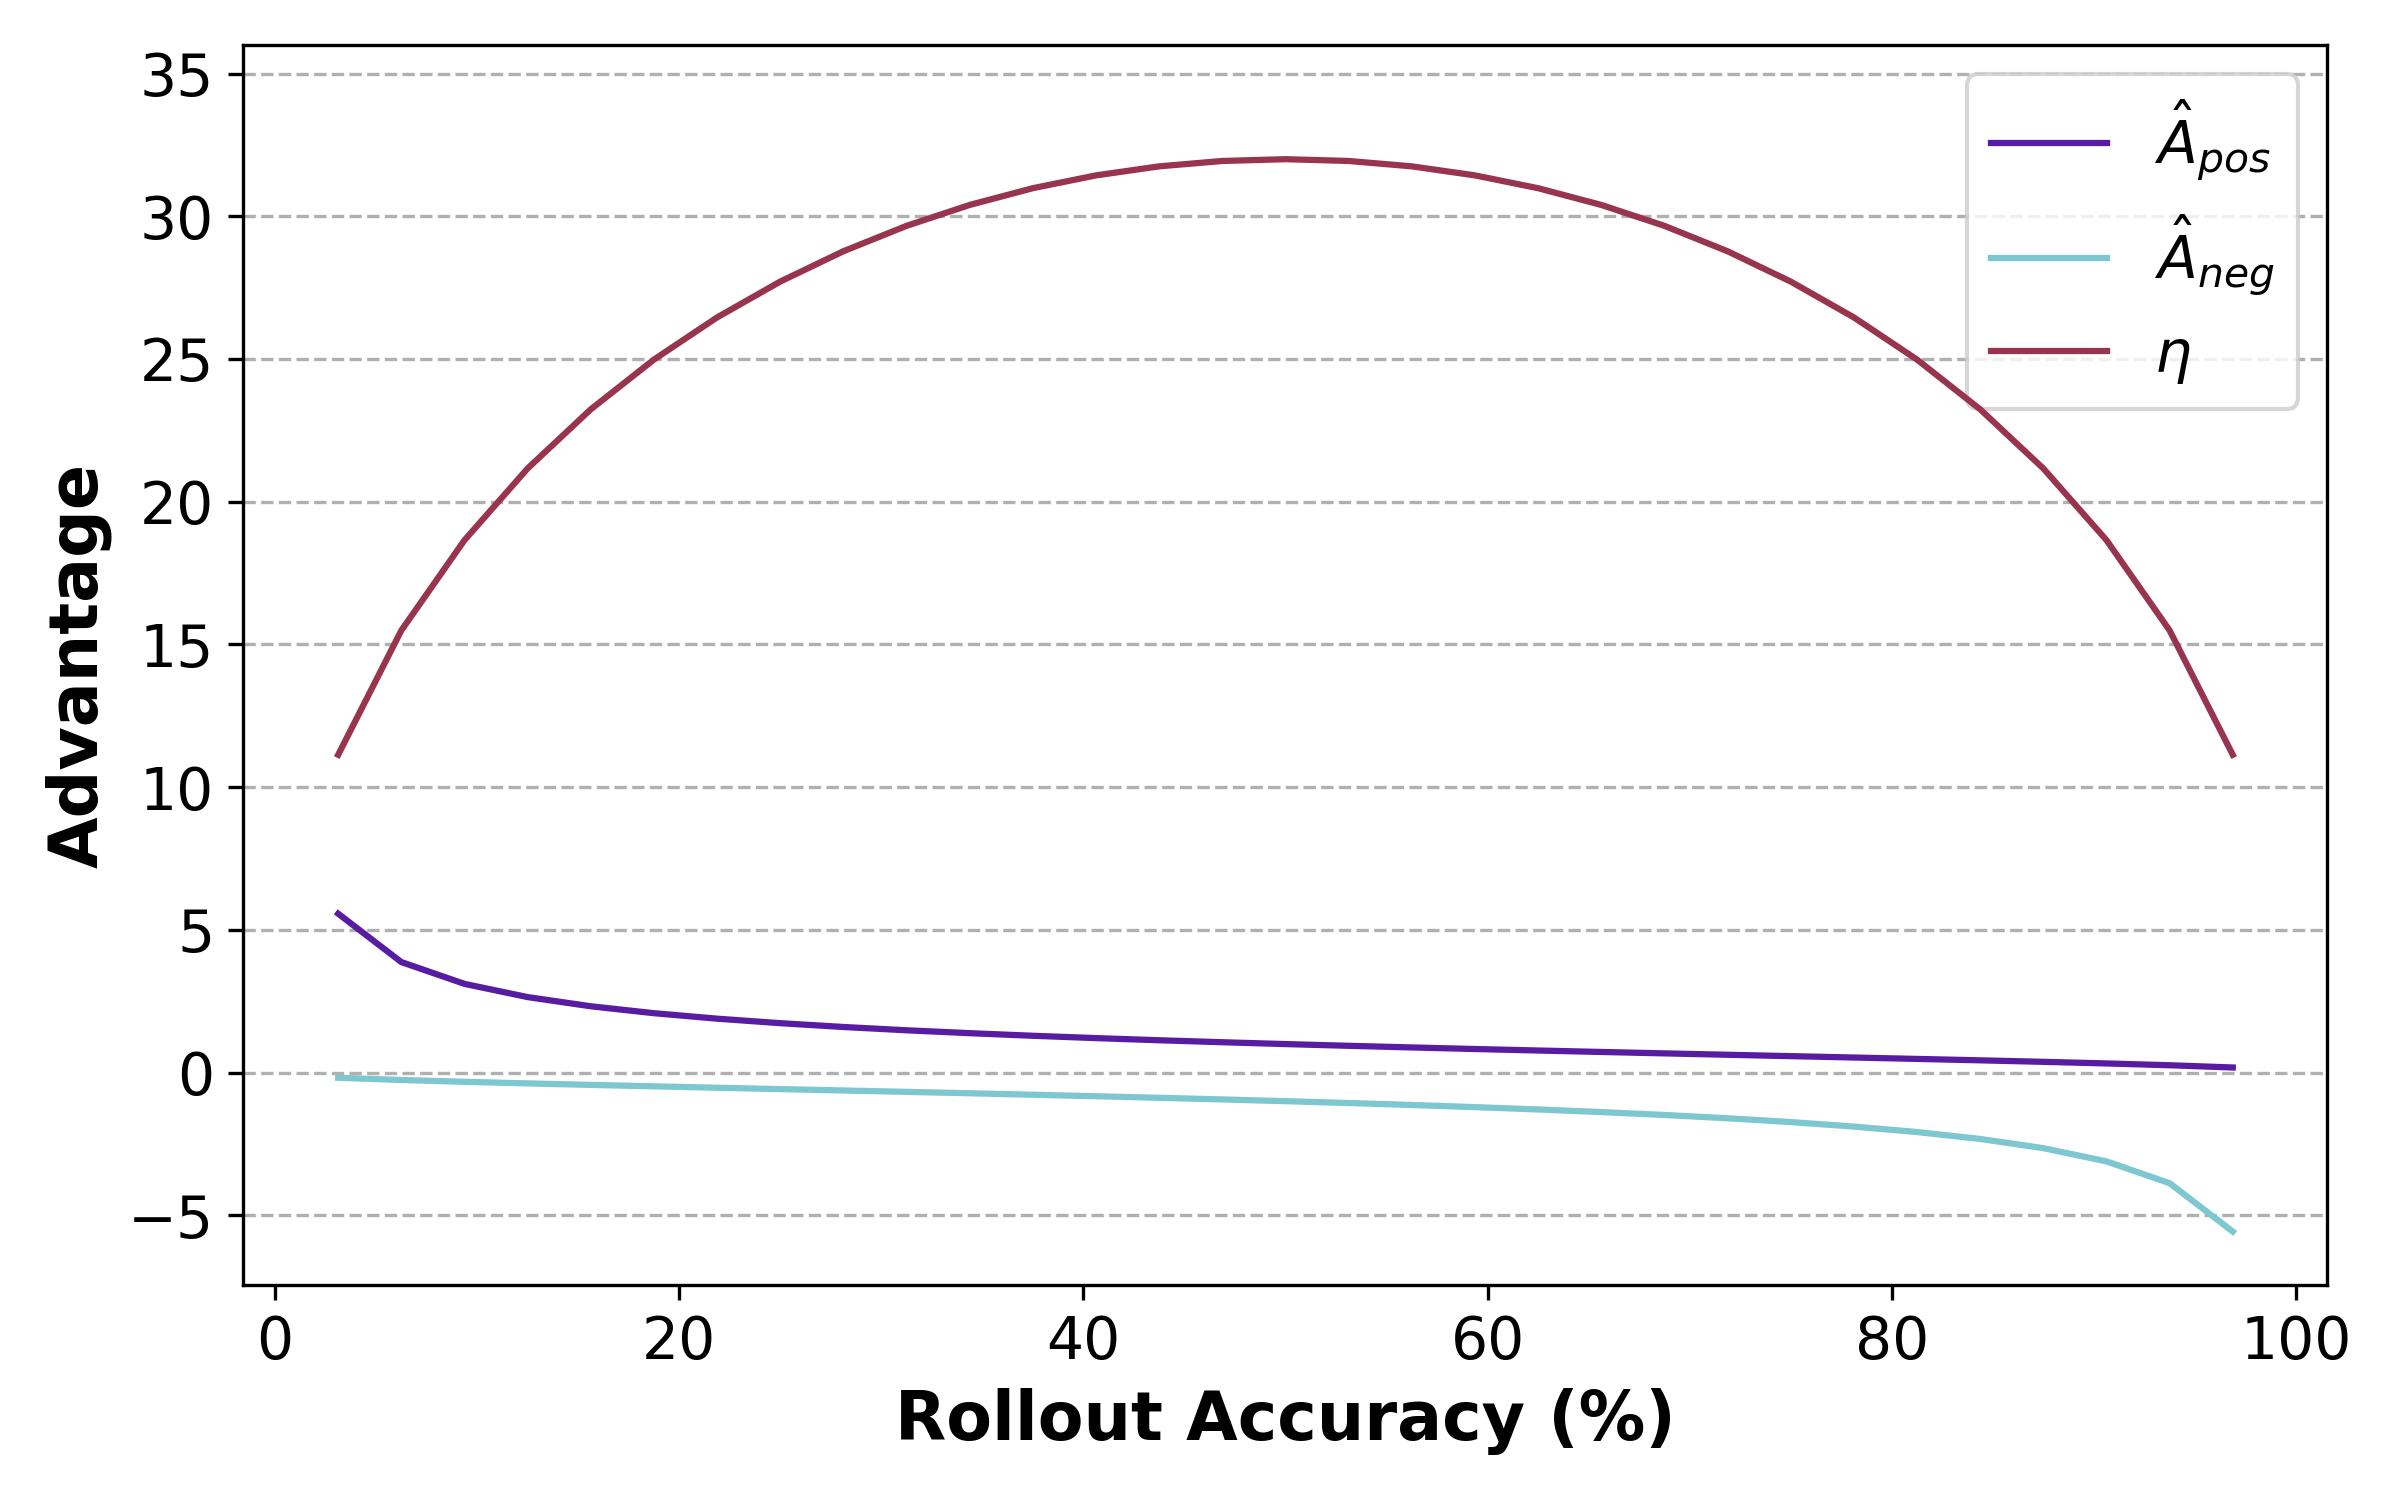
hibernate&jpa

· 13 min read
ayanami

jdbc: java database connectivity

jdbc 要先加载驱动,由各个数据库实现

jpa 通过 orm 框架生成 sql,再经过 jdbc 操作数据库

getBean 方法:

  • getBean 是 ApplicationContext 接口中的一个方法,用于从 Spring 的 IoC 容器中显式地获取 Bean 实例。

  • 它通常在需要手动获取 Bean 时使用,比如在非 Spring 管理的类中或者在某些特定的场景下,你想要直接从容器中获取 Bean 而不是通过注入。

  • 使用 getBean 方法时,你需要知道 Bean 的名称或类型,并在调用时指定这些信息。

  • 示例代码:

linking 复习

· 17 min read
Tags:
ayanami

linking 复习

No linker Problems​

• efficiency: small change requires complete recompilation

• modularity: hard to share common functions (e.g. printf)
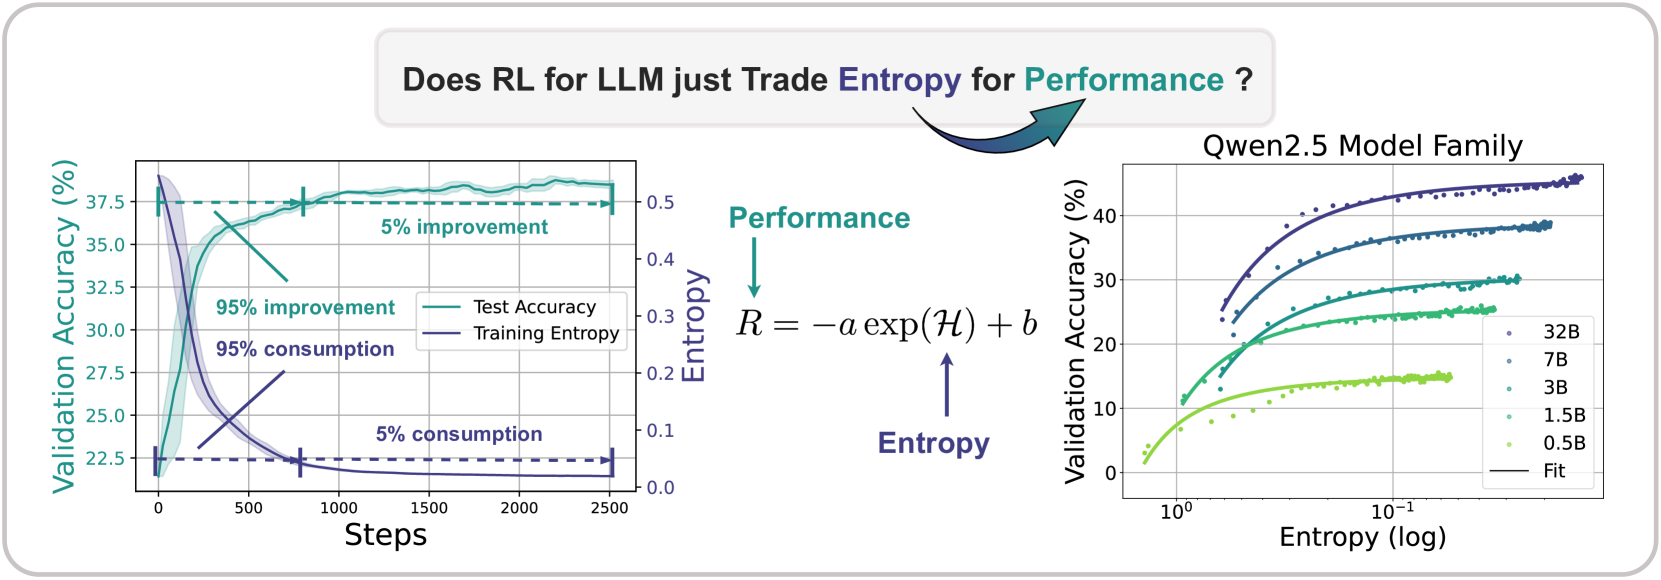
seperate compilation: separately compiled relocatable object files

reloc object files -> executable object file

What is linker​

  • Linking is the process of: collecting and combining various pieces of code and data into a single executable file

  • Executable file: Can be loaded (copied) into memory and executed

ts基础

· 6 min read
ayanami

ts: 带静态类型的 js

配置 ts​

tsc --init

tsconfig.json

重要配置

{

"compilerOptions": {

"target": "es2016", // 指定编译器

react practice:mosh gamehub

· 66 min read
ayanami

观前提示:

  1. 默认读者有基础的 js, ts, html 基础, 其中 html 和 js 在MDN Web Docs上看入门教程即可,ts 可以看mosh 的视频或者 google 一下 typescript tutorial 即可;
  2. 本人水平有限,错漏和不足之处敬请谅解
  3. 本笔记对应的视频: CodeWithMosh - React 18 for Beginners对应初级部分;code with mosh - React: Intermediate Topics对应进阶部分;相关代码可以在 github 找到。

gamehub: react + ts + ...

初级部分​

前端部分​

一切的开始:初识 React​

浅入理解断点和调试器

· 13 min read
Tags:
ayanami

浅入理解断点和调试器​

主要参考1,2两篇文章

在写知识之前,不如先问自己几个问题:

  • debugger 的实现原理是什么?
  • 断点(breakpoint)和监视点(watchpoint)的区别?
  • 断点有哪些实现方法?具体到 gdb 之中,它是怎么实现的?

debugger 的最基本原理,就是这样的代码

int main(int argc, char** argv)

黑马点评(速通版)

· 39 min read
ayanami

个人环境 Ubuntu 24.04

项目配置​

  • repo: 搜一搜就行 https://github.com/cs001020/hmdp?tab=readme-ov-file

  • idea config: 降java版本到11就能不报错

  • redis, mysql: 搜索即可 systemd 启动

  • nginx 稍微复杂一点, 给的是win下的nginx, 配完systemd之后,用他的nginx.conf替换/etc/nginx/nginx.conf(记得备份) 然后修改

        # 指定前端项目所在的位置
location / {
root /home/ayanami/www/hmdp/html/hmdp; # 修改此处, 改为${下载的nginx文件夹原来位置}/hmdp/html/hmdp

js基础

· 15 min read
ayanami

js的数据​

不区分整数和浮点数 3 / 2 === 1.5

支持进制和科学计数

console.log(0b111110111); // 503
console.log(0o767); // 503
console.log(0x1f7); // 503
console.log(5.03e2); // 503

11-14-11-26学习双周记

· 17 min read
Tags:
ayanami

11.14-11.26 学习双周记:

最近事务稍多,且更多时间花在了写代码上且略摆,故学习的知识型内容较少

完成了 pa1 和 081 的 lab1


小知识 get:​

搜索引擎的小技巧:英文符号​

搜索引擎对符号的支持是很差的,甚至会被识别成通配符之类

正确的搜索符号的姿势是使用英文代替符号

e.g.(google)可以搜搜对比一下